FlashAttention到底快在哪
FlashAttention不是新的注意力公式,而是一次围绕GPU内存层次重写的精确注意力实现。本文从Tiling、Online Softmax、核融合和反向重计算出发,解释它为什么能在不改变结果的前提下降低显存读写,并梳理FlashAttention 2及工程接入时的边界。
FlashAttention 到底快在哪:从 Online Softmax 到 CUDA Kernel 的一次算清
FlashAttention 的核心变化,不是发明了一个更省计算量的注意力公式,而是重新安排了注意力计算过程中数据在 GPU 各级内存之间的流动方式。
截至 2026 年 9 月,FlashAttention 已经从一个面向研究代码的 CUDA 优化,变成 LLM 训练、长上下文微调和高吞吐推理中的基础组件。它被整合进 PyTorch 生态、主流 Transformer 实现和多个训练框架,但很多开发者仍然把它简单理解成“把 Attention 换成一个更快的函数”。这个理解不够准确:FlashAttention 的本质是 一种 IO 感知的精确注意力实现,它在不近似注意力结果的前提下,减少 GPU 高带宽显存(HBM)与片上高速存储之间的数据搬运。
它解决的是显存访问和中间矩阵存储问题,不是把稠密注意力的理论计算复杂度从 O(N²) 变成 O(N)。序列长度 N 继续增长时,QKᵀ 和 PV 的主要 FLOPs 仍然是平方级;FlashAttention 做的是让这些计算少绕路、更少落盘,因此在真实 GPU 上更快、更省显存。
一、标准 Attention 的瓶颈,往往不是乘法本身
标准缩放点积注意力可以写成:
S = QKᵀ / √d
P = softmax(S)
O = PV
其中 Q、K、V 的形状通常为 (B, H, N, D),B 是 batch size,H 是注意力头数,N 是序列长度,D 是 head dimension。S 是形状为 (N, N) 的注意力分数矩阵,P 是经过 softmax 后的概率矩阵。
标准实现的问题,是需要把 S 或 P 这样的 N×N 中间结果写入 HBM。序列长度从 2,048 增长到 32,768 时,矩阵边长增长 16 倍,单个注意力头的中间矩阵元素数量增长 256 倍。即使使用半精度,显存压力也会很快超过计算本身。
例如,单个 batch、单个 head、序列长度 N=16,384 时,注意力矩阵有约 268 million 个元素。若以 FP16 存储,仅一个矩阵就约占 512 MiB;训练还需要考虑反向传播保存的中间状态、多个 head、多个层以及工作区。实际框架会采用算子融合、检查点或其他优化,但“先生成完整注意力矩阵再继续计算”的数据流天然不适合长上下文。
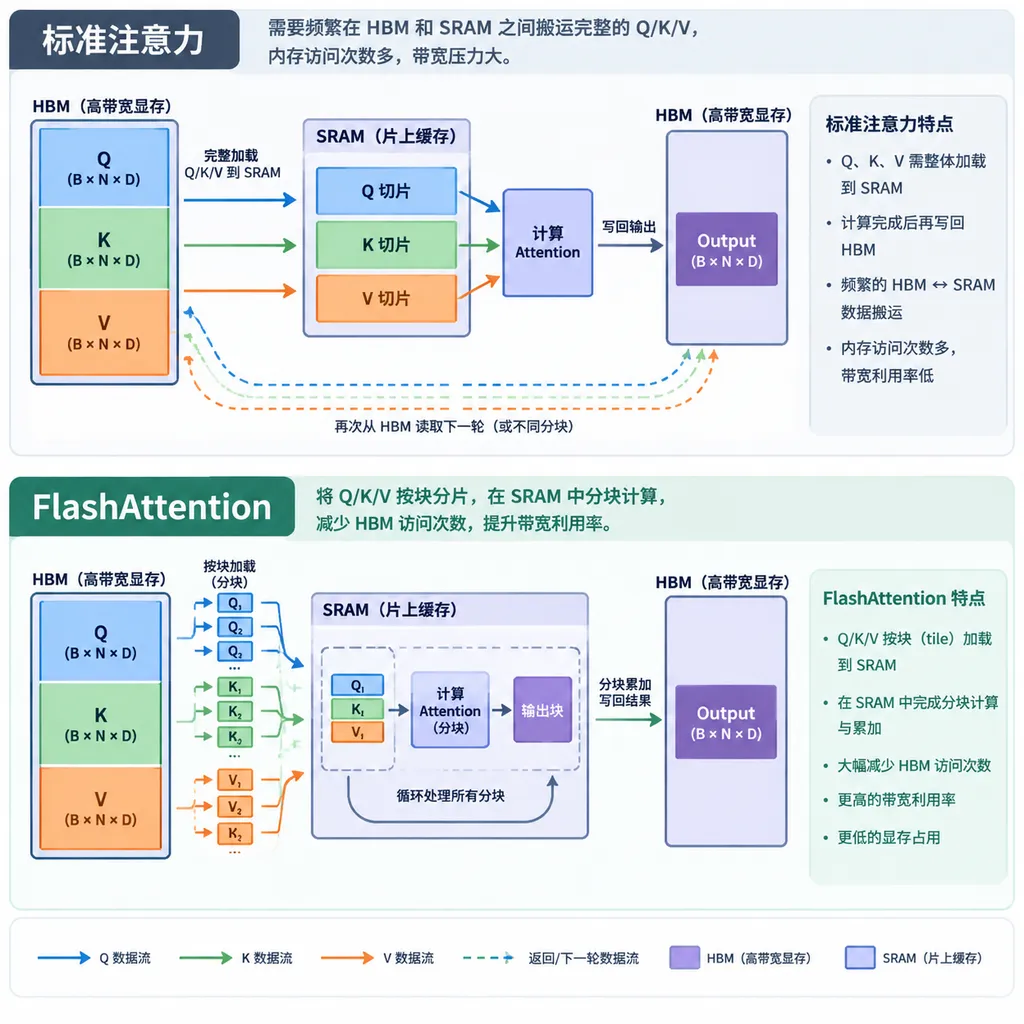
标准 Attention 的主要问题,是中间矩阵反复在 HBM 与计算单元之间读写。HBM 容量大、带宽高,但延迟和能耗都显著高于 GPU SM 内的寄存器与共享内存;当一个算子需要频繁写入并重新读取 N×N 矩阵时,GPU 可能不是算力不够,而是在等待数据。
因此,FlashAttention 的判断很直接:不要把完整的注意力矩阵写到 HBM,尽量让 Q、K、V 的小块留在片上存储中,完成局部矩阵乘法、softmax 和输出累加后再丢弃。
二、IO-Awareness:把慢内存访问从主路径上拿掉
IO-Awareness 是 FlashAttention 的设计原则,它要求算法同时考虑算术运算和不同存储层级之间的数据传输成本。
现代 GPU 的内存大致可以分成三层:
- HBM 或显存:容量大,适合保存模型参数和长序列数据,但访问相对昂贵;
- Shared Memory,也就是 SRAM:位于 SM 附近,容量小但访问速度快,适合缓存分块后的 Q、K、V;
- Registers:每个线程私有,容量更小、速度最快,适合保存局部累加器和 softmax 状态。
普通实现通常把矩阵乘法、缩放、mask、softmax、概率矩阵乘法拆成多个 Kernel。每个 Kernel 结束时,中间结果可能被写回 HBM;下一个 Kernel 启动后,再把这些结果读回来。这样的流程在代码层面清晰,却产生大量 global memory traffic 和 kernel launch 开销。
FlashAttention 使用 Tiling,也就是分块计算,把 Q 按行、K/V 按列切成适合片上存储的 tile。一个典型流程是:先从 HBM 载入一块 Q,再循环载入 K 和 V 的块;Q tile 与 K tile 在 SRAM 或寄存器中计算分数,立即完成局部 softmax 和 V 的加权累加,最后只将输出 O 写回 HBM。完整的 S 和 P 从未作为 N×N 矩阵落地。
这里的“减少显存占用”并不意味着所有计算都变成线性复杂度,而是把需要长期保存的 N² 中间状态去掉了。对于训练来说,这一点尤其重要,因为显存从“保存完整注意力矩阵”转为“保存 Q、K、V 以及少量辅助统计量”,峰值空间大幅下降。
三、分块之后,Softmax 为什么仍然能算对
Online Softmax 是 FlashAttention 用来解决分块归一化问题的增量算法。它在扫描分数块时,维护当前最大值和指数和,因此不需要先看到整行的全部元素。
Softmax 的难点在于,某一行的输出需要全局最大值:
softmax(xᵢ) = exp(xᵢ - m) / Σⱼ exp(xⱼ - m)
其中 m = maxⱼ(xⱼ)
如果 K 被拆成多个块,处理第一个块时并不知道后面的块是否包含更大的分数。直接对每个块分别做 softmax,再把结果拼起来,会得到错误的归一化结果。
FlashAttention 对每一行维护两个状态:当前最大值 m,以及相对于该最大值计算的指数和 l。读入新的分数块后,先计算新块最大值 m_block,再更新全局状态:
m_new = max(m_old, m_block)
l_new = l_old * exp(m_old - m_new)
        + l_block * exp(m_block - m_new)
其中 l_old 和 l_block 分别是旧数据与当前数据在各自最大值基准下的指数和。只要最大值发生变化,旧的累积量就通过 exp(m_old - m_new) 重新缩放。这个修正因子是关键:它保证不同块的局部统计量能够合并成与整行 Safe Softmax 等价的结果。
同时,输出不能只累加未归一化的 V。实现通常会维护一个经过相同尺度调整的输出累加器,最终再除以 l_new;也可以使用 LogSumExp 形式,把归一化所需的信息压缩成每行少量 FP32 状态。换句话说,FlashAttention 没有跳过 softmax,而是把 softmax 从一个必须依赖完整矩阵的操作,改写成了可增量合并的状态更新。
这也是它与近似注意力方法的根本区别。稀疏注意力、低秩注意力或线性注意力通常改变了注意力表达式,可能牺牲一部分精度或适用范围;FlashAttention 仍然计算原始稠密注意力,只是改变了执行顺序和内存落点。
四、CUDA Kernel 到底做了什么
FlashAttention 的 CUDA Kernel 是把多个原本分离的步骤融合到一次 GPU 执行路径中。下面是便于理解的伪代码,不对应某个具体版本的源码:
for each Q_tile assigned to a thread block:
    load Q_tile from HBM to SRAM/registers
    initialize m, l, and output_accumulator

    for each K_tile, V_tile:
        load K_tile and V_tile from HBM to SRAM
        scores = Q_tile @ transpose(K_tile)
        apply scale and causal/attention mask

        update online-softmax statistics m and l
        output_accumulator = rescale(output_accumulator)
        output_accumulator += softmax_tile(scores) @ V_tile

    normalize output_accumulator
    store output tile to HBM
第一,Kernel 融合减少了中间结果回写。缩放、mask、softmax 和乘以 V 被放在同一条执行路径中,分数只在寄存器或共享内存中短暂停留。
第二,Tiling 让数据复用成为可能。一块 Q 可以与多块 K/V 配对计算;一块 K/V 也能服务于多个线程的局部工作。相比把完整矩阵交给通用算子,专用 Kernel 更容易控制数据何时加载、何时复用、何时释放。
第三,Warp-level tiling 和 Tensor Core 负责把矩阵乘法做满。GPU 并不是一个单一的大核心,而是由许多 SM、Warp 和线程组成。Kernel 需要把 tile 划分到 Warp,再进一步映射到 Tensor Core 支持的矩阵乘法指令上,同时平衡寄存器占用、共享内存容量和并行度。
第四,Kernel launch 数量减少也会带来收益。单次 launch 的固定开销在大模型训练中通常不是最大头,但当序列较短、batch 较小或算子链较碎时,融合多个步骤能够明显改善端到端延迟。
不过,不能把“用了 Tensor Core”当作 FlashAttention 的全部。普通高性能 GEMM 同样可以使用 Tensor Core;FlashAttention 的差异在于,它同时重写了注意力的数据流、softmax 归一化和中间结果生命周期。
五、FlashAttention 1 与 FlashAttention 2 的差别
FlashAttention 2 是在第一代 IO 优化基础上,进一步重排并行策略和工作分配的实现。它的目标不是重新定义算法,而是让 GPU 的计算资源更充分地并行工作。
| 版本 | 主要优化方向 | 典型收益来源 | 需要注意的限制 | |---|---|---|---| | FlashAttention 1 | Tiling、Online Softmax、避免写回完整注意力矩阵 | 减少 HBM 读写和中间显存 | 对并行划分和硬件支持有要求 | | FlashAttention 2 | 改进 work partition、减少非矩阵乘法开销、提升 Warp/SM 利用率 | 更高 GPU 利用率和更少同步 | 仍受 head dimension、dtype、GPU 架构影响 | | FlashAttention 3 | 面向更新一代 GPU 的异步流水、Tensor Core 利用和低精度路径优化 | 重叠数据搬运与计算、提高硬件吞吐 | 版本、硬件和精度支持更敏感 |
第一代实现中,一些非 GEMM 操作和线程间同步仍然可能成为瓶颈。FlashAttention 2 重新设计了线程块、Warp 与序列维度之间的切分,尽量让更多时间花在 Tensor Core 矩阵乘法上,同时减少不同 Warp 之间为共享输出而产生的通信。
这带来一个重要判断:FlashAttention 2 的提升不是简单地把 FlashAttention 1 的代码“再编译一次”。同样的数学公式,在不同 GPU 架构、不同 head dimension、不同 batch 和序列长度下,最佳并行切分并不相同。性能测试必须使用目标模型的真实形状,而不是只看一个官方 benchmark。
FlashAttention 3 则更强调新一代 GPU 上的异步执行、数据搬运与计算重叠,以及 FP8 等低精度路径。它并不意味着所有任务都能自动获得同等比例的提升;如果模型受限于显存容量、PCIe 传输、KV Cache 访问或小 batch 延迟,升级 Kernel 版本未必能解决主要瓶颈。
六、训练时为什么还要“重计算”
FlashAttention 的反向传播通常结合重计算(recomputation),用计算换显存。标准训练实现可能保存完整的注意力概率矩阵 P,以便反向阶段直接使用;FlashAttention 不保存这个 N×N 矩阵,而是保存必要的输入和每行统计量,反向时重新计算局部分数与 softmax。
重计算听起来像是增加了 FLOPs,但它避免了巨大的 HBM 读写和显存占用。在现代 GPU 上,很多深度学习工作负载并不纯粹受算力限制,减少内存流量后,额外计算可能是划算的交换。
这也是为什么 FlashAttention 的速度收益不能只从理论 FLOPs 判断。两个实现即使执行相近数量的乘加,也可能因为一个反复读写 HBM、另一个主要在片上完成,而产生显著不同的实际耗时。
七、开发者接入时,最容易踩的坑
FlashAttention 的性能收益取决于输入形状、数据类型和硬件条件,不是安装包后所有 Attention 都会自动加速。工程中至少要检查以下事项。
1. 输入布局必须匹配
不同库的接口布局并不完全一致。常见的 packed QKV 形式是 (batch, seqlen, 3, nheads, headdim),拆开的 Q、K、V 则可能使用 (batch, seqlen, nheads, headdim)。如果为了适配接口频繁转置、复制或调用 contiguous,数据搬运成本可能抵消 Kernel 本身的收益。
2. dtype 与 head dimension 会影响路径
FP16 和 BF16 通常是主流高性能路径,FP32 是否支持、是否足够快则要看具体实现。head dimension 常见为 64、80、96、128 等,但并非所有版本对任意维度都同样友好。较大的 head dimension 会提高寄存器和共享内存压力,可能降低 occupancy。
3. causal mask 不是普通 mask 的简单开关
自回归模型需要 causal attention,位置 i 不能读取未来位置 j>i。高效实现会在 tile 内直接跳过无效区域,而不是先构造一个完整的 N×N mask 再相乘。若上层代码先显式生成大 mask,可能重新引入本来要消除的显存压力。
4. 变长序列要关注 padding 浪费
一个 batch 内样本长度差异很大时,统一 padding 会让 Kernel 对大量无效 token 做计算。支持 varlen 或 unpadding 的实现可以减少这类浪费,但会引入 prefix sum、索引管理和调度复杂度。对在线推理而言,短请求与长请求混合时,动态批处理策略同样重要。
5. 推理瓶颈可能已经转移到 KV Cache
在长文本生成阶段,单 token 解码通常不是训练时的完整 Q/K/V 计算。Query 可能只有一个或少数几个 token,却要访问越来越长的 KV Cache。此时 FlashAttention 仍然有帮助,但真正的优化重点可能是 Flash-Decoding、KV Cache 布局、分页管理、GQA/MQA 或跨卡通信。不能把训练阶段的 benchmark 直接套到 decode 阶段。
八、它和其他高效注意力方案有什么不同
FlashAttention、稀疏注意力、线性注意力和低秩注意力解决的是不同层面的问题。
| 方法 | 是否改变精确注意力结果 | 主要优化对象 | 长序列理论趋势 | 适用判断 | |---|---|---|---|---| | FlashAttention | 否,目标是精确计算 | HBM/SRAM IO、Kernel 融合 | 稠密注意力 FLOPs 仍为 O(N²) | 想保留标准注意力行为并提升 GPU 实测效率 | | 稀疏注意力 | 是,限制可见连接 | 注意力连接数量 | 可降至低于 O(N²),取决于稀疏模式 | 任务允许局部或结构化依赖 | | 线性注意力 | 是,改变计算分解方式 | 计算顺序和核函数 | 某些形式接近 O(N) | 能接受表达能力和训练稳定性差异 | | 低秩/近似注意力 | 是,近似注意力矩阵 | 矩阵秩或采样 | 低于稠密注意力 | 更看重超长上下文成本 |
FlashAttention 的优势是兼容性强:模型仍然使用熟悉的 softmax attention,不需要重新训练一套不同的注意力机制。但它也有边界:当 N 极长到稠密 FLOPs 本身成为主导时,单纯减少 IO 不能消除平方级计算;当硬件不支持合适的半精度矩阵指令时,收益也会变小。
九、如何正确评估 FlashAttention 是否真的有效
评估 FlashAttention,应该同时测显存峰值、Kernel 时间和端到端吞吐,而不是只看一次函数调用的耗时。建议至少覆盖以下维度:
- 序列长度:1K、2K、4K、8K、16K,必要时加入模型实际支持的更长长度;
- batch size:小 batch 延迟与大 batch 吞吐分别测试;
- head dimension:与目标模型完全一致;
- dtype:FP16、BF16,以及训练中实际使用的混合精度配置;
- causal 与 non-causal:两者的有效 tile 区域不同;
- 训练与推理:尤其区分 prefill 和 decode;
- 端到端指标:tokens/s、step time、显存峰值和稳定性。
理论上,“2 到 4 倍加速”是很多资料中常见的范围,但它不是保证值。实际数字取决于 GPU 型号、序列长度、算子融合程度、编译版本、输入布局和上层框架。更稳妥的表述是:FlashAttention 在内存访问占主导的场景中通常收益明显;当矩阵乘法已经把 Tensor Core 吃满,或工作负载太小导致启动开销占主导时,收益可能有限。
工程上还要确认数值误差和回归结果。FlashAttention 追求与标准注意力数学等价,但浮点运算顺序、累加精度和不同硬件指令会导致微小差异。对训练任务,应观察 loss 曲线、梯度是否出现 NaN、长序列边界位置是否稳定,而不应要求每一个浮点元素都按 bit 完全一致。
十、结论:真正值得记住的不是“快”,而是数据流
FlashAttention 的关键机制可以压缩成四句话:
- Tiling 把 Q、K、V 切成能放入片上存储的块;
- Online Softmax 让分块计算仍能得到全局等价的归一化结果;
- Fused CUDA Kernel 在一次执行路径中完成分数、mask、softmax、累加和输出;
- Recomputation 用少量重复计算换掉完整注意力矩阵的保存。
它最有价值的地方,是把“算法公式”和“GPU 内存层次”放在同一个设计问题里考虑。对于大模型开发者,这种思路比记住某个函数名更重要:任何看似简单的算子,只要中间结果很大、访问频繁,就值得问一句——数据是否真的需要写回 HBM?能不能在片上完成更多工作?
我的判断是,FlashAttention 已经不是可有可无的微优化,而是标准 Transformer 工程栈中的基础设施。但它也不是长上下文的万能钥匙:它降低 IO 和显存压力,却没有消除稠密注意力的 O(N²) 计算;它能优化 prefill,却不一定解决 decode 的 KV Cache 瓶颈;它能减少单层开销,却无法替代合理的 batch、并行和缓存策略。
如果你的模型使用标准稠密注意力、运行在支持高效半精度矩阵计算的 NVIDIA GPU 上,并且序列长度已经让显存或 Attention Kernel 成为瓶颈,那么优先采用成熟的 FlashAttention 实现通常是高性价比选择。接下来再根据 profiling 结果决定是否需要 varlen、KV Cache 优化、Flash-Decoding、稀疏注意力或更激进的近似方案。
参考来源
- FlashAttention 官方 GitHub 仓库:查看不同版本实现、安装说明、支持的硬件与基准测试。
- FlashAttention 论文与项目资料:由 Tri Dao 等作者维护,适合理解 IO 感知注意力的工程实现。
- 知乎:Flash Attention——加速计算、节省显存、IO 感知的精确注意力:从标准 Attention 的矩阵计算流程切入,解释 FlashAttention 的基本动机。
- Hugging Face Transformers 文档:了解主流模型框架中 Attention Backend、SDPA 与 FlashAttention 的集成方式。
- Online Normalizer Calculation for Softmax:Online Softmax 所依赖的增量归一化思想来源,可结合 FlashAttention 实现理解。