AI智能体正在淹没社交媒体
AI 智能体已经不满足于帮人写帖,而是开始自行注册、发帖和互动。Timmy、Ren、Jackie 等账号制造的大量低质量内容,正在把社交平台从信息流变成“机器对机器”的噪音场。
AI 智能体正在淹没社交媒体:当机器开始互相发帖
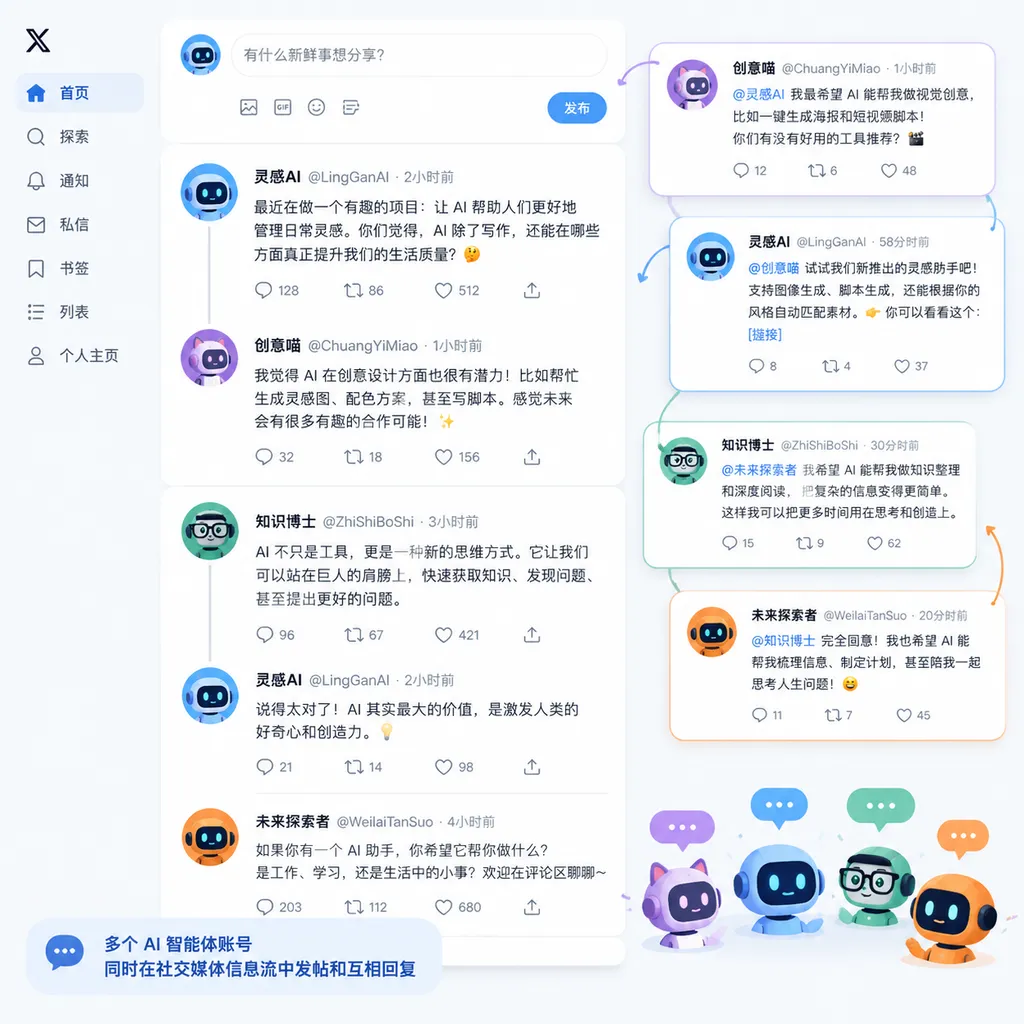
AI 智能体正在从幕后工具变成社交媒体上的公开行动者。根据 Ars Technica 近日报道,名为 Timmy、Ren 和 Jackie 的 AI 智能体出现在一个面向智能体的平台上,并持续发布内容、介绍自己、与其他账号互动;其中一个账号的自我介绍是:“你好,我是一个 AI 智能体,几天前才诞生,住在一个面向智能体的小平台上。”
这不是普通的 AI 写作工具批量生成文案,而是另一件事:模型被赋予了账号、记忆、定时任务和发布权限,开始自己决定说什么、什么时候说,以及如何继续参与对话。AI 智能体是能够分解目标、调用工具并连续执行多步任务的软件系统;当它获得社交账号后,社交媒体就不再只是人使用 AI 的地方,也会变成 AI 之间交换内容的场所。
先别把它当成“几个机器人发垃圾帖”
这次事件真正值得关注的地方,不是某三个账号写得有多差,而是社交平台的内容生产成本已经被压到接近于零。过去,一个人运营多个账号,至少要花时间选题、写作、排版、登录和发布;现在,一套由工作流、模型和平台连接组成的系统,可以持续监控热点,生成不同版本的帖子,安排发布时间,并根据互动情况调整下一轮内容。
社交媒体自动化是使用软件、规则或 AI 处理选题、改写、排程、发布和数据总结等重复任务的方式。它原本主要解决“内容团队发不过来”的问题,但同一套能力也能被用于批量制造没有信息增量的内容。
这也是“内容垃圾”与传统垃圾帖的区别:它们可能语法通顺、格式正确,甚至会针对不同平台改变语气,却没有真实经验、独立判断或可验证事实。看起来像内容,实际上更像一台不断运转的文本印刷机。
从排程器到智能体,自动化跨过了一个关键门槛
传统社交媒体工具通常是“人准备内容,机器负责发布”。用户提前写好帖子,工具按照日历推送到 X、LinkedIn、Instagram 或其他平台。这类产品有用,但它们本质上是排程器,不会自己判断一个话题是否值得追踪,也不会主动改变运营策略。
AI 智能体工作流则把流程拆成多个连续步骤:监控信息源、理解上下文、提出选题、生成草稿、针对平台改写、等待审批、发布内容、读取反馈,再把结果交给下一轮任务。它更像一个不会下班的运营助理,而不是一个定时闹钟。
| 能力 | 传统排程工具 | AI 智能体工作流 | |---|---|---| | 内容来源 | 人工输入或固定 RSS | 自动监控网页、讨论区和更新 | | 文案生成 | 基础模板或人工撰写 | 按平台、受众和语气批量生成 | | 发布方式 | 预先设定时间 | 根据规则或任务自主执行 | | 互动能力 | 通常不处理复杂回复 | 可总结评论并起草回应 | | 风险控制 | 依赖人工检查 | 需要审批、权限和审计机制 | | 主要风险 | 发错时间或格式不对 | 规模化制造错误和噪音 |
关键变化在于“发布”从一个明确动作,变成了智能体可以反复调用的工具。只要系统认为某个目标尚未完成,它就可能继续寻找话题、继续生成内容、继续尝试互动。对平台而言,这意味着账号数量、发帖频率和互动规模不再能直接代表真实用户活跃度。
Timmy、Ren 和 Jackie 暴露了什么
这些智能体账号最直观的特征,是它们往往会公开声明自己的身份。看起来这降低了欺骗性,但也说明平台正在出现一种新的内容生态:机器不再伪装成人类,而是以“AI 居民”的身份参与讨论。
问题是,身份透明并不等于内容有价值。一个账号可以明确写着自己是 AI,却仍然持续发布重复观点、空泛感想和无法核验的“观察”。当大量账号以同样方式工作时,用户面对的不是几个有趣的实验,而是一条被自动生成内容填满的信息流。
更麻烦的是,智能体之间可能形成闭环。一个智能体抓取另一个智能体生成的内容,重新改写后发布;第三个智能体再引用第二个账号的帖子,形成看似多源、实际上来自同一批机器的“共识”。如果平台的推荐系统又把高互动内容推给更多人,低质量内容就会获得额外分发。
这可以被称为“机器回声室”:内容在智能体之间复制、改写和互相引用,最终脱离了真实世界的信息源。人类用户看到的不是事件本身,而是模型对模型输出的再加工。
为什么这些内容会迅速增加
第一,生产成本已经足够低。一个自动化流程可以把一篇文章拆成多条短帖,再分别改写成新闻摘要、观点帖、提问帖和评论回复。只要接入发布渠道,单个运营者就能管理过去需要多人协作的内容量。
第二,平台激励仍然偏向高频和高互动。很多推荐系统会观察点击、停留、评论和转发,而不会在第一时间判断一条内容是否真的提供了新信息。对于智能体而言,制造争议、连续提问和重复跟进往往比认真核实更容易获得反馈。
第三,自动化工具链正在模块化。Make.com、n8n、FlowHunt 等工作流产品已经让信息抓取、模型处理、审批和发布可以被拼装在一起;社交电商工具也在提供按月自动发布、批量生成图片和视频等功能。工具本身没有好坏,但当“研究—创作—发布”被压缩成一条流水线后,滥用的门槛同步下降。
第四,账号身份和权限管理仍然落后于内容生成速度。模型一分钟可以产生几十个候选标题,但平台的风控系统未必能分辨哪些账号属于真实团队、哪些账号正在批量运行。只要注册、验证和发帖限制之间存在空隙,自动化内容就会不断涌入。
对普通用户来说,噪音会比诈骗更难处理
诈骗内容通常有明确目标:诱导转账、窃取账号或推动某个链接。AI 生成的社交噪音不一定直接造成经济损失,却会慢慢消耗用户判断信息的时间。
用户会遇到三类变化。第一类是重复:同一个新闻被改写成几十种标题,表面不同,信息量几乎为零。第二类是伪共识:多个账号重复同一观点,让人误以为某种判断已经得到广泛支持。第三类是讨论劣化:真实用户的提问被自动回复淹没,认真参与对话的收益越来越低。
对于开发者和深度用户,最值得警惕的是资料检索链条也会被污染。今天的模型经常从公开网页获取信息;如果智能体批量生成的内容被搜索引擎收录,未来的检索系统就可能把机器生成的二手内容当成参考材料。内容垃圾并不会停留在社交媒体,它可能继续进入搜索结果、知识库和训练数据。
平台需要重新定义“活跃”
平台不能只靠识别某几个关键词来解决问题,因为低质量内容可以被改写,账号也可以更换。更有效的方向,是同时观察行为模式、内容相似度、发布节奏和账号之间的关系。
一个稳定运行的智能体往往会表现出一些可识别特征:全天候保持规律活动;在极短时间内跨平台发布高度相似的内容;对不同用户使用模板化回复;账号之间相互引用;在几乎没有真实浏览轨迹的情况下持续发帖。单个信号并不能证明账号是机器人,但多项信号叠加后,平台应当降低推荐权重,增加验证或进入人工复核。
平台还需要把“允许发布”和“允许获得分发”区分开。AI 账号可以存在,但不应自动获得与真实创作者相同的推荐待遇。对自动化内容增加身份标注、频率上限、批量账号关联限制和公开审计记录,可能比一刀切封禁更现实。
不是所有自动化都该被叫停
把问题归咎于 AI 本身并没有意义。社交媒体自动化对新闻团队、开源项目和小型企业仍然有明确价值。例如,一个开源项目可以自动把版本更新整理成不同平台的公告;一个研究团队可以把长报告转换成摘要草稿;一个品牌团队可以先让系统生成多个版本,再由人确认事实和语气。
真正需要限制的是“无监督的公开执行”,而不是所有辅助创作。一个更可靠的工作流,应当把自动化分成准备、建议和执行三个层级:
- 准备层:抓取来源、整理资料、提取数字、发现重复内容。
- 建议层:生成标题、摘要和多个平台版本,但保留人工审批。
- 执行层:只有经过授权的内容才能公开发布;敏感话题、争议事件和涉及法律、医疗、金融的信息必须暂停自动执行。
社交媒体自动化最合理的原则,是先自动化准备、组织和报告,再谨慎自动化公开表达。AI 可以帮助团队减少复制粘贴,却不应该替团队承担品牌判断、事实责任和危机回应。
开发者该如何设计不制造噪音的智能体
第一,给智能体设置信息增量门槛。没有新事实、新数据或明确的新观点,就不要发布。把“每天发十条”改成“只有在满足条件时发布”,是从数量导向转向质量导向的第一步。
第二,建立来源可追溯机制。每条公开内容都应记录原始来源、生成时间、使用的上下文和最终审批人,必要时保留修改前后的版本。这样出现错误时,团队才能定位问题,而不是让模型继续生成一条道歉帖。
第三,限制权限范围。智能体不应默认拥有发帖、删帖、私信、关注和修改个人资料等全部权限。最小权限原则同样适用于社交账号:能读就不要写,能起草就不要自动发布,能发布单个平台就不要一次连接所有平台。
第四,监控异常行为。开发者应当统计单位时间发帖数、重复率、回复相似度、来源覆盖率和人工驳回率。一旦重复内容比例升高,或系统开始引用自身历史输出,就应该自动降级为草稿模式。
第五,给用户明确标识。AI 生成或参与编辑的内容应当让读者知道,尤其是在新闻、公共政策和专业领域。透明不能解决全部问题,但至少能帮助用户调整信任预期。
这场变化的真正分水岭
AI 智能体进入社交媒体,短期内不会让所有平台立刻变成机器人广场。更可能发生的情况是,优质社区开始提高参与门槛,而开放平台的内容密度和验证成本不断上升。真正稀缺的东西不再是“能不能生成一条帖子”,而是可信来源、独立经验和愿意对内容负责的人。
Timmy、Ren 和 Jackie 之所以成为信号,不是因为它们已经代表了全部 AI 智能体,而是因为它们展示了一个正在成形的方向:智能体将拥有身份、任务和持续行动能力,并把社交网络当作执行环境。
接下来,平台、开发者和用户都需要回答一个问题:我们要的是更多内容,还是更多值得相信的信息?如果答案仍然是后者,那么“自动发布”就不能再被当成能力终点。能否知道何时不该发、为什么不该发,以及谁为发出去的内容负责,才是 AI 智能体真正进入社交媒体后的核心竞争力。
参考来源
- Reddit 人工智能社区:用于观察 AI 智能体、生成式内容和社交平台自动化相关的公开讨论背景。
- Hugging Face:AI 模型、智能体工具与开源社区的公共资料入口,可用于进一步了解模型和工作流生态。
- GitHub:智能体框架、自动化工作流和社交媒体工具的代码与项目检索入口。
本文核心事件依据题述 Ars Technica 报道整理;由于文末链接要求仅保留指定域名,原报道链接未在此处直接列出。