TabPFN-3.5登场,表格模型开始分快慢
Prior Labs 发布 TabPFN-3.5,推出 Fast、Thinking 和 Plus 版本,在 TabArena、BeyondArena 以及百万行数据评测中刷新成绩。它瞄准的不是聊天,而是企业最常见、也最难被通用大模型彻底替代的表格预测任务。
TabPFN-3.5 登场,表格模型开始分快慢
Prior Labs 在 2026 年 9 月 15 日发布 TabPFN-3.5,新版本同时推出 TabPFN-3.5-Fast、TabPFN-3.5-Thinking 和 TabPFN-3.5-Plus 三条产品线。按照官方发布信息及社区披露的评测结果,TabPFN-3.5 在 TabArena 和 BeyondArena 均位居前列,并将优势扩展到最多 100 万行、最多 2 万个特征的表格数据。
这次更新最值得关注的,不只是又一个榜单第一,而是 TabPFN 开始把“准确率、速度、推理成本”拆成了不同版本。Fast 用更低延迟换取更快批量预测,Thinking 则允许模型在测试阶段投入更多计算,以换取更高准确率。对真实业务来说,这比单纯宣布一个更大的模型更有意义:风控、营销、医疗和供应链团队通常不会只问“谁的分数最高”,而会同时问“每次预测要等多久、成本是多少、是否值得把它放进生产流程”。
TabPFN-3.5 是什么
TabPFN 是一种面向表格数据的基础模型,它通过预训练学习大量合成任务中的数据规律,推理时可以直接处理新的监督学习数据集。 与 XGBoost、LightGBM 等传统方案不同,TabPFN 的核心思路不是针对每个数据集从零开始搜索超参数,而是让一个已经预训练好的 Transformer 直接理解训练集与目标变量之间的关系。
传统表格机器学习往往需要经历数据清洗、特征工程、模型选择、超参数搜索和交叉验证。一个经验丰富的数据科学家可以把这些步骤自动化,但时间和计算资源仍然会不断累积。TabPFN 的价值在于把相当一部分“如何选择模型和参数”的工作提前放进预训练阶段,用户面对新数据时更接近“给模型一张表,让它完成预测”。
TabPFN-3.5 延续了这一方向,但把适用范围推向更复杂的数据集。此前表格基础模型在小样本、低维数据上更容易体现优势;当数据行数达到百万级、特征数量升至数千甚至 2 万时,内存占用、上下文处理和推理延迟都会成为现实障碍。新版本的卖点,正是试图在这些条件下仍然保持竞争力。
三个版本,解决三种不同问题
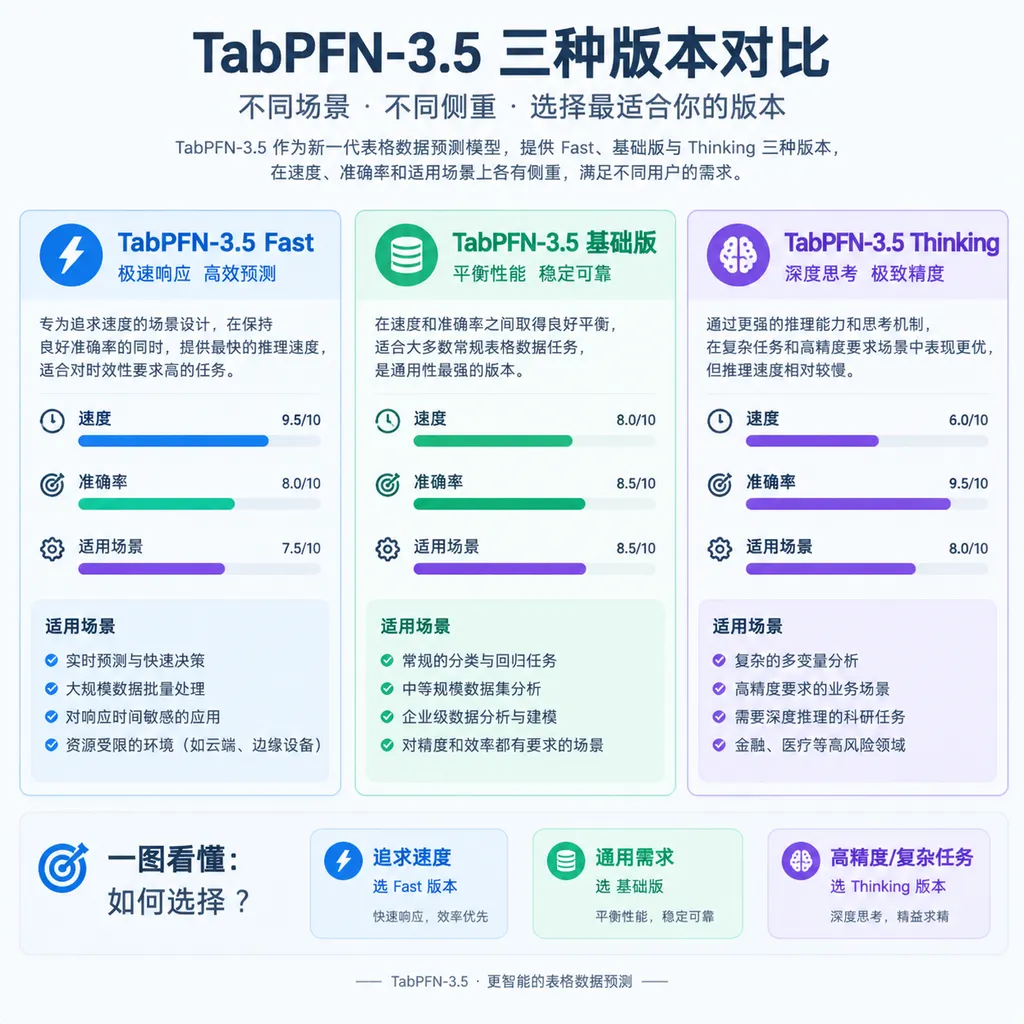
TabPFN-3.5-Fast 是面向吞吐量的版本,官方称其速度约为基础版本的 6 倍,目前仍处于 alpha 阶段。 它更适合离线批量评分、快速实验和需要频繁刷新预测结果的场景。比如电商每天要对数千万条用户行为记录进行重新排序,或者风控系统需要每隔几分钟更新一次候选交易的风险分数,此时多几分准确率未必比缩短等待时间更重要。
TabPFN-3.5-Thinking 是通过增加测试阶段计算来换取更高准确率的版本,当前主要通过官方 API 提供。 从公开评测看,它在 BeyondArena 上比基础版高 20 Elo,在 TabArena 上高 44 Elo。这里的关键不是“模型突然学会了更多知识”,而是它在面对当前数据集时愿意花更多计算进行额外拟合和判断,类似让一个分析师在交卷前多做一轮检查。
TabPFN-3.5-Plus 是面向更高阶使用需求的产品线,但公开资料目前尚未披露足够完整的规格、价格和硬件要求。 因此,现阶段不宜仅凭 Plus 的命名推断它一定在所有数据集上优于 Fast 或 Thinking。真正有价值的比较仍然要看完整的模型卡、评测设置、数据规模和实际成本。
| 版本 | 核心取向 | 已披露信息 | 更适合的场景 | | --- | --- | --- | --- | | TabPFN-3.5 | 综合性能 | 在 TabArena、BeyondArena 等评测中处于领先位置 | 通用表格分类与回归实验 | | TabPFN-3.5-Fast | 更低延迟、更高吞吐 | 速度约为基础版本 6 倍,处于 alpha 阶段 | 批量预测、快速迭代、实时或准实时任务 | | TabPFN-3.5-Thinking | 更高准确率 | BeyondArena 比基础版高 20 Elo,TabArena 高 44 Elo | 对单次预测质量更敏感的业务 | | TabPFN-3.5-Plus | 面向进阶使用 | 具体规格和定价仍需等待更多公开资料 | 大规模或专业生产环境评估 |
榜单优势不只是“又赢了一次”
BeyondArena 是更强调真实复杂表格场景的评测集合,TabPFN-3.5 在其中领先此前最强基线约 250 Elo,并比此前总榜第一高约 150 Elo。 这两个数字说明,新模型的优势并不只来自某一类标准化小数据集,而是覆盖了文本丰富、高基数和高维数据等更棘手的任务。
高基数数据是指某个类别型特征拥有大量不同取值,例如用户 ID、商品编码、网页域名或设备标识。对传统模型来说,如何编码这些字段往往会直接影响结果;简单的独热编码会造成维度膨胀,目标编码又可能引入数据泄漏。表格基础模型如果能更稳定地处理这类字段,就可能减少一部分人工特征工程。
文本丰富数据则是另一种挑战。很多业务表格并不是纯数字和离散标签,而是同时包含商品标题、客服记录、病历摘要或广告文案。模型需要把文本字段和金额、时间、地域等结构化字段放在同一个预测任务里处理。BeyondArena 对这类数据的强调,意味着评测正在从“干净的教学数据集”向更接近企业数据的混合形态移动。
高维数据是指特征数量显著增加、甚至达到数千到 2 万维的数据。基因组学、传感器、广告画像和用户行为系统都可能产生这类数据。TabPFN-3.5 能够覆盖最多 2 万个特征,是它相较早期表格模型的一项重要扩展,但这并不意味着所有高维数据都可以直接丢给模型。缺失值比例、标签噪声、时间泄漏和训练测试分布变化,仍然会决定最终效果。
百万行数据,才是这场竞争的分水岭
TabPFN-3.5 宣称支持最多 100 万行规模的数据集,这让表格基础模型从“中小型实验工具”进一步靠近企业生产环境。 过去,TabPFN 的吸引力主要体现在小型数据集上:无需长时间调参,就能在很短时间内得到具有竞争力的结果。随着数据集变大,模型必须同时解决计算复杂度、内存压力和推理吞吐问题。
公开补充资料显示,上一代 TabPFN-3 已经通过工程优化显著提升速度,部分场景相较旧版本可快 10 到 1000 倍,SHAP 解释速度也曾被披露提升约 120 倍。SHAP 是一种用于解释特征贡献的方法,可以帮助使用者判断某个特征究竟把预测结果推高还是压低。对企业而言,预测快只是第一步,能否在可接受时间内完成解释同样重要。
不过,“支持 100 万行”需要谨慎理解。它通常表示模型或产品在特定数据格式、硬件配置和任务设置下可以处理这一规模,并不等于所有百万行表格都能在普通笔记本上实时运行。数据读取方式、类别特征数量、缺失值处理、GPU 显存和输出目标,都会改变实际速度。评测中的最大规模也不应直接等同于生产系统的推荐规模。
它和 XGBoost、LightGBM 谁更值得用
TabPFN-3.5 的真正竞争对手不是聊天模型,而是 XGBoost、LightGBM、CatBoost 以及经过充分调参的传统机器学习流水线。 这些树模型已经在工业界验证多年,训练速度快、资源要求相对可控,而且拥有成熟的特征重要性、分布式训练和线上部署工具链。
TabPFN-3.5 的优势是减少试错成本。在数据集规模适中、任务结构复杂、团队不想投入数小时甚至数天调参时,它有机会用更短时间给出强基线。对于数据科学家来说,这意味着可以先用 TabPFN 判断任务上限,再决定是否值得为 XGBoost 或 LightGBM 设计更复杂的特征工程。
但在超大规模数据、严格低延迟服务和高度稳定的生产环境中,树模型仍然很难被轻易替代。一个经过充分优化的 LightGBM 模型可以在 CPU 集群上稳定运行,CatBoost 对类别特征有成熟支持,而企业现有监控、回滚和模型治理系统也往往围绕这些模型搭建。TabPFN-3.5 更合理的定位,是成为强力候选模型和自动化基线,而不是宣称“一键取代所有树模型”。
| 对比维度 | TabPFN-3.5 | XGBoost / LightGBM | CatBoost | | --- | --- | --- | --- | | 是否需要大量调参 | 相对较少 | 通常需要 | 通常需要 | | 适合的主要数据 | 结构化表格及部分混合数据 | 数值、类别等结构化数据 | 类别特征较多的结构化数据 | | 百万行规模 | 新版本重点支持,但依赖具体配置 | 工业实践成熟 | 工业实践成熟 | | 训练思路 | 预训练模型直接适配新任务 | 针对当前数据集训练树模型 | 针对当前数据集训练树模型 | | 生产生态 | 仍在发展 | 非常成熟 | 成熟 | | 主要优势 | 少调参、跨任务迁移、综合榜单表现 | 速度、可控性、部署成本 | 类别特征处理和易用性 |
Thinking 版本的意义:测试时计算正在进入表格模型
测试时计算是指模型在面对具体输入或数据集时增加额外计算,而不是只依赖固定的单次前向推理。 在大语言模型领域,这种思路通常表现为更长的思考过程;在 TabPFN-3.5-Thinking 中,它更接近针对当前表格任务进行额外拟合和评估。
这条路线的优点是灵活。对高价值信贷审批、医疗风险筛查或关键设备故障预测来说,单次预测的错误代价可能远高于多花一些计算。此时,Thinking 版本的 20 Elo 或 44 Elo 提升可能值得付出额外延迟。
它的代价也同样明显:更高的计算量通常意味着更长的等待时间和更高的使用成本,而且并非所有数据集都会获得同等收益。如果任务本身标签噪声很大、训练数据存在严重偏差,额外拟合可能只是更认真地学习噪声。实际落地时,团队应该按业务损失函数评估,而不是只看榜单上的 Elo 变化。
开发者现在该怎么评估
评估 TabPFN-3.5 的第一步不是直接替换线上模型,而是建立包含传统基线的同一套离线测试。 至少应同时比较 TabPFN-3.5、Fast 或 Thinking、LightGBM、XGBoost,以及业务当前使用的模型,并固定训练集、验证集、测试集划分。
建议重点记录以下指标:
- 预测质量: 分类任务看 ROC-AUC、PR-AUC、F1 和校准误差,回归任务看 RMSE、MAE 和 R²。
- 端到端延迟: 不只记录模型推理时间,还要统计数据加载、预处理、批量输出和解释生成时间。
- 资源占用: 记录 CPU、GPU、显存、内存和并发数,避免只在单个小样本上得出结论。
- 稳定性: 按时间、地域、用户群体和数据稀疏程度拆分评测,观察模型是否在某些分组上明显退化。
- 可解释性: 检查特征贡献是否符合业务常识,并确认是否存在标签泄漏或不合理的代理变量。
- 成本收益: 将一次训练、一次批量预测和一次在线请求的综合成本,与准确率提升带来的业务收益放在一起计算。
如果目标是快速探索,TabPFN-3.5-Fast 会是更合适的起点;如果是高价值决策,可以把 Thinking 版本放在离线复核或候选排序环节;如果是大规模稳定生产,则应同时保留经过验证的树模型作为对照和故障切换方案。
OpenAI Hub 判断:表格基础模型终于开始产品化
TabPFN-3.5 的发布说明,表格基础模型正在从“论文里的单一模型”走向“按业务目标拆分的产品”。 Fast、基础版和 Thinking 并不是简单的模型大小差异,而是把企业最关心的三个变量——速度、准确率和计算预算——明确摆到产品选择里。
这也是它比上一代更新更值得关注的地方。表格数据不会因为生成式 AI 热潮而消失,企业的订单、交易、库存、传感器和用户行为仍然以表格形式存在。通用大语言模型可以帮助分析这些数据,却很难直接替代针对监督预测优化的模型。谁能在复杂表格上同时提供稳定效果、可解释结果和可控成本,谁才有机会进入真实业务流程。
当然,TabPFN-3.5 目前还不能被简单概括成“全面击败 XGBoost”。公开资料尚未完整披露所有版本的价格、硬件要求、数据预处理限制和生产部署细节,Fast 仍处于 alpha 阶段,Plus 的能力边界也需要更多实测。榜单领先证明了模型的上限,但企业采购和上线看的是长时间运行后的平均表现。
截至 2026 年 9 月 15 日,更准确的结论是:TabPFN-3.5 已经把表格基础模型的竞争从小样本准确率,推进到百万行规模、复杂字段处理和测试时计算的综合比拼。 对开发者来说,值得立刻做的不是追逐“榜单第一”,而是把它加入现有评测矩阵,看看它能否在自己的数据、延迟和成本约束下真正赢一次。
参考来源
- Reddit:TabPFN-3.5 is released as the next SOTA tabular foundation model —— 发布信息、TabArena 与 BeyondArena 评测结果,以及 Fast、Thinking、Plus 版本说明。
- Reddit:TabPFN-3 刚刚发布:一个针对最多 100 万行的预训练表格基础模型 —— 上一代 TabPFN-3 的速度、SHAP 加速与测试时计算相关资料。
- 知乎:Synthefy Nori:6M 参数的表格基础模型,可以替代 XGBoost 和 TabPFN-3 —— 表格基础模型与 XGBoost、TabPFN-3 的竞争背景及相关评测讨论。
- 知乎:TabPFN:一秒内解决小型表格分类问题的 Transformer 模型 —— TabPFN 早期技术路线与小型表格分类任务背景介绍。