9美元训出Gemini替身
开发者用Gemini标注4290条数据,将GLiNER微调成低成本专用模型。但真正值得复制的不是9美元,而是任务收窄、数据闭环与严格评测。
9美元训出Gemini替身:便宜的不是模型,而是把问题做窄
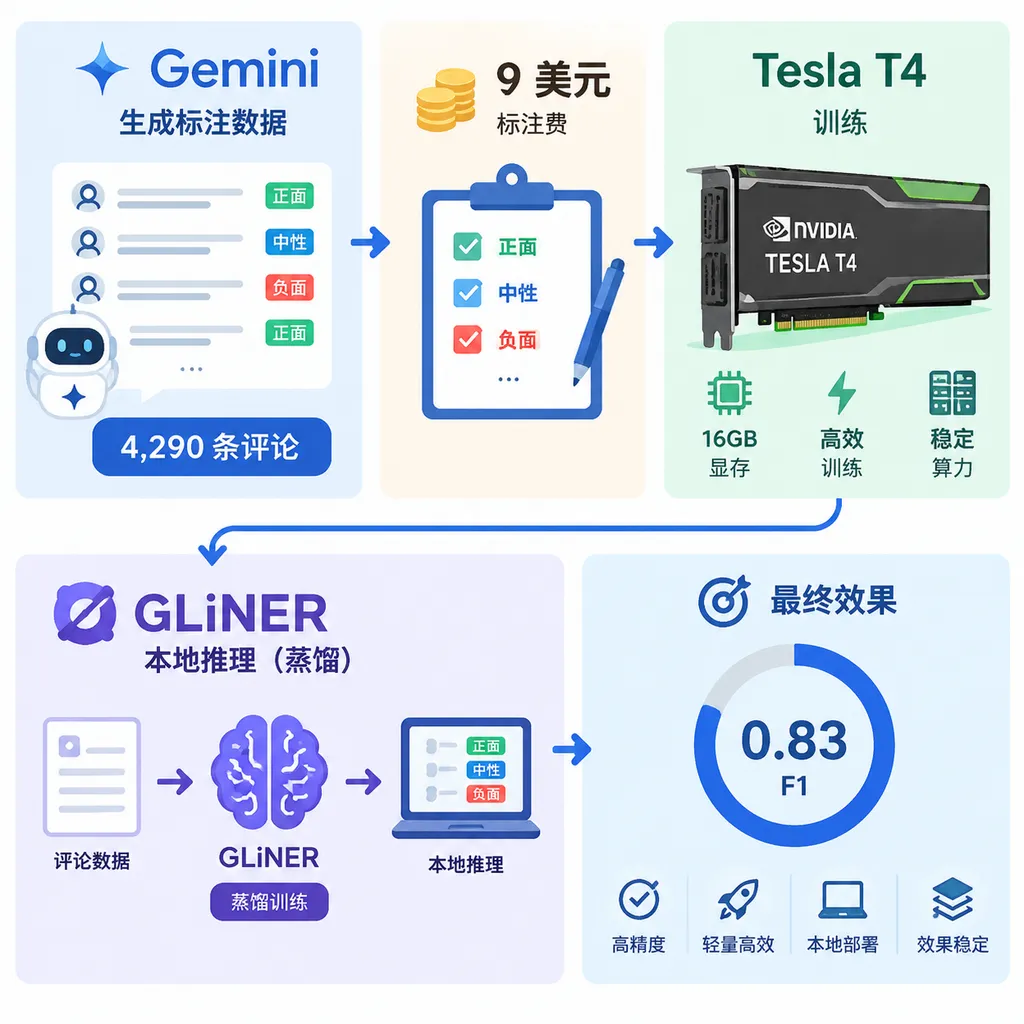
近期,开发者 Peter Vijeh 公布了一次颇具代表性的低成本模型蒸馏实验:他让 Gemini 3.1 Pro 为 4290 条 Reddit 评论生成实体标注,再用这些数据微调开源模型 GLiNER large v2.5,最终在固定验证集上取得 0.83 F1。Gemini 标注费用为 9 美元,10 次训练使用的 Tesla T4 算力约为 2.50 美元。(petervijeh.com)
这不是一个小模型全面替代 Gemini 的故事,而是一个通用大模型被压缩成垂直分类器的故事。所谓“替代模型”,只负责从厨刀社区评论中找出品牌、型号和钢材名称;一旦问题超出这三个标签,它就不再是 Gemini 的替身。
这一区别很重要。9 美元没有买到一个新的通用模型,而是买到了一批机器标注数据,并把 Gemini 对特定任务的判断方式固化进一个 4.59 亿参数的编码器模型中。
实验解决的,是一张会持续增长的账单
命名实体识别(Named Entity Recognition,NER)是从文本中定位并分类专有实体的任务,例如识别人名、公司、产品型号或材料名称。传统 NER 模型通常只能识别训练时预设的类别,而 GLiNER 允许开发者用自然语言指定实体类型,并可在少量领域数据上继续微调。GLiNER 官方项目将其定位为可在 CPU 和消费级硬件上运行的轻量级实体识别框架。(github.com)
Vijeh 原本使用 Gemini 逐条处理厨刀社区的新评论。比如在一条同时提到 Mazaki、Fibrox 和 white #2 的评论中,模型需要判断哪一个是品牌、哪一个是型号、哪一个是钢材,同时忽略“carbon steel”“handle”等容易触发误判的普通词。
这类任务对大模型并不难,但其成本会随评论数量线性增长。每新增一条评论,就增加一次推理费用;若为了控制预算而跳过评论,数据覆盖率又会下降。
未经微调的 GLiNER 虽然可以零样本运行,成本接近本地算力费用,但对照 Gemini 标注只能取得约 0.65 F1。Vijeh 因而选择让 Gemini 一次性标注历史数据,再让 GLiNER 学习这些结果。
| 项目 | Gemini逐条处理 | GLiNER零样本 | 微调后GLiNER large v2.5 | |---|---:|---:|---:| | 模型定位 | 通用生成模型 | 通用实体识别模型 | 厨刀领域实体识别模型 | | 单条新增数据成本 | 持续产生 | 本地推理成本 | 本地推理成本 | | 对照Gemini标注的F1 | 作为教师基准 | 约0.65 | 0.83 | | 参数规模 | 未披露 | 4.59亿 | 4.59亿 | | 是否需要领域训练 | 否 | 否 | 是 | | 主要优势 | 理解能力强 | 部署简单、标签灵活 | 成本、准确率较平衡 |
从 0.65 到 0.83,相对提升约为 27.7%。这个数字已经足以改变工程选择:如果下游只是趋势统计、搜索索引或社区舆情聚合,0.83 F1 的本地模型可能比每条都调用通用大模型更划算。
这更接近伪标签蒸馏,而非经典知识蒸馏
合成数据是由模型、规则或模拟系统生成,而非完全由人工直接标注的数据。在这次实验中,原始评论来自真实用户,合成的是品牌、型号与材料标签,因此称为“机器生成标注”或“伪标签”比笼统的合成数据更准确。
知识蒸馏是让较小的学生模型学习较强教师模型行为的训练方法。经典蒸馏通常会学习教师模型输出的概率分布或中间特征,而这次实验只有 Gemini 给出的最终实体字符串,GLiNER 看不到 Gemini 的 logits、隐藏状态和推理过程。
因此,这套方案严格来说是黑盒任务蒸馏:教师模型生成结构化答案,学生模型将答案当作监督数据。它不能复制 Gemini 的通用推理能力,却非常适合抽取、分类、路由、审核和意图识别等边界明确的任务。
整个数据生成环节只花了约 25 分钟。Gemini 共处理 4290 条评论,费用为 9 美元,平均每条约 0.0021 美元。作者据此认为,只计算教师标注费用时,在后续处理约第 4291 条新评论后,训练专用模型就开始体现成本优势。(petervijeh.com)
不过,“9 美元替代 Gemini”明显省略了几笔账。加上约 2.50 美元的训练算力,直接实验成本为 11.50 美元;按照每条 0.0021 美元估算,需要累计处理约 5482 条新评论才能覆盖这笔直接成本。若再计入数天调试时间、本地推理硬件、服务维护和数据漂移监控,真实盈亏平衡点会更晚。
这不影响实验价值,但提醒开发者不要把“标签费用”误写成“项目总成本”。低成本蒸馏往往便宜在算力,昂贵在人。
最聪明的设计:让大模型返回字符串,不返回位置
数据管线中最值得复用的决策,是不让 Gemini 直接计算字符偏移量。大模型擅长识别实体含义,却不擅长稳定地数出一个词从第几个字符开始,遇到 Unicode、表情、标点和特殊空格时尤其容易偏移两三个位置。
Vijeh 只要求 Gemini 返回实体原文和类别,再由 TypeScript 在原评论中查找字符串并计算起止位置。如果模型返回的文本根本不存在于评论中,该实体就会被丢弃并写入日志。
这种职责划分比继续调提示词可靠:语义判断交给大模型,确定性定位交给代码。对于文档抽取、票据解析和内容审核系统,同样应尽量让模型输出可验证的原文片段,而不是自行计算坐标、页码或字符位置。
厨刀型号还包含大量特殊符号,例如 VG-10、CPM-154 和 1.4116。通用分词器可能把它们拆散,因此实验使用正则表达式保留常见材料名的整体结构;无法与 token 边界对齐的跨度则直接丢弃,而不是猜测。
训练集还加入了大量负样本。负样本是看起来可能包含目标实体、实际上应输出空结果的数据,例如只有 gyuto、carbon、handle 或 patina 等泛化词的评论。约 30% 的训练数据属于这类难负样本,用于压制模型见词就标的冲动。(petervijeh.com)
这部分比增加正样本更关键。实体抽取系统在生产环境中的主要问题通常不是漏掉一个冷门品牌,而是把大量普通名词误报为品牌,导致统计结果和搜索索引被污染。
10次训练有5次没有得到可用模型
训练失败并不总会表现为程序崩溃。在这次实验的 10 次运行中,有 5 次没有产出可用模型:前三次来自训练配置,后两次则源于一个名为 words_mask 的张量。(petervijeh.com)
| 运行 | 问题 | 后果 | 修复方式 |
|---|---|---|---|
| 1 | 默认max_steps=10000覆盖3个epoch | 实际训练约39个epoch | 显式设置max_steps |
| 2 | 启用最佳模型加载却未配置评估策略 | Trainer报错 | 设置eval_strategy=steps |
| 3 | 保存的参数名缺少model.前缀 | GLiNER无法正常加载 | 保存时补回前缀 |
| 4 | 负样本缺少ner_labels | 标签结构不完整 | 每条样本都写入标签列表 |
| 4—5 | words_mask被误写为二值掩码 | 损失长期停留在70—130 | 改为递增的词索引 |
words_mask 看起来像 attention mask,却不是普通的 0、1 掩码。它实际记录每个子词属于第几个原始单词,供跨度预测层把 sub-token 重新聚合成 word。
错误:words_mask = [1, 1, 1, 1, 1]
正确:words_mask = [0, 1, 2, 2, 3]
                     CLS Mazaki wh ite #2
当整个句子都被标记为同一个词时,模型相当于被要求在一个超大 token 内寻找品牌和材料跨度。训练仍能运行、梯度也没有异常,但损失不下降,验证 F1 接近零。
这个故障说明,训练管线中最危险的错误不是异常退出,而是“形状正确、语义错误”的张量。它能通过类型、维度和数值检查,却悄悄改变模型所看到的数据结构。
作者最终得出的工程判断很直接:如果只能在更大的标注集和针对每个手工张量的断言之间二选一,他会先选断言。这个判断比 9 美元的标题更有价值,因为小模型微调的大部分时间,往往消耗在数据格式与训练框架的连接层。
4.59亿参数不一定比2.09亿划算
修复 words_mask 后,第 6 次训练开始正常收敛。2.09 亿参数的 medium 模型达到 0.800 F1,4.59 亿参数的 large 模型达到 0.83 F1;后者在 Tesla T4 上需要依靠梯度累积才能训练。(petervijeh.com)
| 模型 | 参数量 | 验证集F1 | 相对特点 | |---|---:|---:|---| | GLiNER medium | 2.09亿 | 0.800 | 更轻、部署成本更低 | | GLiNER large | 4.59亿 | 0.830 | F1高0.03,显存压力更大 |
对于吞吐量较高的在线服务,0.03 F1 是否值得超过一倍的参数量,需要结合延迟、CPU核数和误报成本判断。large 是实验中的最高分模型,却未必是商业部署中的最优模型。
阈值调整同样影响很大。使用统一置信度阈值时,MagnaCut、S35VN 和 HAP40 等钢材名称的分数普遍低于品牌名,模型容易将其过滤。改为按类别分别设置阈值后,材料召回率从 0.787 提升到 0.911,增加了 12.4 个百分点。
这说明生产模型不应只保存一份权重文件。标签级阈值、校准策略、分词规则和前处理逻辑都属于模型的一部分;缺少这些配套配置,同一权重可能表现出完全不同的业务效果。
0.83 F1的含金量,需要打一个折扣
F1 是精确率与召回率的调和平均数,用于同时衡量模型是否少误报、少漏报。但这里的 0.83 F1 衡量的是 GLiNER 与 Gemini 标注的一致程度,不是与人工真值的一致程度。
整个标签集没有经过系统人工复核。这意味着 Gemini 标错时,学生模型复制错误会被计为正确;学生模型若纠正了教师错误,反而会被扣分。因此,0.83 只能证明学生模型较好地模仿了教师,不能证明它对真实世界达到 83% 的准确程度。
实验中曾有一次随机切分得到 0.879 F1,但作者没有把它作为最终结果。固定 225 条验证集后,可信结果回落到 0.83;此前一些看似由训练策略带来的提升,实际只是验证集样本变化造成的波动。(petervijeh.com)
这也是小数据集最常见的跑分陷阱。验证集只有 225 条时,少量困难样本就足以明显改变总分。正确做法不是不断换随机种子挑最高分,而是在调参前锁定测试集,并额外建立一批人工审核的黄金样本。
模型在约第 2 个 epoch 达到最佳表现,此后开始过拟合。增加 10 倍对抗负样本也没有继续提高成绩,反而将 F1 降到 0.799。数据不是越多越好,标签分布一旦失衡,学生模型会为了减少误报而牺牲大量召回。
真正可复制的,是“大模型标一次,小模型跑长期”
这次实验最适合迁移到输入规模大、输出结构窄、业务分布相对稳定的任务。典型场景包括商品属性抽取、客服工单路由、合同条款分类、论坛内容标签、日志事件归类与垂直搜索索引。
一个任务是否值得蒸馏,可以先检查五个条件:
- 输出能否被定义为有限标签或固定字段;
- 同类请求是否会持续出现数万次以上;
- 教师模型的答案能否通过规则或抽样人工审核;
- 输入分布是否相对稳定;
- 本地模型的错误是否不会造成不可逆的高风险后果。
如果任务需要开放式推理、频繁变化的世界知识或复杂多轮上下文,小模型很难靠几千条伪标签真正替代通用大模型。若任务只是从重复文本中抽取三个字段,继续为每条请求调用大型生成模型,则更像用一支研究团队长期做数据录入。
更稳妥的生产架构不是彻底删除教师模型,而是分层处理:高置信度样本由本地模型直接输出,低置信度或分布外样本交给教师模型,并将新答案回流到下一轮训练。这种主动学习闭环能同时控制成本和数据漂移。
开发者还应加入三类监控:标签分布变化、各类别置信度变化,以及教师与学生在抽样数据上的分歧率。只看总体 F1,往往会掩盖某一个关键类别召回率突然下降的问题。
结论:9美元是传播点,任务工程才是护城河
这项实践证明,强模型最有价值的用法之一,不是永远充当在线推理引擎,而是先充当廉价、快速的领域标注员。4290 条伪标签、24 分钟 T4 训练和 0.83 F1,已经足以让一个持续产生费用的抽取任务转向本地模型。(petervijeh.com)
但“Gemini 训练了自己的替代者”仍然是一种带有传播性的表达。GLiNER 替代的是 Gemini 在一个狭窄数据管线中的岗位,而不是 Gemini 本身;11.50 美元也只是直接计算成本,没有包含数天调试与长期维护。
真正值得开发者带走的经验有三个:让大模型负责生成语义标签,让确定性代码负责位置与格式;在调参前锁定验证集,并保留人工黄金集;把数据管线中的每个张量都当作可能出错的模型组件。
模型蒸馏的门槛确实已经降得很低,但低门槛不等于低难度。今天,购买几千条高质量机器标注可能只需一顿简餐的钱;把这些标注变成稳定、可监控、不会悄悄失效的生产系统,仍然是一项扎实的工程工作。
参考来源
- GLiNER GitHub项目:GLiNER的官方代码、训练方式、架构说明与部署能力。
- GLiNER large v2.5模型页:实验所用large系列模型的权重与模型信息。
- GLiNER medium v2.5模型页:用于对照轻量版本的模型资料。