LLM开始实时生成自己的权重
Infinite-Parameter LLM 把实时数据从提示词搬进权重,让模型在推理期间生成并适配参数。这可能改变个性化与智能体记忆,也带来污染、回滚和推理成本等新问题。
大模型的权重,不再只在训练结束时确定
**一篇编号为 arXiv:2609.18842、题为《Infinite-Parameter LLMs: Generating and Adapting Weights from Live Data》的预印本近日提出:大语言模型可以根据实时数据生成并适配自身权重,而不是始终依赖一份冻结的模型参数。**截至 2026 年 9 月 17 日,这项工作仍更接近研究范式而非成熟产品,但它指向了一个值得关注的变化——模型获取新知识的方式,可能从“把资料塞进上下文”进一步转向“把数据编译成临时权重”。
**Infinite-Parameter LLM,即无限参数大语言模型,是一种通过权重生成机制,将实时数据映射为动态参数的语言模型架构。**这里的“无限参数”不是说服务器真的存放了无限多个浮点数,而是指模型不再只有一个固定、有限的参数集合;面对不同用户、任务和数据流,它可以按需生成新的参数状态,因此潜在可表达的有效参数空间不受单个静态检查点限制。
**模型权重是控制神经网络如何变换输入信号的一组数值,也是传统 LLM 存储能力、模式和训练知识的主要载体。**常规模型完成预训练与训练后处理后,部署侧拿到的是一个相对静态的检查点。用户今天输入的新事实通常只存在于上下文、检索结果或外部数据库中,并不会自动写进模型权重。
这篇论文试图改写的,正是这条边界。
它不是把整个模型现场重训一遍
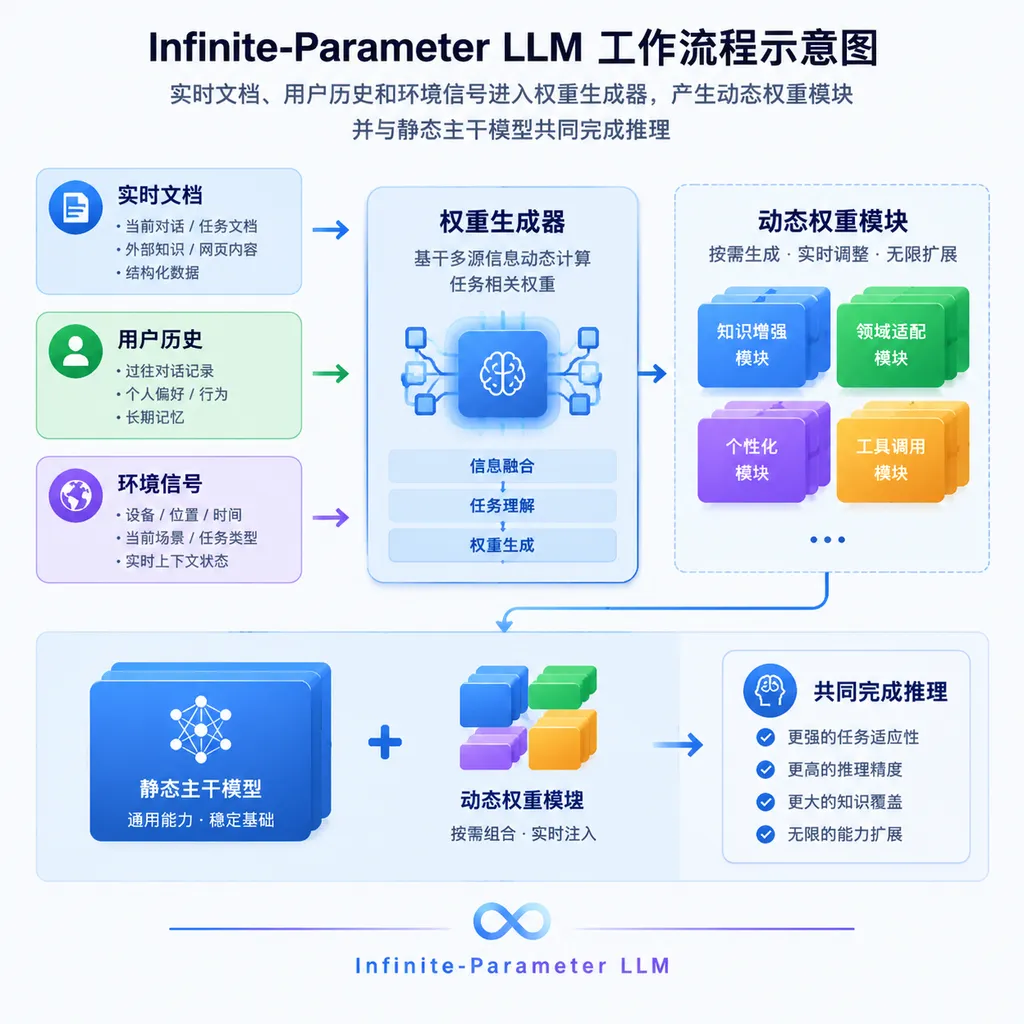
**动态生成权重与在线全量训练不是一回事。**如果每收到一条新消息就对数百亿参数执行完整反向传播,延迟、显存和稳定性都无法接受;更现实的路线,是保留一个稳定的主干模型,再由额外模块把实时数据转换成规模较小、生命周期可控的参数增量。
**权重生成器是一个根据输入数据产生另一组模型参数的网络,也常被归入超网络或 fast weights 路线。**它可以读取用户历史、最新文档、传感器数据或任务反馈,输出低秩矩阵、适配器参数、路由权重,或者某些层的增量更新。主模型推理时同时使用基础权重和这些动态权重,得到针对当前数据状态的行为。
一个简化后的工作流可以分成四步:
- **接收实时数据。**数据可以来自企业知识库更新、用户长期交互、智能体执行轨迹或环境反馈。
- **压缩数据状态。**系统把原始数据编码成较短的状态表示,避免将全部历史反复塞进上下文窗口。
- **生成参数增量。**权重生成器将状态映射为适配器、低秩更新或其他可组合参数。
- **带状态推理。**主干模型加载或组合对应权重,完成当前请求,并在新数据到来后继续调整。
**这种架构最关键的变化,是把部分“读上下文”变成了“改变计算方式”。**RAG 给模型递上一摞临时资料,模型仍使用同一套权重阅读;动态权重则更像根据资料临时调整模型内部的神经连接,让同一句提示在不同参数状态下走出不同的计算路径。
和 RAG、长上下文、LoRA 到底有什么不同
**Infinite-Parameter LLM 并不是 RAG、长上下文或 LoRA 的简单改名。**几种方法都能让模型适配新数据,但它们写入信息的位置、更新速度、推理成本和可撤销性明显不同。
| 方案 | 新数据存放位置 | 适配时机 | 是否改变推理权重 | 主要优势 | 主要短板 | |---|---|---|---|---|---| | 固定权重 LLM | 预训练检查点 | 离线训练阶段 | 否 | 部署简单、批处理效率高 | 知识存在截止日期,个性化弱 | | 长上下文 | Prompt 上下文 | 每次请求 | 否 | 原始信息保留完整,使用门槛低 | Token 成本高,长上下文利用率不稳定 | | RAG | 外部数据库与检索结果 | 每次请求 | 否 | 知识可更新、来源容易追踪 | 依赖召回质量,检索错误会直接影响答案 | | LoRA/PEFT | 独立适配器参数 | 通常离线或准在线训练 | 是 | 参数量较小,可按任务切换 | 仍需训练流程,频繁更新和版本管理复杂 | | Infinite-Parameter LLM | 由实时数据生成的动态权重 | 推理前或推理期间 | 是 | 适应快,可形成用户或任务专属状态 | 安全、回滚、缓存和可解释性难度更高 |
**LoRA 是通过低秩矩阵近似模型权重更新的参数高效微调方法。**微软 LoRA 项目给出的经典结果显示,相比完整微调 GPT-3 175B,LoRA 可将可训练参数量降低约 10,000 倍,并将 GPU 显存需求降低约 3 倍。Infinite-Parameter LLM 可以借用类似的低秩参数形式,但两者的核心差异在于:LoRA 通常先准备数据、运行优化器、保存适配器;动态权重路线则希望由生成器直接把实时数据映射成可用参数。
**RAG 是在生成前从外部数据源检索相关内容,并将结果加入模型输入的增强生成方法。**RAG 的优势是证据可见、文档容易删除,特别适合需要引用原文的企业问答;动态权重更适合反复出现、难以压缩成几段检索文本的行为模式,例如用户长期写作风格、工具使用习惯或持续变化的控制策略。
**长上下文是让模型在一次推理中直接处理更多 Token 的方法。**它保留了最多的原始细节,但标准自注意力的计算和显存开销会随序列长度快速增长,即便采用稀疏注意力、滑动窗口和 KV Cache,几十轮历史被每次重复读取仍不经济。把稳定模式压缩成动态参数,理论上可以减少这种重复计算,但参数生成本身也有成本,不能被当成免费记忆。
真正有价值的场景不是“自动背新闻”
**Infinite-Parameter LLM 最有价值的方向,是持续适应,而不是单纯记住刚发生的事实。**新闻、价格、库存和政策条款仍适合放在可检索数据库中,因为这些信息需要明确来源,也需要随时删除;模型若把它们隐式写入权重,反而会让事实追踪变得困难。
**个性化智能体可能是动态权重最直接的落地场景。**一个长期服务同一用户的编码智能体,需要逐渐掌握仓库结构、命名习惯、测试偏好和代码审查标准。如果每次都把数月历史完整送进上下文,成本会持续上升;如果把稳定偏好转化为小型参数状态,系统就有机会用更短提示恢复长期行为。
**实时控制任务比知识问答更需要参数级适应。**机器人、游戏智能体、广告排序和风控系统面对的是不断变化的数据分布,模型需要从近期反馈中改变策略,而不是只复述一段检索材料。动态权重可以把环境信号转化为短期策略,但前提是更新过程足够稳定,不能因为少量异常样本导致行为漂移。
**企业多租户部署也可能从“一个客户一个微调模型”转向“一个主干模型加大量动态状态”。**这种方案可以避免复制完整检查点,但会把压力转移到状态存储、权限隔离、权重缓存和调度系统。参数文件变小并不代表基础设施更简单,只是复杂度换了位置。
“无限”首先是一种参数化方式
**无限参数并不意味着模型容量可以脱离算力约束无限增长。**任意一次推理仍只能加载有限数量的参数,GPU 显存、内存带宽和延迟预算也没有消失。“无限”描述的是可生成参数集合的潜在规模:不同实时数据可以产生不同权重,系统不必在部署前把所有状态逐一训练并保存。
**这套机制更像一个函数,而不是一座无限大的参数仓库。**假设权重生成器记为 G,实时数据状态记为 D,动态权重记为 ΔW,那么核心关系可以写成 ΔW = G(D);主模型实际使用的参数则可以表示为 W' = W + ΔW。系统存储的是基础权重 W、生成函数 G,以及必要的数据状态,而不是事先穷举所有可能的 W'。
**动态参数是否真的带来更强能力,取决于生成器能否把数据压缩成有效更新。**如果生成出的权重只是把输入内容换一种形式保存,能力提升可能主要来自额外存储;如果它能从连续反馈中抽取稳定规律,才可能获得比单次上下文学习更高的复用效率。
最大风险:脏数据不再只是脏上下文
**实时数据一旦进入权重,提示注入就可能升级为参数污染。**传统 RAG 遇到恶意文档时,可以删除文档、重建索引并清空对话;如果恶意模式已经被编码进动态权重,系统还需要定位受影响的参数状态、判断传播范围并执行回滚。
**数据撤回会成为动态权重系统的硬问题。**用户要求删除一条历史记录时,数据库可以删除对应行,但神经网络参数通常无法指出某个数值究竟来自哪条样本。实际产品至少需要保存数据到权重版本的映射、生成时间、生成器版本和依赖链,否则“删除个人数据”很可能只删除原文,没有消除模型行为中的残留影响。
**共享主干模型会放大租户隔离风险。**如果不同用户的动态权重能够交叉组合、共用缓存或影响路由,系统可能出现信息泄露和行为串扰。可靠部署需要确保每份参数状态拥有明确的身份、权限、生命周期和加密边界,不能只依赖 Prompt 中的一句“不要泄露”。
**持续适应还会重新带回灾难性遗忘问题。**灾难性遗忘是模型学习新数据后丢失旧能力的现象。动态权重虽然可以与基础权重分离,但多个增量模块叠加后仍可能发生冲突:模型适应了近期用户偏好,却破坏了安全拒答、事实准确性或通用推理能力。
推理系统会变得更难做
**动态权重首先会破坏大模型服务最依赖的批处理效率。**当前推理平台可以把使用相同模型的请求拼成批次,让 GPU 对同一套矩阵权重执行高吞吐计算;如果每个用户都有不同权重,批次会被切碎,权重加载和显存换入换出可能吞掉适配带来的收益。
**参数缓存将成为与 KV Cache 同等重要的基础设施。**服务端需要判断哪些用户权重常驻 GPU、哪些放在 CPU 或对象存储、哪些可以合并,以及权重生成后能复用多久。对低频用户而言,重新生成权重可能比直接检索上下文更贵;对高频用户而言,缓存专属参数才可能摊薄成本。
**模型版本升级也会从替换文件变成状态迁移。**基础模型从一个版本升级到另一个版本后,旧动态权重未必还能兼容,因为层数、隐藏维度和内部表示可能变化。平台需要重新生成全部状态,或者训练跨版本转换器,这与数据库 Schema 迁移类似,但验证难度更高。
评估标准不能只看一次跑分
**Infinite-Parameter LLM 需要一套面向持续学习的评估体系。**传统基准测试通常给模型固定问题并计算准确率,却无法反映模型用了多久吸收新信息、是否污染旧能力,以及数据撤回后能否恢复原状。
值得重点关注的指标至少包括:
- **适配延迟:**从实时数据到可用动态权重需要多少毫秒或秒;
- **状态体积:**每个用户或任务需要保存多少 MB 参数;
- **推理额外开销:**动态权重让首 Token 延迟和每 Token 延迟增加多少;
- **保持率:**适应新任务后,基础能力和安全能力保留多少;
- **撤回效果:**删除指定数据后,与其相关的行为能否被定量消除;
- **污染鲁棒性:**少量恶意样本能否改变长期参数状态;
- **跨版本兼容性:**主干模型升级后,旧状态有多少可以继续使用;
- **证据可追踪性:**输出能否关联到产生当前权重的数据来源。
**论文中的单一准确率提升不足以证明这条路线可以进入生产环境。**开发者更应该查看端到端成本:生成权重需要多少计算,动态状态占用多少存储,批处理吞吐下降多少,以及故障后能否在分钟级回滚。只比较任务得分而忽略服务成本,很容易把研究原型误判为可部署产品。
判断:它更可能成为 RAG 的下一层,而不是替代 RAG
**Infinite-Parameter LLM 的方向值得重视,但“模型会自己进化”是过度解读。**当前讨论的核心仍是受控的参数生成与适配,生成范围、数据来源、更新频率和生命周期都需要由系统设计者规定;它并不意味着模型可以不受约束地重写全部能力。
**动态权重最合理的产品形态,是与 RAG、工具调用和长上下文组成分层记忆。**原始事实保存在数据库中,近期任务放在上下文里,稳定偏好被压缩为参数状态,关键操作仍通过外部工具执行。这样既能利用权重适配的效率,也保留事实证据和删除能力。
**这项工作真正挑战的是“模型等于一个固定文件”的工程假设。**过去部署 LLM 的基本单位是模型版本,未来可能变成基础模型、权重生成器、用户状态、数据谱系和安全策略的组合。模型不再只有一个检查点,而是一套随数据变化的计算状态。
**短期内,RAG 仍然是更新知识最便宜、可审计性最好的方案。**动态权重若要走出论文,至少需要证明三件事:它在相同准确率下比长上下文和 RAG 更省成本;它能可靠隔离和撤回实时数据;它不会用个性化适配换掉安全性和基础能力。
**长期看,实时生成权重可能成为智能体拥有长期记忆的一块关键拼图。**当模型能够把重复经验压缩进参数,同时把可核验事实保留在外部存储中,LLM 才可能从每次会话都近似“重新开机”的助手,变成真正连续运行、持续适应的系统。
参考来源
- Microsoft LoRA GitHub 仓库:LoRA 官方实现与论文资料,用于理解低秩权重更新及其参数、显存效率。
- Hugging Face PEFT GitHub 仓库:参数高效微调工具链,涵盖 LoRA、适配器等轻量权重方案。
- MiniMind GitHub 项目:从零训练小型语言模型的开源项目,可用于理解固定权重 LLM 的训练和推理流程。
- 大模型入行指南:介绍 LLM 动态适配、用户历史与个性化等基础背景。
注:本文讨论的 Infinite-Parameter LLM 论文编号为 arXiv:2609.18842。该研究截至 2026 年 9 月 17 日仍属于预印本阶段,实际性能、工程成本与安全结论仍需更多独立复现。