从零拆开DiffusionGemma
社区近日用PyTorch从零复现DiffusionGemma的并行文本生成机制。本文实现一个最小扩散语言模型,并拆解加噪训练、双向注意力、置信度解码与并行去噪。
社区开始从零复现DiffusionGemma,重点不是抄模型,而是拆生成范式
近日,Reddit 的 r/MachineLearning 社区出现了一份从零实现 DiffusionGemma 的 PyTorch 教程,核心目标不是加载 Google 已经训练好的权重,而是用尽可能少的代码复现其关键机制:先创建一整块被遮蔽的文本画布,再通过多轮前向传播并行恢复所有位置。
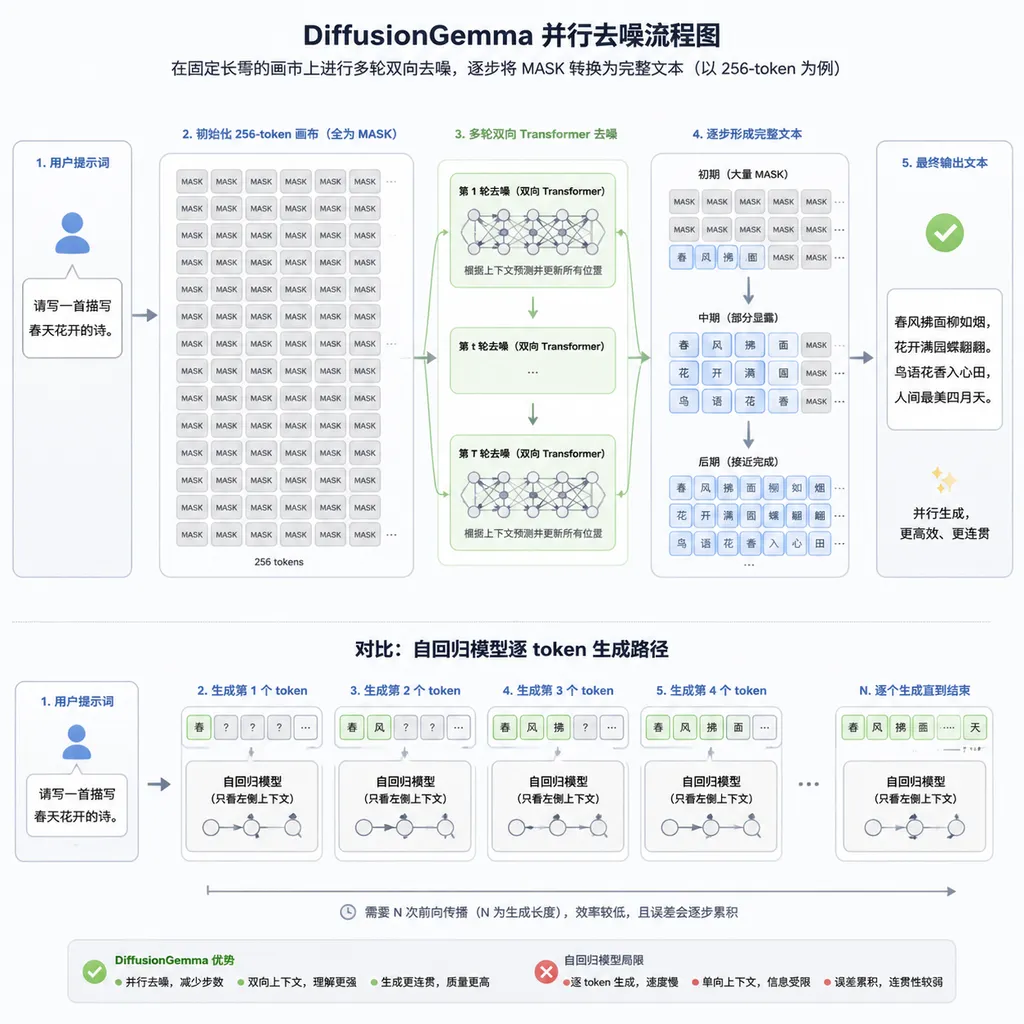
DiffusionGemma 是 Google DeepMind 推出的实验性文本扩散模型,它不按从左到右的顺序逐个生成 token,而是在一个固定长度的文本块上执行多轮并行去噪。
这件事值得开发者关注,因为 DiffusionGemma 发布几个月后,社区讨论的重心已经从“每秒能跑多少 token”转向更实际的问题:扩散语言模型究竟如何训练、为什么可以修改已经生成的内容,以及它的速度优势在什么条件下才能成立。
Google 开放的 DiffusionGemma 权重采用 26B MoE 架构,推理时激活参数约为 3.8B,一次处理最多 256 个待生成 token。公开资料给出的单卡速度通常超过 1000 tokens/s,部分经过蒸馏和特定硬件优化的测试达到约 1500 tokens/s;RTX 5090 上则有超过 700 tokens/s 的数据。不同数字对应不同精度、采样步数和推理框架,不能脱离测试环境直接比较。
这篇教程不会假装用一张消费级显卡重新训练一个 26B MoE 模型。我们要复现的是 DiffusionGemma 的“发动机”:离散加噪、双向 Transformer、掩码位置损失、置信度驱动的迭代解码,以及低置信度 token 的重新遮蔽。
先把边界说清楚:这里复现的是机制,不是官方权重
从零复现是指不调用现成的 DiffusionGemma 推理封装,自行实现训练目标和采样循环。
一个教学版模型与 Google 开放的完整模型至少存在四个数量级上的差异:参数规模、训练数据、MoE 路由、蒸馏与强化学习训练。社区实现可以验证并行生成是否成立,却不能复刻官方模型的知识量和基准成绩。
| 维度 | 本文最小复现 | DiffusionGemma 公开模型 | 常规自回归语言模型 | |---|---|---|---| | 生成方式 | 掩码扩散、多轮并行恢复 | 256-token 块级并行去噪 | 从左到右逐 token 生成 | | 注意力 | 块内双向注意力 | 提示词阶段与去噪阶段使用不同注意力模式 | 因果注意力 | | 模型结构 | 小型稠密 Transformer | 26B MoE,约 3.8B 激活参数 | 稠密或 MoE 均可 | | 训练目标 | 预测被遮蔽位置的原始 token | 扩散预训练、采样器蒸馏及后训练 | 下一 token 预测 | | 解码步数 | 通常为 8—64 步 | 由采样器和质量档位决定 | 输出 N 个 token 需要约 N 个串行步骤 | | 能否改写早期位置 | 可以 | 可以 | 已输出 token 通常不能回改 | | 适用目的 | 理解原理、验证采样策略 | 本地低延迟生成、代码编辑、研究 | 通用对话、复杂推理、云端批处理 |
这个区别非常重要。把一个双向 BERT 加上 [MASK] 循环,并不等于得到了 DiffusionGemma;但如果连最小实现都无法说清楚,所谓“扩散语言模型比自回归快四倍”也很容易退化为营销口号。
第一步:把文本扩散定义为离散遮蔽过程
离散文本扩散是向完整 token 序列逐步注入离散噪声,再训练模型恢复原始序列的过程。
图像扩散可以直接给像素添加高斯噪声,文本 token 却是离散编号。编号 1024 与编号 1025 在语义上不一定相近,因此不能简单地给 token ID 加一个小数。最容易实现、也最适合教学的方案,是把 [MASK] 当作吸收态噪声。
设干净文本为 $x_0$,时间步为 $t\in[0,1]$,遮蔽概率为 $q(t)$。每个位置独立执行:
- 以 $1-q(t)$ 的概率保留原 token;
- 以 $q(t)$ 的概率替换为
[MASK]; - 提示词、系统指令或其他条件 token 始终保持不变。
线性调度可以直接令 $q(t)=t$,余弦调度则会让训练样本更多地分布在中等噪声区域。教学实现先用线性调度,因为它更容易检查。
import torch

def corrupt_tokens(input_ids, mask_token_id, condition_mask=None):
    batch_size = input_ids.size(0)
    t = torch.rand(batch_size, 1, device=input_ids.device)
    noise_mask = torch.rand_like(input_ids.float()) < t

    if condition_mask is not None:
        noise_mask &= ~condition_mask

    noisy_ids = input_ids.clone()
    noisy_ids[noise_mask] = mask_token_id
    return noisy_ids, noise_mask, t
这里的 condition_mask 用于标记不能被破坏的提示词区域。没有这个约束,模型会同时尝试重建问题和答案,训练目标就从“条件生成”滑向了无条件文本恢复。
真正训练时还应排除 padding、BOS、EOS 等特殊 token,并控制全遮蔽与低遮蔽样本的比例。否则模型可能只擅长修补少量空缺,却不会从一整块 [MASK] 中生成答案。
第二步:拿掉因果遮罩,让每个位置看见整张画布
双向注意力是允许一个待生成位置同时读取左侧和右侧上下文的注意力机制。
自回归模型必须使用上三角因果遮罩,位置 $i$ 只能看见 $0$ 到 $i$ 的内容。扩散语言模型面对的却是一张同时变化的画布:第 20 个位置可能已经确定,第 10 个位置仍是 [MASK],第 5 个位置还可能在下一轮被推翻。
因此,去噪阶段不能沿用严格的因果遮罩。一个最小双向 Transformer 可以写成下面这样:
import torch.nn as nn

class TinyDiffusionLM(nn.Module):
    def __init__(self, vocab_size, dim=512, layers=8,
                 heads=8, max_length=256):
        super().__init__()
        self.token_embedding = nn.Embedding(vocab_size, dim)
        self.position_embedding = nn.Embedding(max_length, dim)

        block = nn.TransformerEncoderLayer(
            d_model=dim,
            nhead=heads,
            dim_feedforward=dim * 4,
            dropout=0.0,
            activation="gelu",
            batch_first=True,
            norm_first=True,
        )
        self.transformer = nn.TransformerEncoder(block, layers)
        self.norm = nn.LayerNorm(dim)
        self.lm_head = nn.Linear(dim, vocab_size, bias=False)

    def forward(self, input_ids, padding_mask=None):
        positions = torch.arange(
            input_ids.size(1), device=input_ids.device
        )[None, :]
        hidden = (
            self.token_embedding(input_ids)
            + self.position_embedding(positions)
        )
        hidden = self.transformer(
            hidden,
            src_key_padding_mask=padding_mask,
        )
        return self.lm_head(self.norm(hidden))
这段实现没有传入因果 attention mask,所以同一个块里的 token 可以彼此观察。它仍然只是机制演示:完整 DiffusionGemma 还涉及 MoE 层、旋转位置编码、提示词预填充、KV Cache、块级生成以及更复杂的注意力切换。
尤其需要注意,双向注意力不能直接复用普通自回归解码的全部 KV Cache。因为画布在每一轮都会改变,过去缓存的表示可能已经失效。官方模型通过把稳定的提示词前缀和正在去噪的文本块分开处理,减少重复计算;如果把整段序列每轮重算,教学代码能运行,但很难得到公开演示中的速度。
第三步:损失只计算被破坏的位置
去噪损失是让模型根据未被破坏的上下文,预测噪声位置原始 token 的交叉熵损失。
最直接的训练方式,是只在 noise_mask=True 的位置计算交叉熵:
import torch.nn.functional as F

def diffusion_loss(model, clean_ids, mask_token_id,
                   condition_mask=None, padding_mask=None):
    noisy_ids, noise_mask, _ = corrupt_tokens(
        clean_ids,
        mask_token_id,
        condition_mask=condition_mask,
    )

    if padding_mask is not None:
        noise_mask &= ~padding_mask

    logits = model(noisy_ids, padding_mask=padding_mask)
    loss = F.cross_entropy(
        logits[noise_mask],
        clean_ids[noise_mask],
    )
    return loss
只监督被遮蔽位置有两个好处。第一,模型不会把大量容量浪费在复制本来就可见的 token 上;第二,训练目标与推理任务一致——推理时真正需要解决的也是“这些空位应该填什么”。
不过,生产级训练不会停留在均匀采样时间步和朴素交叉熵上。DiffusionGemma 后续公开资料提到,模型改造所需训练 token 少于基础模型原始训练预算的 10%,并通过强化学习与采样器蒸馏压缩去噪步数。采样器蒸馏的价值很直接:如果一个模型必须迭代 128 次才能完成 256 token,它未必比执行 256 次轻量自回归步骤更快;如果能压缩到 16 次或更少,并行优势才会真正释放。
第四步:一次预测所有空位,但不要一次相信所有预测
置信度解码是每轮同时预测全部遮蔽位置,只接受其中最可信的一部分,并把剩余位置留给后续轮次。
这是最容易被误解的一环。所谓“并行生成 256 个 token”,不等于一次前向传播就无条件确定 256 个最终 token。模型会在一次前向传播中为所有位置产生词表分布,但采样器通常只固定高置信度位置。
假设第一轮有 256 个 [MASK]:
- 模型并行预测 256 个位置;
- 选出置信度最高的约 16—32 个位置;
- 将这些位置写入画布;
- 其余位置继续保持
[MASK]; - 下一轮利用新增上下文再次预测整块内容。
一个简化版解码器如下:
@torch.no_grad()
def generate(model, prompt_ids, output_length, mask_token_id,
             steps=16, temperature=1.0):
    device = prompt_ids.device
    batch_size = prompt_ids.size(0)

    canvas = torch.full(
        (batch_size, output_length),
        mask_token_id,
        dtype=torch.long,
        device=device,
    )
    tokens = torch.cat([prompt_ids, canvas], dim=1)
    prompt_length = prompt_ids.size(1)

    for step in range(steps):
        logits = model(tokens)[:, prompt_length:, :]
        probs = (logits / temperature).softmax(dim=-1)
        confidence, candidates = probs.max(dim=-1)

        unresolved = tokens[:, prompt_length:] == mask_token_id
        confidence = confidence.masked_fill(~unresolved, -1.0)

        remaining_steps = steps - step
        unresolved_count = unresolved.sum(dim=1)
        reveal_count = torch.ceil(
            unresolved_count.float() / remaining_steps
        ).long()

        for batch_index in range(batch_size):
            k = min(
                reveal_count[batch_index].item(),
                unresolved_count[batch_index].item(),
            )
            if k == 0:
                continue

            chosen = confidence[batch_index].topk(k).indices
            target = tokens[batch_index, prompt_length:]
            target[chosen] = candidates[batch_index, chosen]

    return tokens[:, prompt_length:]
这段代码体现了并行文本扩散的核心,却仍有三个明显简化。
第一,它使用贪心候选而不是随机采样,因此输出多样性较弱。实际采样器会结合 temperature、top-k 或 Gumbel 噪声。
第二,它只会逐步揭示 token,不会重新遮蔽已经确定的位置。DiffusionGemma 更有价值的能力之一,是把后来被判断为低置信度的 token 再次变成噪声,从而修改早期答案。
第三,它采用线性揭示进度。更有效的调度通常前期谨慎、后期加速,或者根据整块置信度动态决定每一轮固定多少位置。
加上重新遮蔽,模型才真正拥有“反悔权”
重新遮蔽是将低置信度或与全局约束冲突的 token 恢复为噪声,让模型在后续步骤中重新预测。
自回归模型一旦输出了错误变量名、JSON 左括号或推理结论,只能在后文补救,不能直接修改已输出内容。扩散模型则可以在画布尚未提交前反复编辑。
例如模型第一轮得到:
The result is -1 because 5 × 5 = 25 ...
后续位置逐渐确定后,模型发现结论与推导冲突,便可以把 -1 重新遮蔽,再恢复为 -25。这不是模型像人一样进行了显式反思,而是双向上下文改变了该位置的条件概率。
工程上可以保存每个已揭示 token 的置信度,并在每轮结束时把最低的一小部分重新设为 [MASK]。但重遮蔽比例不能太高:比例为 0 时没有纠错能力,比例过高则会在多个候选之间震荡,出现重复词或无法收敛。
为什么并行生成可能更快:少搬权重,多做矩阵计算
扩散语言模型的速度优势来自把单 token 的串行访存任务,改造成多 token 的并行计算任务。
单用户运行自回归模型时,每生成一个 token,GPU 都要读取模型权重和 KV Cache,再完成一次规模较小的矩阵计算。现代 GPU 的算力增长速度通常快于显存带宽增长速度,因此很多计算单元实际上在等待数据。
DiffusionGemma 一次处理 256 个待生成位置,可以把矩阵乘法做得更“厚”,提高 Tensor Core 利用率。它并没有消灭计算,而是把瓶颈从内存带宽转向计算吞吐。
| 场景 | 自回归模型 | 扩散语言模型 | 更可能占优的一方 | |---|---|---|---| | 单用户生成 256 token | 约 256 个串行解码步骤 | 约 8—32 个整块去噪步骤 | 扩散模型 | | 只生成 1—5 token | KV Cache 可直接续写 | 仍需建立画布并迭代 | 自回归模型 | | 32 个以上并发请求 | 可通过连续批处理提高吞吐 | 每个请求都占用较大去噪块 | 自回归模型可能反超 | | 代码中间填空 | 需要专用 FIM 训练 | 天然可看左右两侧 | 扩散模型 | | 严格流式输出 | token 生成后立即展示 | 通常需等待整块逐渐收敛 | 自回归模型 | | 本地隐私工作流 | 易受显存带宽限制 | 可提高单请求 GPU 利用率 | 扩散模型 |
因此,“快四倍”不是普遍定律。它更准确的表述是:在合适硬件、较长输出、较低并发和较少去噪步数下,DiffusionGemma 的单请求生成速度可达到同级自回归模型的约 3—4 倍。
复现实验应该测什么,而不是只看 tokens/s
一个有效的扩散语言模型实验必须同时测量速度、质量、收敛率和每步揭示数量。
建议至少记录以下指标:
- 端到端延迟:从输入提示词到完整文本可用,而不是只统计最后一轮计算速度。
- 有效 tokens/s:最终非 padding token 数除以总时间,不能把每轮反复处理的 token 重复计数。
- 去噪步数:分别测试 8、16、32、64 步,观察质量与延迟曲线。
- 重复率:统计连续重复词、重复短语和循环段落。
- 格式成功率:对 JSON、代码块或固定模板进行解析验证。
- 重遮蔽比例:记录每轮被推翻的 token 数量,判断模型是否稳定收敛。
- 不同输出长度:比较 32、128、256 token,确认并行优势从哪个长度开始出现。
如果只测模型每秒处理了多少位置,扩散模型会天然占便宜,因为同一位置可能在 16 轮里被计算 16 次。真正有意义的是每秒最终提交了多少可靠 token。
训练数据也会决定实验是否成功。一个小模型如果只在普通自然语言上训练,很可能学会局部填词,却学不会从全遮蔽画布中规划长答案。实践中应混合不同噪声强度,并加入代码填空、句子重排、结构化文本恢复和完整答案生成等样本。
最容易踩的五个坑
扩散语言模型复现失败,通常不是 Transformer 写错了,而是训练分布与采样过程不匹配。
- 训练时只遮蔽少量 token:模型会成为普通完形填空器,推理面对 100% 遮蔽画布时直接崩溃。
- 所有位置同时解锁:第一轮的低质量预测会被永久固定,并行生成退化为“一次性乱猜”。
- 仍然使用因果遮罩:右侧 token 无法帮助左侧去噪,双向纠错能力消失。
- 不处理可变长度:固定 256 token 容易生成多余内容,需要 EOS 预测、长度模型或块级终止策略。
- 把训练吞吐当成生成速度:一次并行处理 256 个 token 不代表最终每次前向传播都新增 256 个可靠 token。
还有一个更隐蔽的问题:扩散文本不是天然流式的。自回归模型可以生成一个 token 就显示一个 token,扩散模型的画布在收敛前可能反复变化。如果产品界面过早展示中间结果,用户会看到词语跳动和句子回改。更合理的做法是按稳定度提交局部片段,或者以 32—64 token 为小块逐步展示。
DiffusionGemma现在更像研究底座,而不是通用替代品
DiffusionGemma 的现实定位是低延迟、低并发和非线性编辑任务的实验性底座。
它的优势很明确:并行生成能够提高单卡单请求利用率;双向注意力适合代码填空、局部改写和结构化输出;重新遮蔽允许模型在最终提交前纠正早期位置;26B MoE 配合量化后约 18GB 的显存需求,也把实验门槛压到了高端消费级显卡范围。
它的限制同样不能回避。公开资料显示,DiffusionGemma 的整体质量仍落后于自回归版 Gemma 4,在复杂科学推理和综合推理任务上的差距尤其明显。采样步骤压得太少时,还可能出现重复词、格式未闭合和局部循环。并发上升到约 32 个请求后,自回归模型通过连续批处理获得的吞吐优势也可能重新显现。
真正值得关注的不是它会不会在一年内替代 GPT 式生成,而是语言模型的解码方式终于不再只有一条路。未来的产品很可能采用混合架构:长链推理由自回归模型完成,代码填空和结构化修复交给扩散模型,极短输出走传统 KV Cache,长文本块则使用并行去噪。
这次社区从零复现的价值也正在于此。不到完整模型万分之一的训练成本,就能观察 token 如何从整块噪声中逐渐浮现、错误位置如何被推翻、采样步数如何改变速度与质量。对于研究者和推理框架开发者,这比再封装一次聊天界面更有信息量。
结论:先复现采样循环,再谈四倍加速
从零理解 DiffusionGemma 的最短路径,是先实现遮蔽扩散、双向注意力和置信度解码,再逐步加入重遮蔽、蒸馏与块级缓存。
一个最小可行实验不需要 26B 参数:使用 50M—300M 参数的小型 Transformer、固定 128 或 256 token 画布、16—32 个去噪步骤,就足以验证并行生成是否收敛。随后再比较不同调度器、解锁策略和重遮蔽比例,通常比直接下载完整权重更容易理解模型行为。
DiffusionGemma 目前还没有证明扩散范式能全面取代自回归模型,但它已经证明另一件事:文本生成不必永远排成一条单向队列。对本地代码助手、行内编辑器和低延迟结构化生成而言,这条路线已经具备现实工程价值。
参考来源
- Reddit:DiffusionGemma 如何并行生成文本的 PyTorch 从零实现:本次社区复现讨论的来源,聚焦扩散语言模型的最小实现和并行去噪过程。
- Hugging Face:Google DiffusionGemma 26B A4B IT:Google 发布的模型仓库,可查看模型卡、权重信息、许可证与运行说明。
- 掘金:DiffusionGemma 文本生成速度与技术原理解析:中文资料,对模型规格、硬件速度、基准成绩和适用场景进行了整理。