AI重返1900年,抢跑爱因斯坦
Nature近期研究把AI限制在1900年的知识边界内,要求其重新推导光量子理论。结果显示,AI能够组合历史证据提出接近爱因斯坦的假说,但距离真正自主发现新物理仍有关键差距。
AI被送回1900年,重新走了一遍量子革命
截至2026年9月19日,Nature近期披露的一项研究完成了一场颇具野心的思想实验:研究人员把AI能够接触的科学材料限制在1900年前后,要求它仅凭当时已有的黑体辐射、热力学与电磁学知识,尝试解释经典物理无法处理的辐射问题。
这项实验最引人关注的结果,是AI提出了接近爱因斯坦光量子假说的解释,而且理论出发点停留在1900年的知识边界内。
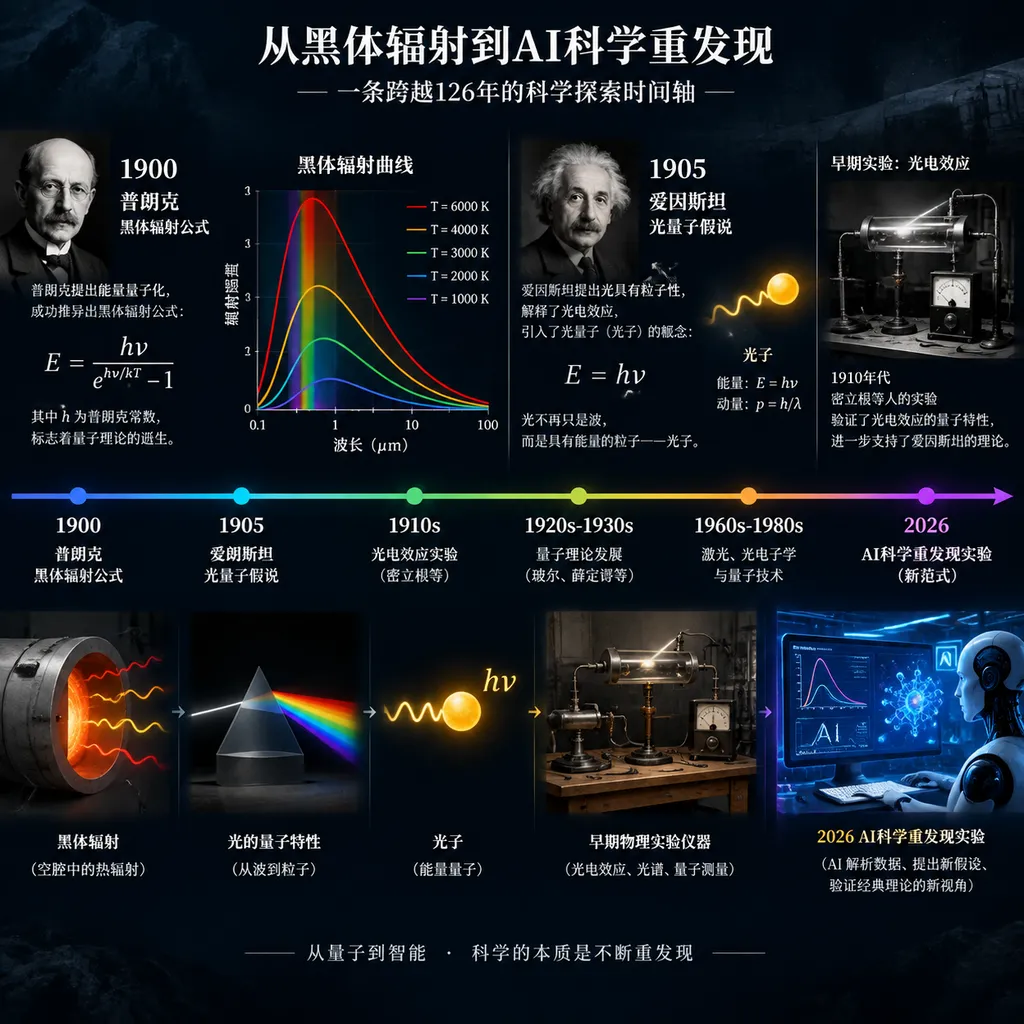
光量子假说是指:光的能量并非只能以连续电磁波的形式传播,而可以集中在一个个离散能量包中,每个能量包的能量与频率成正比,即 E = hν。爱因斯坦在1905年正式提出这一假说,并用它解释光电效应,后来这些能量包被称为“光子”。
这意味着,AI在模拟实验中尝试跨过了从“物质以离散方式交换能量”到“光本身也可能由离散能量单元组成”的关键一步。历史上,连普朗克本人都没有立刻接受后一个结论。
1900年到底卡住了什么
“1900年知识边界”是一种历史约束实验,指AI只能使用某一历史节点之前公开存在的数据、论文、理论和实验事实,不能直接调用后世答案。
选择1900年并不是为了制造戏剧效果,而是因为这一年正处在经典物理与量子理论的断裂点上。
19世纪末,麦克斯韦电磁理论、牛顿力学和热力学已经建立了相当完整的物理图景,但黑体辐射成为这套体系无法绕开的漏洞。按照经典统计物理推导,频率越高,可容纳的电磁模式越多,辐射能量会在紫外波段无限增长,这就是后来被称为“紫外灾难”的问题。
实验结果显然没有出现无穷大的紫外辐射。
普朗克在1900年提出,物质中的振子不能连续地吸收或释放任意大小的能量,而必须以 hν 为基本单位进行交换,其能量可写成 E = nhν。这个处理成功拟合了黑体辐射数据,也成为量子理论的起点。
普朗克量子化的是物质与辐射交换能量的过程,而爱因斯坦随后量子化的是光本身。
两者之间看似只隔着半步,实际上是一次巨大的本体论跳跃。普朗克最初更倾向于把量子化视为数学手段,并未认为空间中的光真的被切成一个个粒子。爱因斯坦则主张,在特定情形下,光应当表现为具有局域能量的独立量子。
这一步在当时并不讨巧。麦克斯韦方程已经用波动形式极其成功地解释干涉、衍射和偏振,要求物理学家重新接受某种“光粒子”,几乎相当于对成熟理论发动正面攻击。包括密立坎和波耳在内的一批物理学家,都曾长期反对或怀疑光量子概念。
AI完成的不是公式拟合,而是概念改写
这项研究真正值得重视的地方,不是AI又拟合出了一条曲线,而是它尝试改变解释数据时使用的基本概念。
一般的机器学习系统很擅长预测。如果给模型大量频率、温度和辐射强度数据,它可以训练出误差很小的函数,但一个预测准确的黑箱并不等于科学理论。科学发现要求系统回答的不只是“下一个数据点是多少”,还包括“世界为什么按照这种方式运行”。
符号回归是从观测数据中自动搜索简洁数学表达式的方法,它可以在候选运算符、变量和常数之间寻找类似物理定律的公式。近年来的AI Feynman、PySR以及北京大学团队开发的AI-Newton,都在尝试让机器从数据中恢复可解释规律。
不过,光量子问题比恢复 F = ma 更难。
牛顿第二定律可以通过质量、加速度与受力数据之间的稳定关系得到验证;光量子假说却要求系统对“辐射是什么”作出新的解释。它不只是在既有变量之间寻找等式,而是引入了经典理论中不存在的对象。
从公开材料呈现的实验逻辑看,AI需要完成的推理链条至少包括四步:
- 识别经典理论与实验之间的冲突。 高频辐射的经典预测不能同时满足热力学与实际观测。
- 接受能量交换存在最小单位。 普朗克关系中的 hν 不能只被当成无意义的拟合参数。
- 把离散性从振子扩展到辐射。 能量量子可能不是物质交换能量时才出现,而是光自身的属性。
- 给出可检验的后果。 如果单个光量子的能量为 hν,那么辐射与物质相互作用时,频率应当比总光强更直接地决定单次能量转移。
第四步尤其关键。爱因斯坦后来用 K_max = hν - φ 描述光电效应中逸出电子的最大动能,其中 φ 是材料逸出功。该关系意味着,提高光强主要增加电子数量,提高频率则可以增加单个电子获得的最大能量。
如果AI只是复述 E = hν,它更像在背答案;如果它能从历史数据提出可证伪的新预测,才开始接近科学发现。
这次“重发现”处在什么水平
AI科学发现可以分成知识复述、受约束重建和开放式发现三个层次,而这项研究最多证明了第二层已经具备可行性。
| 能力层次 | 输入条件 | AI要完成的任务 | 当前可信度 | |---|---|---|---| | 知识复述 | 可访问现代教材与论文 | 复述光量子理论及标准推导 | 已是大模型基础能力 | | 受约束重建 | 只提供1900年前后的材料 | 从历史矛盾中重建接近后世理论的解释 | 本次研究重点,具有研究价值 | | 开放式发现 | 没有已知标准答案 | 发现人类尚未知晓的规律并提出实验验证 | 尚未得到证明 |
受约束重建仍然有价值,因为它比考试式问答更接近真实科研。研究者可以观察AI是否会识别反常数据、是否倾向于保留旧理论、何时引入新概念,以及能否把假说转化为实验预测。
但“AI抢先爱因斯坦”的说法必须谨慎理解。
限制检索材料不等于删除模型参数中的现代知识。 如果实验使用的是经过现代互联网和教科书训练的大语言模型,那么“光量子”“黑体辐射”和“爱因斯坦”之间的联系很可能早已编码在模型权重中。即使提示词规定它只能引用1900年前的资料,模型也可能在不直接说出记忆来源的情况下,被现代答案引导。
这也是历史知识边界实验最难排除的变量。
一个更严格的验证方案,应当至少包含以下控制组:
- 使用从未出现在公开教材中的人工物理世界,检查AI能否发现结构相似但表述完全不同的规律;
- 替换变量名称、单位和历史人物,削弱关键词对记忆的触发;
- 故意加入与真实历史不同但内部自洽的实验数据,观察AI是服从数据还是坚持教材答案;
- 记录每一轮假说生成、证据引用、反驳和修正过程,而不是只评判最终结论;
- 让独立模型或人类专家进行盲审,判断理论是否真的由给定证据支持;
- 要求系统设计新的区分性实验,并在未公开的数据上验证预测。
如果模型面对一个“光量子不成立”的合成宇宙,仍然执意输出 E = hν,那么实验测到的就不是科学推理能力,而是训练语料的惯性。
与符号回归相比,它跨过了哪一步
传统符号回归寻找的是方程,历史知识约束下的AI科学家寻找的则是方程背后的解释框架。
两者的差异可以用下表概括:
| 维度 | 符号回归系统 | 历史约束AI科学家 | 人类理论物理学家 | |---|---|---|---| | 主要输入 | 结构化数值数据 | 数据、历史论文、理论与争论 | 数据、理论、直觉和实验经验 | | 主要输出 | 简洁数学表达式 | 假说、推理链和可能的预测 | 新概念、数学体系与实验方案 | | 优势 | 搜索速度快、结果可计算 | 能综合异构文本和多种证据 | 能定义问题并判断研究价值 | | 主要风险 | 过拟合、维度错误、伪相关 | 记忆泄漏、幻觉、事后合理化 | 认知偏见、试错成本高 | | 是否能提出新实体 | 通常较弱 | 理论上可以,但难验证 | 历史上多次做到 |
符号回归系统通常需要人类先决定测量什么、把哪些变量交给模型,并指定可用的数学运算。AI即使成功恢复一条定律,也可能是在一个由人类精心搭建的搜索空间中完成组合优化。
此次光量子重建更进一步,因为模型面对的是彼此冲突的理论描述和实验事实。它必须判断哪些假设可以放弃,哪些原则应该保留,以及一个数学常数是否对应新的物理实在。
从“发现公式”走向“发明概念”,是AI进入基础科学研究必须跨过的门槛。
不过,目前公开信息还不足以证明系统已经稳定跨过这道门槛。研究是否使用多个模型、成功率是多少、不同随机运行会不会得到相同结论、模型是否能在反事实数据上改变观点,这些指标比一次漂亮的演示更重要。
在缺少完整复现实验和消融结果时,最稳妥的判断是:这项工作证明了AI能够模拟一部分理论形成过程,但尚未证明AI拥有与爱因斯坦相当的原创能力。
下一站会是相对论吗
光量子重建成功,并不意味着AI已经能够在同样条件下提出相对论。
狭义相对论是建立在相对性原理与光速不变基础上的时空理论。1905年前,人类已经拥有麦克斯韦方程、1887年的迈克耳孙—莫雷实验、洛伦兹变换以及同时性问题等关键线索,因此它在形式上适合成为下一轮历史重发现测试。
但相对论要求的抽象层次更高。系统不仅要拟合物体运动,还要意识到绝对时间本身可能有问题,并重新定义同时性、长度和时间间隔。这里发生变化的不是某种物质对象,而是测量事件所依赖的时空框架。
广义相对论则更加困难。它需要从等效原理出发,把引力理解为时空几何,并利用黎曼几何、张量分析和协变性构建场方程。若知识边界严格停留在1900年,模型甚至拿不到爱因斯坦1907年的等效原理以及后来成熟的数学与观测线索。
因此,“只给1911年前的数据,让AI推出广义相对论”听起来刺激,却不是一个公平的单步测试。更合理的实验应当把任务拆成问题识别、思想实验、数学工具选择、候选理论生成、极限情况检验和观测预测等多个阶段。
相对论测试真正有价值的指标,不是AI最后有没有写出正确方程,而是它能否解释为什么牛顿引力在低速弱场下成立、为什么理论必须满足坐标变换要求,以及哪些观测能够区分新旧理论。
如果模型只是直接给出爱因斯坦场方程,它很可能是在调用记忆;如果它从水星近日点进动、光线偏折和等效原理逐步构造理论,并主动提出可验证预测,才更接近真正的重发现。
AI科学家的价值,不是替人类重复历史
历史重发现实验的最终目的不是让AI与已故科学家比赛,而是建立一套可评估的科学推理基准。
现实中的前沿科研没有标准答案,也不会有人提前告诉AI哪一条异常数据通向新理论。模型必须自行判断哪些问题值得研究、哪些数据不可靠、应该追加什么实验,以及一个复杂解释是否真的优于简单解释。
当前AI系统最明显的短板,仍然是“提出正确问题”的能力。它们可以快速阅读文献、枚举假说、寻找公式和生成实验建议,却容易把语言上的连贯误认为证据上的充分,也缺乏对实验成本、测量误差和仪器限制的长期认识。
这项Nature研究的意义,在于把评价标准从“模型记住了多少科学知识”推进到“模型能否在受限证据下形成理论”。它比单纯做物理题更接近科研,也比宣称AI已经成为科学家克制得多。
我们的判断是:AI目前可以成为高吞吐量的假说生成器和理论审稿人,但还不能独立承担科学发现的最终责任。
它最适合做的事情,是同时探索大量人类来不及检查的候选解释,快速排除维度不一致、违反守恒律或与数据冲突的方案,再把少数值得验证的方向交给研究者。真正决定理论是否成立的,仍然是可重复实验、独立验证和对未知现象的预测。
AI在1900年的世界里“发现”光量子,是一个令人兴奋的压力测试;AI能否在2026年的世界里提出一个人类尚不知道、且经实验验证成立的理论,才是下一道真正的分界线。
参考来源
- Nature同日两篇AI科研论文梳理:介绍AI参与文献分析、科研推理与实验验证的相关Nature研究,可作为理解AI科学发现能力边界的补充材料。
- PySR GitHub仓库:开源符号回归工具,用于从数据中搜索可解释数学表达式,是理解AI自动发现物理规律的重要技术背景。
- AI Feynman GitHub仓库:面向物理启发式符号回归的开源实现,展示机器从数据恢复解析方程的一条代表性路线。