PAW:把英文描述编译成神经函数
滑铁卢大学团队推出 ProgramAsWeights,可将英文函数描述编译为本地神经程序。它试图在规则代码与在线大模型之间,建立一种可复用、低成本的“模糊函数”。
英文写函数,本地跑推理
ProgramAsWeights 正在尝试把自然语言提示词变成可以反复调用的本地神经函数。 近期,来自滑铁卢大学的研究团队公开了 ProgramAsWeights,简称 PAW:开发者用英文描述一个函数要完成的任务,系统先把描述编译成一份紧凑的神经程序,随后便能像调用普通 Python 函数一样,在本地设备上处理新输入。
PAW 的核心变化是把“理解任务”和“执行任务”拆成两个阶段。 以邮件分类为例,开发者只需描述“判断一封邮件是否需要立即处理”,编译器负责理解这项要求并生成任务专用权重;此后,每一封新邮件都由本地运行时和这份权重处理,不必再次把提示词与邮件内容发送给大型语言模型。
这不是把英文编译成传统源代码,而是把函数语义编译进神经网络权重。 PAW 生成的产物不会变成一组容易阅读的 if-else 语句,也不是 Python AST、WebAssembly 或原生机器码,而是一份需要轻量运行时解释执行的神经产物。论文把这种模式称为“模糊函数编程”(fuzzy-function programming)。
模糊函数是指难以用精确规则穷举、但人类可以用自然语言说明判断标准的函数。 “订单金额大于 1000 元”适合写成确定性代码,“判断这条客服消息是否带有强烈不满情绪”则很难列完所有表达方式。PAW 瞄准的正是后者,而不是替代计算税率、校验日期或排序数组等传统程序。
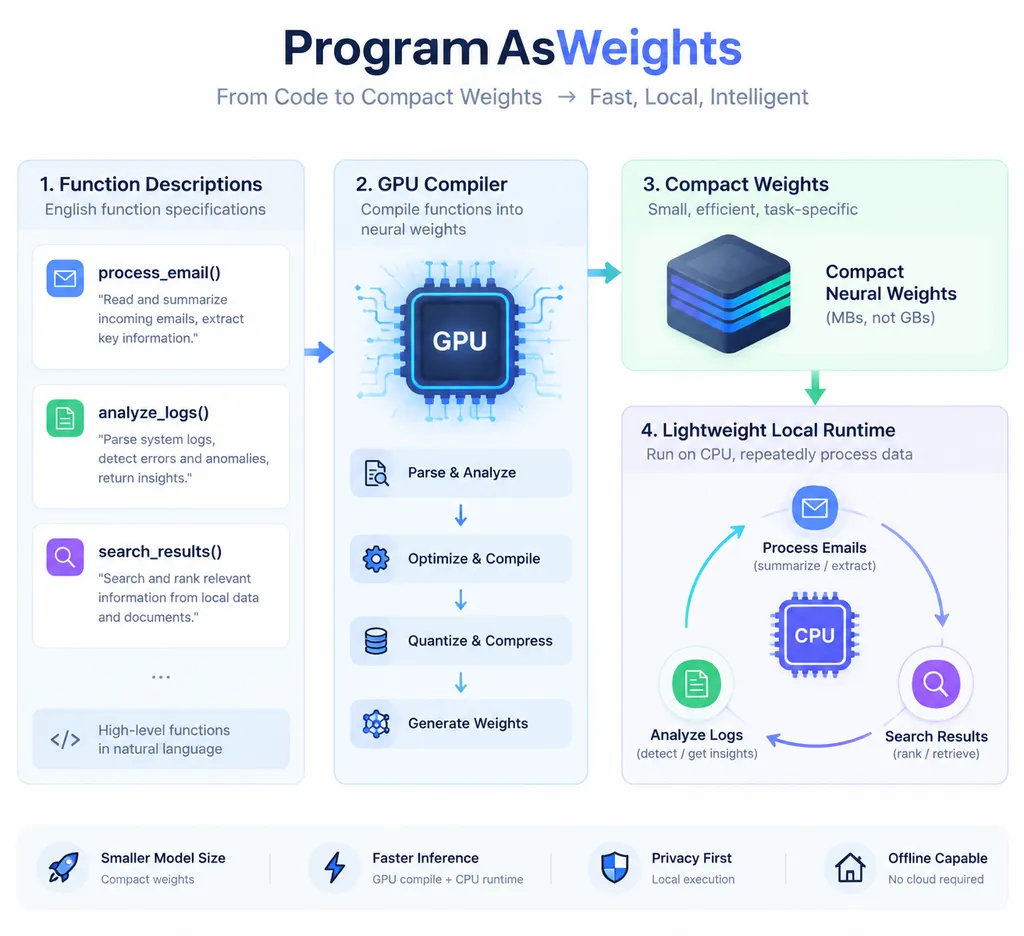
“编译一次、执行多次”是 PAW 最有价值的设计
PAW 最值得关注的地方不是自然语言编程,而是把大模型从在线执行者变成了一次性的工具制造者。 目前多数 AI 应用采用“输入数据—拼接提示词—调用大模型—返回结果”的路径,即使任务定义长期不变,大模型也要在每次请求中重新阅读并理解同一套指令。
PAW 将这条链路改写为“函数描述—编译器模型—专用权重—本地执行”。 它把成本更高的语义理解放在编译阶段,再把高频执行交给紧凑权重和本地解释器。用研究团队给出的场景来说,开发者定义一次“识别紧急邮件”,之后可以把同一个函数用于成百上千封邮件。
其逻辑可以简化为:
传统大模型应用:
每次输入 → 提示词 + 大模型 → 输出

ProgramAsWeights:
英文函数描述 → 编译器模型 → 紧凑神经权重
新输入 + 紧凑权重 + 本地运行时 → 输出
这种架构适合任务固定、输入持续变化的应用。 邮件优先级判断、日志异常筛选、搜索结果意图排序、非标准 JSON 修复、内容标签分类以及游戏角色动作映射,都具有同一个特点:判断边界包含语义和经验,很难完全规则化,但函数目标本身不会随着每次输入发生变化。
PAW 对隐私的改善发生在编译之后,而不是贯穿整个生命周期。 使用官方托管编译器时,函数描述仍需要被发送到远端进行编译;下载神经程序和本地运行时后,后续业务输入才可以留在设备上。拥有 GPU 的团队也可以使用项目释放的模型权重自行部署编译器,从而让函数描述和推理数据都不离开内部环境。
“可以在 CPU 上运行”意味着 PAW 不要求用户在每台终端部署完整的大模型。 这与直接在笔记本上运行一个数十亿参数模型不是同一条路线:PAW 试图只保留完成特定任务所需的行为,而不是把聊天、写作、编码和知识问答能力全部塞进终端。
不过,截至 2026 年 9 月 20 日,项目公开资料尚未给出覆盖不同硬件的统一延迟、吞吐量、内存占用和能耗数据,也没有公布适用于所有任务的固定压缩比例。因此,“tiny neural programs”目前更应该理解为项目的架构目标,不能直接等同于某个确定的文件大小或性能承诺。
它填补的是规则代码与完整大模型之间的空档
PAW 想建立一种介于确定性程序和实时大模型调用之间的新软件构件。 传统代码便宜、快速、可审计,但不擅长模糊语义;在线大模型理解能力强,却需要在每次调用时支付推理成本,并带来网络依赖、数据边界和服务稳定性问题。
| 方案 | 任务定义方式 | 执行位置 | 重复执行成本 | 可解释性 | 适合场景 | |---|---|---|---|---|---| | 传统规则代码 | 条件、正则、算法 | 本地或服务器 | 通常最低 | 高 | 边界清晰、结果必须确定的任务 | | 在线大模型 | 每次请求携带提示词 | 云端模型服务 | 随调用次数持续增加 | 较低 | 任务变化快、需要通用推理的场景 | | 本地小模型 | 提示词或微调 | 用户 GPU/CPU | 无远程调用费,但模型常驻成本较高 | 较低 | 多任务离线助手、隐私敏感应用 | | LoRA/任务微调 | 数据集与训练流程 | 依赖基础模型运行 | 训练门槛较高,仍需加载基础模型 | 较低 | 有数据、有算力的稳定垂直任务 | | PAW 神经程序 | 一段英文函数描述 | 编译后本地执行 | 编译一次,后续重复使用 | 较低 | 固定、高频、带模糊语义的窄任务 |
PAW 与提示词缓存的差别在于,它试图减少对完整基础模型的持续依赖。 提示词缓存可以省去部分重复计算,但每次请求通常仍要进入远端大模型;PAW 则把任务行为固化为本地权重,运行阶段原则上不再需要连接编译器或通用模型。
PAW 与模型蒸馏的目标相似,但开发体验不同。 蒸馏通常需要教师模型输出、训练数据、损失函数和训练流程,PAW 希望把这些过程隐藏在“编译”抽象之后,让开发者从自然语言规格直接获得函数产物。当然,这种易用性并没有消除训练和模型生成的复杂度,只是把它们集中到了编译器一侧。
PAW 与 LoRA 也不是同一种轻量化方案。 LoRA 通常保存一组低秩适配参数,但运行时仍需要加载对应的基础模型;PAW 描述的是任务专用权重与轻量解释器的组合,目标是让窄函数摆脱完整大模型。两者最终的文件体积、精度和延迟仍需要在相同任务与硬件上实测,不能仅凭“权重更小”下结论。
真正的优势不是本地聊天,而是本地行为
PAW 比“在电脑上跑一个聊天模型”更贴近普通软件的调用习惯。 应用程序通常不需要一个随时聊天的智能体,而是需要稳定回答某个问题的组件,例如“这条告警是否重要”“这个搜索结果是否符合购买意图”“这个动作描述对应哪个动画片段”。
任务越窄、调用越频繁,编译式神经函数的经济性就越明显。 如果一个函数只运行三次,编译过程未必值得;如果同一规则每天处理数万条日志、邮件或用户反馈,把语义理解成本从每次执行前移到一次编译,就可能同时降低网络请求、远程推理和尾部延迟带来的负担。
离线能力也让 PAW 有机会进入云端模型不容易覆盖的环境。 企业内网、桌面软件、边缘网关、游戏客户端和断网设备都可能需要语义判断,但不一定允许持续上传原始数据。只要编译后的程序体积和资源占用足够低,PAW 就能把部分 AI 能力封装成随应用分发的本地组件。
版本固定是神经程序相较实时模型服务的另一个潜在优势。 云端模型可能在服务方升级后出现行为漂移,而下载到本地的函数权重可以与应用版本一起锁定、测试和回滚。这并不意味着输出一定完全确定,但至少开发团队能够明确记录“哪一版权重、哪一版运行时产生了结果”。
目前最大的风险仍然是:它看起来像函数,但未必像函数一样可靠
PAW 的产品界面借用了函数抽象,但神经网络不会自动获得传统函数的确定性保证。 一个普通函数通常拥有明确的输入类型、输出类型、异常行为和边界条件,而自然语言规格可能含糊不清,编译器也可能错误理解开发者的意图。
神经程序最需要补齐的是测试、监控和可观测性。 开发者不能因为它能被调用,就默认它满足软件工程中的契约。每个 PAW 函数仍需要准备覆盖正常样本、边界样本、对抗输入和分布外数据的测试集,并记录准确率、拒答率、错误类型及版本变化。
编译错误比普通推理错误更危险,因为错误可能被复制到之后的每一次执行中。 如果“紧急邮件”函数把礼貌措辞误认为低优先级,这种偏差可能稳定地影响数万封邮件。传统在线大模型至少还能通过更新提示词临时修正,编译产物则需要重新描述、重新编译和重新验证。
开放式生成任务也可能超出窄神经程序最舒服的范围。 二分类、排序、标签映射和格式修复拥有相对清楚的输出空间,更容易评估;长篇写作、多轮推理和需要实时世界知识的任务,则更依赖完整模型的上下文能力与知识覆盖。PAW 目前更像一个“语义函数编译器”,而不是通用智能体替代品。
安全边界同样取决于编译器和运行时是否可信。 自托管编译器可以减少数据外发,但团队仍需审查模型权重来源、产物格式、运行时权限以及供应链更新机制。神经权重不是可读源码,传统代码审计工具也很难直接判断其中学到了什么行为。
PAW 是否具备商业价值,最终要由端到端指标而不是演示效果决定。 开发者需要知道单次编译耗时、编译所需显存、产物大小、CPU 单次延迟、峰值内存、任务准确率,以及与远端大模型和本地小模型相比的总拥有成本。目前公开信息证明了这种范式可以工作,但还不足以证明它在所有任务上都更便宜或更准确。
这可能成为 AI 应用的新部署单元
ProgramAsWeights 提出的真正问题是:AI 能力是否必须以“模型服务”的形式存在。 过去两年,行业习惯把提示词、上下文和输入一起送进一个越来越大的通用模型;PAW 则认为,一部分稳定行为可以提前编译,最终作为权重文件随软件部署。
如果这种范式成熟,未来的软件依赖项里可能不仅有代码包,还会有经过测试的神经函数。 开发者可以安装一个用于垃圾消息识别的函数、一个用于日志优先级判断的函数,或者一个用于搜索意图排序的函数,并像管理普通依赖一样记录版本、测试结果和适用范围。
PAW 现阶段更像值得关注的研究原型,而不是已经验证完毕的通用基础设施。 它抓住了实时大模型调用中最明显的浪费:任务定义没有变化,系统却要一遍遍调用完整模型重新理解。能否把这套思路变成可靠产品,取决于编译质量、运行性能、评测工具和函数治理体系能否一起跟上。
我们的判断是,PAW 最可能率先在“窄任务、高频调用、数据敏感、允许概率性结果”的场景落地。 它不会取代确定性代码,也不会让通用大模型失去价值,但它可能成为二者之间的一层新抽象:开发者负责说明想要什么,编译器负责制造行为,终端设备负责低成本地重复执行。
参考来源
- Reddit:ProgramAsWeights 项目介绍:项目作者介绍 PAW 的编译与本地执行模式,并说明托管编译器、自托管编译器和 CPU 运行能力。
- Hugging Face Papers:Program-as-Weights 论文页面:论文摘要、作者信息、示例和相关项目资料汇总。
- 知乎:Program-as-Weights 中文解读:对模糊函数编程和自然语言规格编译思路的中文介绍。