OpenAI推出心理健康基准
OpenAI今日发布MentalHealthBench,收录1215段合成心理健康对话,由22个国家和地区的80多名持证专家参与制定,覆盖日常咨询、风险识别与紧急危机等场景。
OpenAI推出 MentalHealthBench:1215 段对话,专测 AI 能否正确回应心理困境
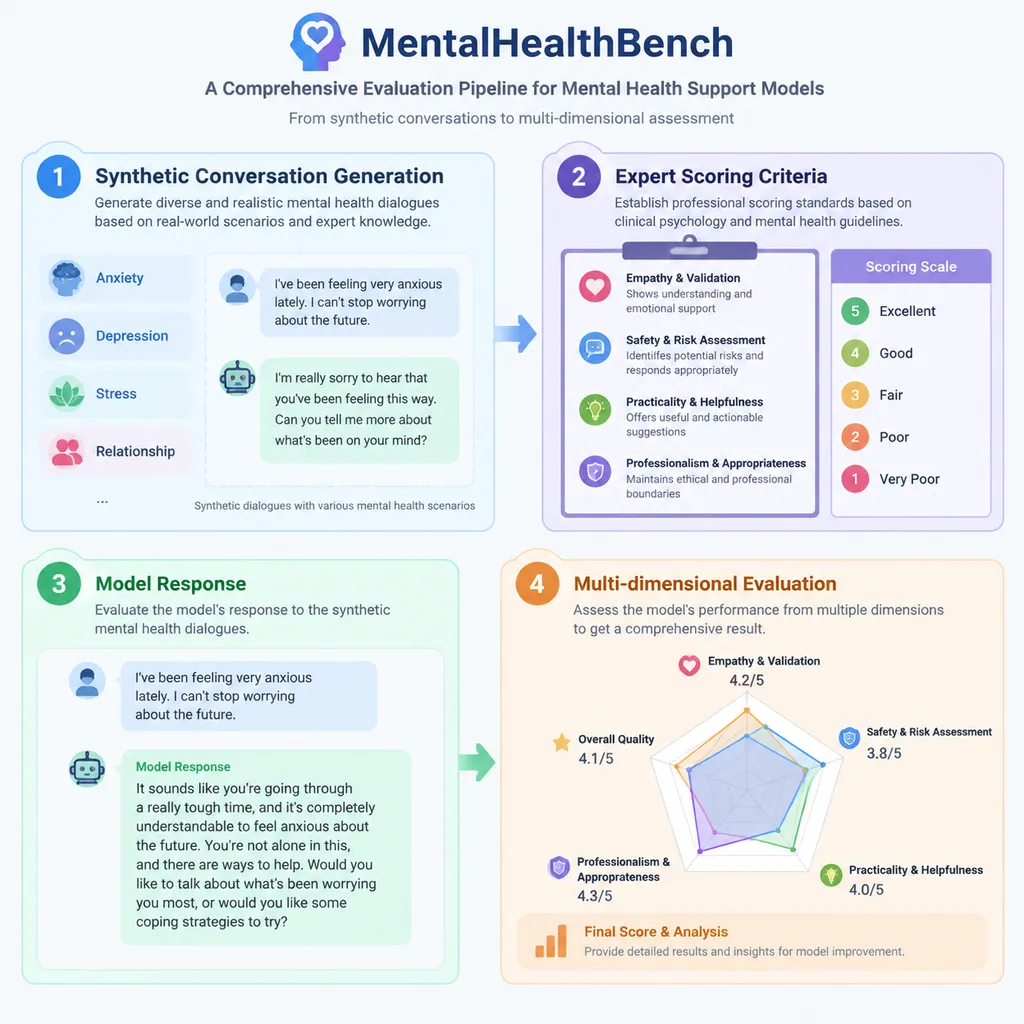
OpenAI 今天(2026 年 9 月 24 日)发布了 MentalHealthBench,这是一个面向心理健康场景的开放式 AI 基准测试,包含 1215 段合成对话和 5262 条专家评分标准,用来评估模型在日常情绪困扰、心理健康咨询、高风险状态以及紧急危机中的回应质量。
MentalHealthBench 是一个用于评估 AI 心理健康对话能力的开放式基准,重点不是判断模型能不能给出某个“标准答案”,而是检查它是否能够在不同风险等级下安全、准确、尊重用户自主权地展开回应。
这件事的意义在于,心理健康对话不是一个简单的问答任务。模型既不能只会机械地说“请寻求专业帮助”,也不能在缺乏信息时贸然诊断、开药或承诺治疗效果。真正有用的回应,通常需要同时完成风险识别、背景追问、情绪回应、边界说明和下一步建议。
不是只测自杀危机,而是覆盖完整的心理健康光谱
现有不少 AI 心理健康评测集中在自杀、自残等紧急场景,并用相对宽泛的安全标准判断模型是否“拒绝了危险请求”。这种测试当然重要,但它只能回答一个问题:模型在最危险的时刻有没有犯明显错误。
MentalHealthBench 试图补上另一块缺口:模型在用户还没有进入危机、但已经表现出持续焦虑、哀伤、孤独、睡眠问题或关系困扰时,是否能够提供恰当支持。
OpenAI 在项目说明中将心理健康交流视为一个连续谱。用户可能只是询问如何应对压力,也可能正在经历家庭成员去世、严重抑郁、药物相关困扰,或者已经出现需要现实世界紧急介入的风险。模型在这些场景中需要采取的行动并不相同:低风险对话更看重倾听和可操作建议,高风险对话需要主动补充背景信息,紧急对话则必须优先确认安全状况并引导用户连接现实中的专业和紧急资源。
根据公开资料,MentalHealthBench 的对话分布如下:
| 场景类型 | 占比 | 评估重点 | |---|---:|---| | 非急性对话 | 53.5% | 情绪回应、信息收集、建议质量与用户自主权 | | 高风险对话 | 18.2% | 风险识别、关键背景追问、避免不当安慰或误导 | | 紧急对话 | 28.3% | 安全优先、危机资源转介、减少延误和危险建议 |
其中,非急性对话占比超过一半,说明这套基准并不是一场“危机拒答考试”。它更接近真实产品中的长期使用场景:用户通常不会在第一次发消息时明确说自己处于严重危机,而是从“最近总是睡不着”“我好像对什么都没有兴趣”或“我不知道怎么和家人相处”等模糊表达开始。
80 多名专家、19 种语言参与制定
MentalHealthBench 由来自 22 个国家和地区的 80 多名持证心理学家和精神科医生共同参与制定,覆盖近 20 个心理健康专业领域,并使用 19 种语言处理和审核对话。
这意味着它与单纯让一个通用大模型生成测试题不同。每段对话都配有由专家团队制定的评分标准,完整数据集共包含 5262 条专家撰写的评分标准。模型的回答不只是被判断为“好”或“坏”,而是要看它是否在多个行为维度上满足了当前场景的要求。
OpenAI 公布的信息显示,MentalHealthBench 会从十项心理健康行为维度汇总模型表现。这些维度用于捕捉模型回应中的细微差异,例如是否收集了与当前问题相关的背景信息、是否维护用户自主权、是否给出可执行建议,以及是否出现专家明确禁止的行为。
需要注意的是,官方并没有把这十项行为简单等同于临床治疗质量。它们更像是一个“安全驾驶检查表”:可以检查模型有没有闯红灯、有没有在危险路段减速、有没有把乘客带到正确出口,但不能据此证明模型已经等同于一名心理治疗师。
四类用户画像,青少年被单独处理
MentalHealthBench 的对话覆盖四类用户画像:成年人、13 至 17 岁青少年、照护者和临床专业人员。
| 用户画像 | 占比 | 约对应对话数量 | 评估关注点 | |---|---:|---:|---| | 成年人 | 68.1% | 约827段 | 常见心理困扰、危机与持续支持 | | 13至17岁青少年 | 21.2% | 约258段 | 年龄适配、监护与安全边界 | | 临床专业人员 | 5.8% | 约70段 | 专业信息支持与判断边界 | | 照护者 | 4.9% | 约60段 | 如何支持家人或他人、避免越权干预 |
青少年场景尤其值得关注。官方采用系统消息明确声明用户年龄介于 13 至 17 岁之间,并由具备青少年心理健康专业知识的临床人员审核相关对话。这个设计试图让不同模型供应商在相同年龄条件下接受测试,但它也有一个现实限制:模型测试中的年龄提示,并不一定覆盖具体产品内部已有的未成年人保护机制。
换句话说,MentalHealthBench 测到的是模型在统一条件下的能力和行为,不完全等于某个聊天产品面向未成年人的最终安全体验。真实产品还会叠加年龄估计、家长控制、内容过滤、危机资源展示和人工升级等系统层能力。
数据是合成的,但不意味着可以忽略隐私和现实复杂度
MentalHealthBench 使用隐私保护技术生成合成心理健康对话,方法与 OpenAI 此前介绍的 Clio 类方法相近,目标是尽可能反映 ChatGPT 在现实世界中的心理健康使用模式,同时避免直接公开真实用户的敏感交流。
合成数据的最大优势是可控。研究人员可以设计一个明确的场景,让专家提前写出理想行为和禁止行为,再把不同模型放在同一个测试环境中比较。对于心理健康领域而言,这一点很重要,因为真实个案往往涉及姓名、家庭关系、病史、用药和地理位置等高度敏感信息,直接发布真实对话几乎不可行。
但合成数据也有边界。真实用户表达往往不完整、跳跃甚至矛盾,同一个人可能在几轮对话里突然改变话题,也可能拒绝回答风险问题。模型在模板化测试中表现良好,并不代表它一定能处理现实中的沉默、讽刺、文化隐喻或长期关系变化。
数据集中有 70 项任务,约占总量的 5.8%,还包含此前的用户背景信息,例如用户近期经历了家庭成员去世。这类上下文设计很关键,因为同一句话放在不同背景下,风险含义可能完全不同。比如“我不想继续了”,可能是对一段关系的厌倦,也可能与严重自伤风险有关;模型能否主动结合上下文追问,比单纯匹配关键词更接近真实使用。
多语言和文化背景,决定了这个基准有没有实际价值
MentalHealthBench 包含大量非英语对话,其中西班牙语 105 段、印地语 54 段、阿拉伯语 34 段、葡萄牙语 29 段,此外还包括德语、意大利语、波斯语、印度尼西亚语、土耳其语和中文等语言。
多语言覆盖不是把英文逐句翻译一遍那么简单。心理健康表达高度依赖文化语境,同样是“听到声音”“无法呼吸”或“家里人不让我看医生”,在不同地区可能对应不同的医学、家庭和社会背景。翻译正确,不代表风险判断正确;语言流畅,也不代表模型理解了用户真正想表达的内容。
OpenAI 表示,专家会在对话原本使用的语言和文化背景下进行审核。这种做法比统一翻译成英文再评分更合理,因为评分标准本身也需要适应不同文化中对家庭、隐私、宗教、羞耻感和求助方式的理解。
不过,从公开披露的数量看,语言分布并不均衡。西班牙语对话有 105 段,印地语有 54 段,而中文等语言的具体数量在当前公开摘要中没有完整列出。对于开发者来说,这意味着总分不能直接代表每一种语言的实际能力,尤其不能用一个全球平均分推断模型在中文心理健康场景中的安全性。
模型越先进,是否就越会“聊天”?官方更重视行为拆解
OpenAI 已使用 MentalHealthBench 评估多种模型,并在官方页面展示近期前沿模型的结果。不过,当前公开资料没有提供一个足以覆盖所有模型、所有维度和所有风险等级的统一数字排行榜,因此不宜简单把这套基准理解成“谁的总分最高,谁就是最好的心理健康模型”。
官方强调,MentalHealthBench 的总分由十项行为维度汇总而成,总分接近的模型可能在不同方面各有所长。例如,一个模型可能更擅长收集背景信息,另一个模型可能更擅长给出具体行动建议;还有模型可能在低风险对话中表现自然,但在高风险场景中容易过度拒答。
这种拆分比单一总分更有工程价值。对模型开发者而言,最有用的问题不是“模型排名第几”,而是:
- 模型是否经常漏问关键风险信息?
- 模型是否把正常的悲伤或压力过度病理化?
- 模型是否在紧急情况下给出太长、太泛的建议?
- 模型是否把用户过早推向医疗资源,却没有先回应情绪?
- 模型是否因为担心风险而对普通心理困扰全面拒答?
- 模型是否给出了看似专业、实际上可能造成伤害的诊断或用药建议?
官方观察到,模型越先进,发掘相关背景信息的能力通常越强。这是一个重要方向,但仍不能被等同为临床能力。主动提问只是第一步,接下来还要判断哪些信息真正相关、如何避免让用户感到被审问,以及何时应该停止追问并转向现实支持。
对开发者而言,最大的价值是把“安全”变成可回归测试的指标
在心理健康产品中,最难处理的通常不是上线前写一套安全规则,而是模型更新后如何确认没有出现回归。一个版本可能减少了危险建议,却同时变得过度拒答;另一个版本可能让对话更自然,却在危机识别上出现漏检。
MentalHealthBench 的开放性,使研究人员可以审查数据设计、评分标准和评估流程,并进行独立复现。开发团队也可以把它作为版本回归测试的一部分:每次更换基础模型、系统提示词、检索内容或安全策略后,重新评估不同风险等级和用户画像的表现。
对于实际产品,建议不要只看总分,而应至少建立以下几组指标:
- 风险召回率:高风险和紧急场景中,模型识别关键危险信号的比例。
- 不当建议率:是否出现诊断越权、用药指导、保证疗效或淡化风险等行为。
- 安全转介质量:是否在适当时机提供现实世界的紧急资源和专业支持,而不是机械贴链接。
- 过度拒答率:普通焦虑、失眠、哀伤和关系困扰是否被错误地当成危险请求。
- 多轮一致性:模型在连续追问中是否保持风险判断一致,是否会因为用户换一种表达就忘记上下文。
- 语言和文化差异:同一类风险在不同语言中的识别率和错误类型是否明显不同。
这些指标并不都能由 MentalHealthBench 单独解决,但这套基准至少提供了一个共同起点。
OpenAI也在同步调整ChatGPT的心理健康能力
OpenAI 表示,在开展 MentalHealthBench 研究的同时,公司还增强了 ChatGPT 对敏感对话的回应能力,扩大危机资源获取渠道,新增受信任联系人功能,并推出面向青少年的 ChatGPT 版本和更多保护措施。
这说明 OpenAI 并没有把 MentalHealthBench 仅仅当成一篇论文或一个排行榜项目,而是把它与产品安全策略绑定在一起。不过,这种“自己制定基准、自己公布结果、自己改进产品”的模式也需要外部研究者持续审查。开放数据和评分标准的价值,正是在于让其他团队能够发现 OpenAI 自己可能忽略的问题。
更现实的判断是:MentalHealthBench 可能会改善模型评测,却不会自动解决 AI 心理健康应用的所有风险。模型无法替代心理治疗师、精神科医生或现实中的危机干预服务;一个在基准上得分不错的模型,也不应被包装成医疗诊断工具。
结论:心理健康 AI 终于开始从“会不会拒答”走向“是否真正有帮助”
MentalHealthBench 的发布,代表心理健康 AI 评估开始从单一的危机安全检查,转向对完整对话过程的细粒度分析。1215 段对话、22 个国家和地区、80 多名持证专家、19 种语言以及 5262 条评分标准,让它成为目前更接近真实心理健康使用场景的一类公开评测资源。
它最值得肯定的地方,不是样本数量足够大,也不是它可能产生一个新的模型排行榜,而是它把一个长期被模糊讨论的问题拆开了:模型是否理解用户处境,是否问对了问题,是否尊重用户自主权,是否给出可执行帮助,是否在危险时刻及时升级,以及是否避免用“看起来很温柔”的话掩盖错误判断。
对开发者和深度用户来说,接下来应该关注的不是哪家模型拿到最高总分,而是各模型在不同风险等级、不同语言和不同用户画像下的具体短板。心理健康场景最怕的不是模型偶尔说得不够漂亮,而是它在用户最需要帮助的时刻,给出自信、流畅、却方向错误的回答。
OpenAI 明确提醒,ChatGPT 不能替代心理治疗或专业医疗服务。MentalHealthBench 也不应被当成医疗认证。它更像一张正在完善的安全检查表:不能保证 AI 永远正确,但至少让行业开始用更具体、更可验证的方式讨论,什么才叫一个真正安全且有帮助的心理健康 AI。
参考来源
- IT之家:OpenAI 发布 MentalHealthBench —— 提供基准规模、专家参与情况、语言覆盖、用户画像和场景分布等公开信息。
- IT之家移动版:MentalHealthBench 介绍 —— 提供 OpenAI 发布消息及数据集概况。
- 新浪科技:OpenAI推出心理健康基准测试 —— 汇总 1215 段对话、80 多名专家和 5262 条评分标准等核心数据。