机器人足球,开始学会击败梅西
一项最新机器人足球研究用自我对弈训练了相当于 140 年的比赛,让机器人形成了逼抢、变向和预判能力。它还不能直接等同于击败梅西,但已展示出从虚拟策略到真实运动控制的跃迁。
AI“阿尔法狗”杀入足球场:机器人自我对弈 140 年,开始具备击败梅西的能力
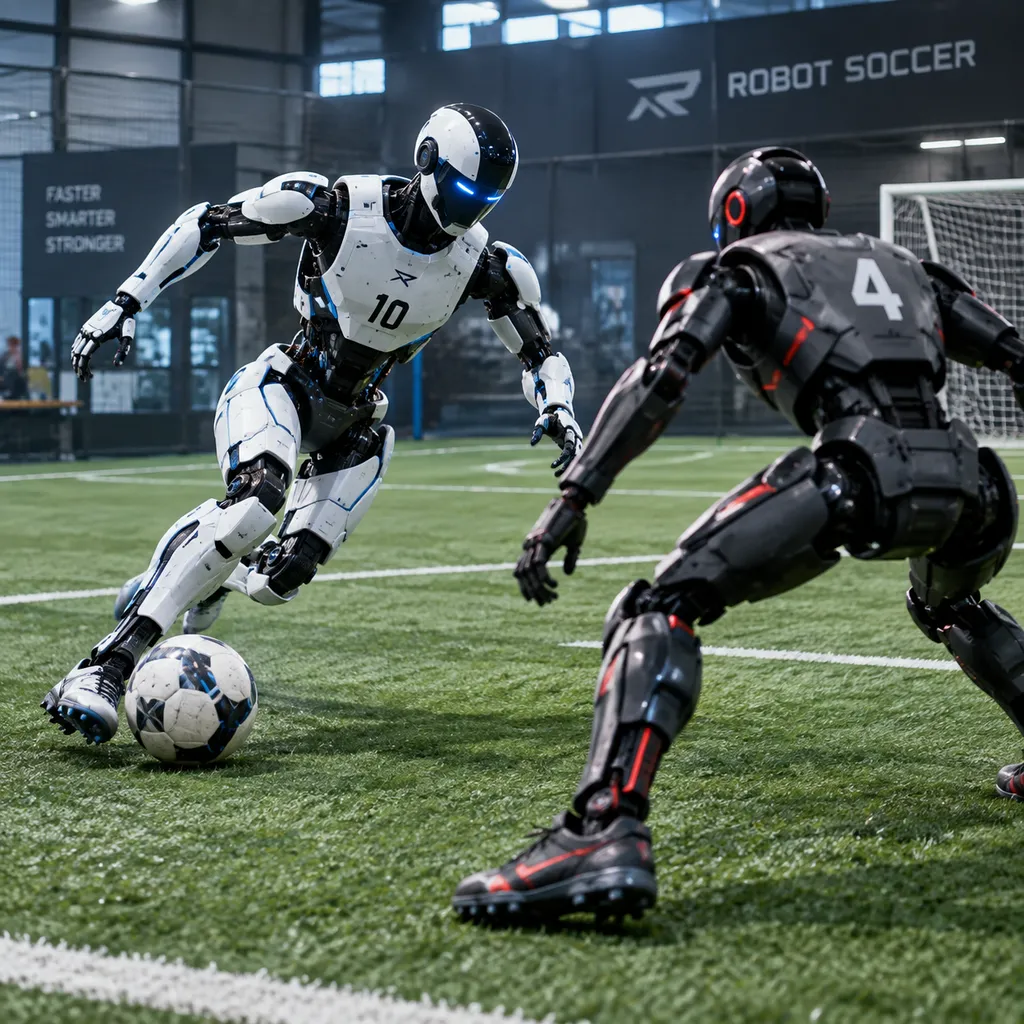
**截至 2026 年 9 月 25 日,机器人足球正在从表演项目变成一种真正的 AI 训练场。**一项最新研究显示,研究人员让机器人在仿真环境中持续进行自我对弈,累计训练时长相当于 140 年真实比赛,最终学会了快速变向、抢断、护球和针对性防守等动作。研究团队进一步声称,这套系统已经具备在特定一对一场景中限制顶级球员、甚至击败梅西的能力。
这里的重点不在于机器人是否真的和梅西踢过一场完整比赛,而在于:AI 正在把足球从一个需要大量人工示范的运动,变成可以通过自我对抗不断进化的控制问题。
这条消息之所以值得关注,是因为它代表的不是一个更灵活的机械身体,而是一种训练范式的变化。过去的机器人足球依赖工程师逐个写规则,告诉机器人什么时候追球、什么时候转身、怎样避开对手。现在,研究人员只需要定义比赛目标,剩下的策略由模型通过数百万次对抗自己摸索出来。
140 年不是机器人踢了 140 年球
**自我对弈是指智能体通过与自己的不同版本反复比赛,在没有人工逐步示范的情况下学习策略。**AlphaGo 最早让这种方法进入公众视野:系统不必完全照抄人类棋谱,而是通过和自己下棋,逐步发现人类棋手没有总结出来的落子方式。
这次足球训练沿用了相似思路,但难度高得多。围棋的棋盘是离散的,棋子每一步都能被准确描述;足球则是一个连续、实时、充满噪声的三维运动系统。机器人必须同时处理球的位置、身体姿态、对手速度、地面摩擦、动作延迟和下一步可能发生的碰撞。
所谓“自我对弈 140 年”,通常指仿真环境中的累计比赛时间,而不是一台机器人在现实世界里连续运行了 140 年。仿真可以让大量训练并行进行,把原本需要数十年的比赛压缩到数天或数周的计算任务中。这个数字更适合被理解为训练规模,而不是机器人实际拥有了 140 年的人类经验。
这种训练方式的优势在于样本数量足够大。人类教练可以示范一个标准动作,却很难穷举所有情况:对手从左侧逼抢怎么办,球速突然变化怎么办,身体已经失去平衡时是否应该继续抢球。自我对弈则会主动制造这些边界案例,并把成功率更高的动作保留下来。
换句话说,机器人不是被告知“梅西会怎么踢”,而是在反复失败后逐渐学会:面对速度快、变向强、控球稳定的对手,什么时机上抢,什么距离保持防守,什么时候应该放弃抢球转而封堵路线。
机器人学到的不是球技,而是控制策略
**机器人足球策略是指智能体根据球、对手和自身运动状态,实时决定移动方向、身体姿态与出脚时机的一组控制规则。**这类策略与传统意义上的“足球技巧”不同,它更接近一个高速运行的决策系统。
从公开信息看,这套系统的能力主要集中在几个方面。
第一是提前预判。普通机器人往往看到球滚向哪里,才开始向哪里移动,结果永远慢半拍。经过自我对弈训练后,机器人会根据对手的身体朝向、步幅和球的相对位置,提前判断下一次触球可能发生在哪里。它不只是追球,而是在追一条未来的运动轨迹。
第二是动态变向。双足机器人最大的难点不是直线奔跑,而是在保持平衡的情况下突然减速、转身和重新加速。球场上的有效防守往往需要在几十厘米的空间内改变方向。模型通过大量失败案例学会了什么时候降低重心、什么时候缩短步幅,以及怎样把身体放在对手和球门之间。
第三是抢断时机。过早出脚容易被对手变向晃开,过晚出脚又会错过唯一机会。强化学习可以把抢断后的结果转化为奖励信号,让模型逐步逼近一个更稳定的出脚窗口。
第四是从单个动作到连续动作的组合。传统机器人演示中,奔跑、停下、转身和踢球常常是分开的模块。自我对弈训练则要求机器人在运动过程中连续完成这些动作。例如,它需要先压迫对手,再封堵传球路线,最后在失去平衡前完成触球。系统优化的不是某一个动作的漂亮程度,而是一整段动作能不能提高最终得分概率。
这也是它与早期机器人足球项目的分水岭。过去的机器人更像一个执行预设脚本的自动化设备;现在的机器人开始表现出“根据局面调整动作”的能力。
“能击败梅西”到底意味着什么
**“击败梅西”在这类研究语境中,更可能指机器人在受限的一对一对抗任务中具备压制顶级球员的局部能力,而不是机器人已经在完整足球比赛中战胜了梅西。**这一区分非常重要。
一对一挑战通常会固定场地大小、参与人数、球门位置和任务目标。机器人只需要在相对有限的策略空间里防守、抢球或完成射门。完整比赛则完全不同:球员数量增加后,系统必须理解阵型、传球线路、空间利用、体能分配和队友协作,还要应对裁判、天气、草地和比赛节奏等非理想因素。
因此,更准确的说法应该是:这套系统让机器人在某些局部对抗任务中,拥有了接近顶级球员的决策和动作能力;它并不意味着机器人已经具备梅西在真实比赛中的全部能力。
梅西的价值也不只是速度和盘带。顶级球员会读取队友的意图,识别防守阵型,利用假动作改变对手预期,并在极短时间内决定是突破、传球还是回撤。这些能力包含大量身体经验、比赛直觉和上下文判断,不能简单用一次抢断成功率来衡量。
但这并不削弱研究的意义。足球最难自动化的部分,本来就是在不确定环境里连续做决定。如果机器人能够在一对一场景中稳定预测对手动作,并把策略转化为真实身体动作,那么它已经跨过了从“会移动”到“会对抗”的关键门槛。
与传统机器人训练方式相比,变化在哪里
| 对比维度 | 传统规则或示范训练 | 自我对弈强化学习 | |---|---|---| | 策略来源 | 工程师编写规则、人类示范 | 智能体通过反复对抗自行发现 | | 训练规模 | 受真实场地和人工标注限制 | 可在仿真中并行运行大规模比赛 | | 对异常情况的适应 | 遇到未覆盖场景容易失效 | 可以通过失败样本持续修正 | | 动作组合 | 奔跑、转身、踢球常被拆分 | 直接优化连续动作链路 | | 对手建模 | 通常依赖预设行为 | 对手策略会随训练共同变化 | | 现实迁移难度 | 规则清晰但泛化有限 | 泛化更强,但仿真到现实仍是难点 |
**自我对弈真正带来的变化,是把机器人训练从“记住正确动作”变成“在竞争中发现有效策略”。**这对复杂运动尤其重要,因为复杂运动没有唯一标准答案。
同一个防守场景,机器人可以选择上抢、后撤、封堵角度或诱导对手向边线移动。只要最终结果更好,模型就可能找到与人类教练完全不同的解决办法。类似 AlphaGo 在围棋中发现新棋路,足球机器人也可能形成不符合传统训练教材、但在数据上更有效的动作风格。
最大瓶颈仍然是仿真到现实
**仿真到现实迁移是指把模拟环境中训练出的策略部署到真实机器人上,并让它在真实物理条件下保持稳定。**这是机器人足球目前最难解决的问题之一。
仿真里的草地不会突然打滑,机器人不会因为电机温度升高而动作变慢,摄像头也不会被观众、灯光和阴影干扰。现实世界中的摩擦力、地面坡度、机械间隙和传感器延迟,都会让一个在仿真中表现完美的动作失效。
研究人员通常会使用“域随机化”降低这种差距。域随机化是指在仿真训练中不断改变摩擦系数、光照、球体质量、动作延迟和地面材质,让模型不要过度依赖某一组固定条件。这样训练出来的策略,面对真实场地的变化时更有韧性。
但域随机化不是万能的。机器人摔倒一次,可能损坏关节;高速奔跑时的轻微误差,可能会变成严重碰撞;球被踢到不同角度后,视觉系统还必须在几十毫秒内重新定位。研究成果能否在公开场地、复杂光照和真实对手面前复现,仍然需要更多测试。
另一个问题是硬件。模型可以提出一个理论上最优的动作,但机器人未必有足够强的电机、足够快的控制器或足够稳定的关节去执行。AI 的决策能力最终必须受到机械结构、续航时间和散热能力的约束。
这项技术短期内最可能用在哪里
机器人足球的第一批实际应用,不太可能是让机器人取代职业球员,而是推动通用机器人学习现实世界中的连续控制。
第一类应用是运动控制训练。足球包含奔跑、急停、转向、平衡、碰撞和精确触球,是测试双足机器人运动能力的高密度场景。一个能在球场上稳定完成这些动作的机器人,理论上也更容易处理仓库、工厂和家庭环境中的复杂移动任务。
第二类应用是多智能体协作。足球天然要求多个智能体共享空间、竞争资源并快速分工。研究团队可以利用这种环境训练机器人之间的协同、避碰和任务分配能力,这些能力同样适用于仓储搬运、灾害救援和无人系统编队。
第三类应用是体育分析与训练辅助。机器人可以充当重复性极高、动作标准稳定的陪练,帮助球员测试盘带、射门和一对一突破。相比真人陪练,机器人可以精确复现某种防守角度和移动节奏,也能记录每次对抗的轨迹与结果。
第四类应用是通用具身智能。具身智能是指智能体通过身体感知和行动,在真实环境中完成任务的能力。足球机器人并不是一个孤立的玩具项目,它提供了一个目标明确、反馈及时、可量化评估的实验场。进球、丢球、抢断和失误都可以被转化成清晰的训练信号。
别被“梅西终结者”带偏了
**这项成果最值得关注的不是机器人是否真的打败了梅西,而是强化学习正在进入高动态、强对抗、低容错的现实任务。**过去的 AI 成绩往往发生在棋盘、游戏或文本环境中,规则边界相对清晰;足球要求模型同时理解视觉信息、物理规律和身体动作,并在极短时间内做出决策。
当然,媒体标题中的“梅西终结者”具有很强的传播性,但也容易把技术事实简化成一场人机胜负。当前更严谨的问题应该是:机器人在什么场地、什么人数、什么规则下完成了什么任务?对手是否是真人?测试重复了多少次?机器人是否使用了外部定位设备?模型在仿真和现实中的成功率分别是多少?
这些指标比一句“击败梅西”更能判断成果的含金量。尤其需要警惕的是,局部场景的高胜率并不等于通用能力。一个机器人可以在固定距离的一对一防守中表现出色,却无法在多人比赛里判断队友位置;也可以在实验室地面完成高速变向,却在湿滑草地上频繁摔倒。
从产业角度看,这条新闻仍然释放了一个明确趋势:**具身 AI 的竞争重点正在从感知和语言理解,转向身体控制、环境交互和长期试错。**当仿真计算成本下降、机器人硬件变得更可靠后,足球这样的竞技环境会成为训练通用机器人策略的重要平台。
机器人暂时还没有真正成为职业足球运动员,更谈不上在完整比赛里取代梅西。但它已经证明了一件更重要的事:只要目标可以量化、环境可以模拟、失败成本可以压低,机器就能通过数十亿次试错学会人类过去依靠多年训练才能掌握的运动策略。
这可能才是“AI 阿尔法狗杀入足球场”的真正含义。它不是把围棋的胜利复制到足球,而是把自我对弈带入一个更混乱、更接近现实世界的环境。下一场比赛的看点,或许不再只是机器人能不能进球,而是它还能把这种从对抗中学会的能力,带到哪些真实工作里。
参考来源
- GitHub:用于核查机器人足球、自我对弈和强化学习相关开源项目;本文未将未经确认的仓库数据作为核心事实依据。
- Hugging Face:用于了解强化学习、机器人控制和具身智能领域的公开模型与研究资源。
注:本文根据 2026 年 9 月 25 日公开报道线索整理。关于“自我对弈 140 年”与“击败梅西”的表述,应理解为特定仿真或局部对抗场景中的能力描述,不等同于完整职业足球比赛结果。