Tauon挑战Muon:更快也更稳
新优化器 Tauon 在 GPT-Mini 初测中把验证损失降至约 1.60,单步耗时较 Muon 减少约 8.5%。但实验规模较小,现阶段更像值得复现的工程假设,而非已经完成验证的替代方案。
Tauon挑战Muon:更快也更稳
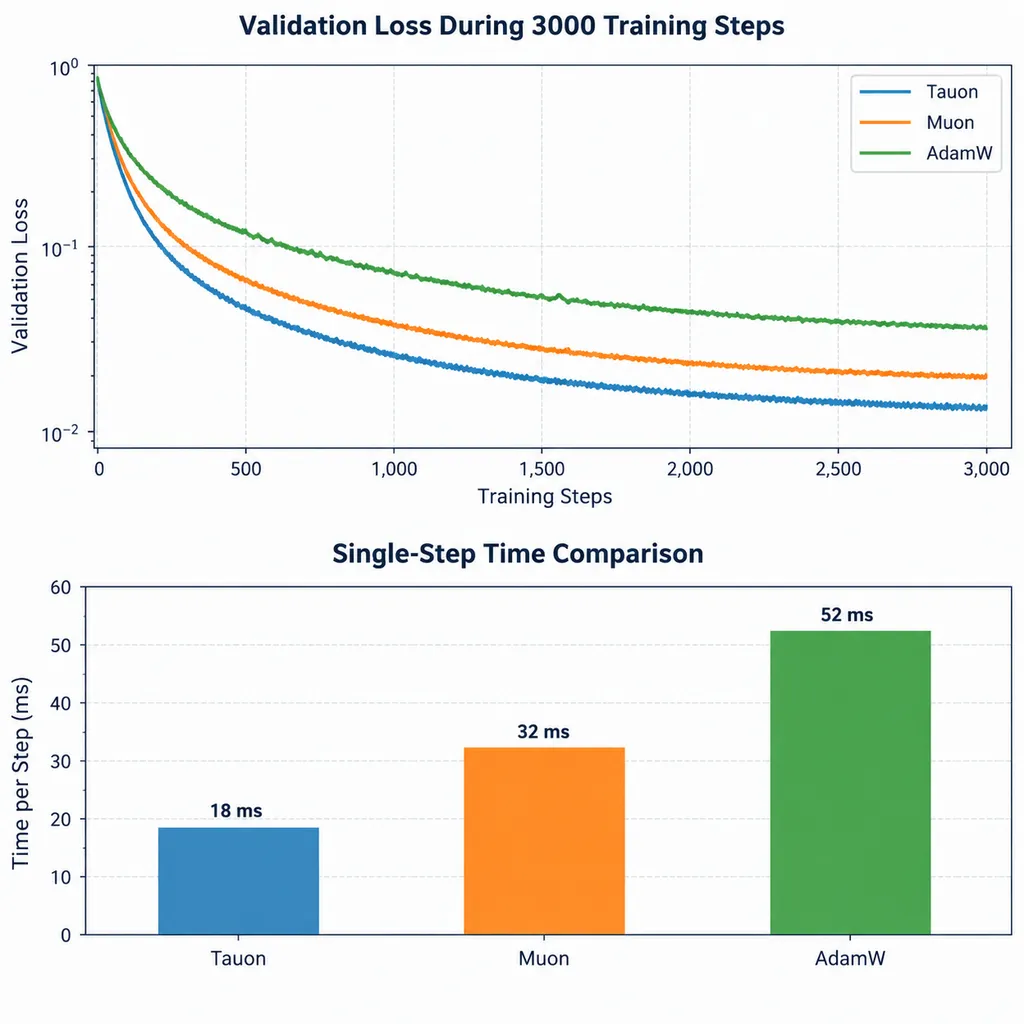
近日,一名开发者公布了新优化器 Tauon 的首轮实验结果:在 TinyShakespeare 上训练 GPT-Mini 时,Tauon 的最终验证损失约为 1.60,低于 Muon 的约 1.65和 AdamW 的约 1.80;与此同时,Tauon 的单步训练耗时为 391.5 毫秒,相比 Muon 报告值降低约 8.5%。
这组数字值得关注,因为 Tauon 挑战的并不是传统基线 AdamW,而是近两年已经在语言模型训练中证明过效率优势的 Muon。Tauon 的思路也不是推翻 Muon,而是对其最昂贵的矩阵正交化过程继续“减步骤、缩矩阵”:先通过谱过滤减少迭代次数,再用系数调度把核心计算压缩到两步,同时借助 DCT-II 降低参与运算的矩阵尺寸。
不过,Tauon 目前仍是一个由作者公开的早期实验,而不是经过多团队、大规模模型和标准数据集验证的成熟优化器。GPT-Mini、TinyShakespeare 和 3000 个训练步骤足以做概念验证,却远不足以回答它在数亿乃至数十亿参数模型上是否仍然有效。
先看结果:损失更低,单步也更快
Tauon 是一种面向二维权重矩阵的实验性神经网络优化器,其核心目标是在保留 Muon 正交化收益的同时,减少正交化本身带来的计算开销。
作者使用一个 d_model=512、6 层的 GPT-Mini,在 TinyShakespeare 数据集上进行了 3000 步训练。Tauon 和 Muon 的学习率都设为 0.02,AdamW 的学习率则为 0.0006。按照作者披露的结果,三者差距如下:
| 优化器 | 学习率 | 最终验证损失 | 单步耗时 | 训练稳定性 | 当前结果的含义 | |---|---:|---:|---:|---|---| | Tauon | 0.02 | 约 1.60 | 391.5 ms | 3000 步内保持稳定 | 当前实验中损失最低、单步最快 | | Muon | 0.02 | 约 1.65 | 约 428 ms | 保持稳定 | 强基线,但正交化成本更高 | | AdamW | 0.0006 | 约 1.80 | 原帖未完整披露 | 约 1200 步后出现过拟合或发散迹象 | 在该组超参数下明显落后 |
Tauon 相比 Muon 将验证损失从约 1.65 降到约 1.60,绝对差值约为 0.05,相对降幅约为 3.0%。对于语言模型交叉熵来说,0.05 并不是可以忽略的显示误差,但单次实验也无法证明这部分差距来自优化器本身,而不是随机种子、初始化、学习率曲线或正则化设置。
Tauon 的 391.5 毫秒单步耗时意味着它在相同硬件上比 Muon 少用约 36 毫秒。若按“耗时下降 8.5%”反推,Muon 的单步时间约为 428 毫秒;完成 3000 步训练时,两者大约分别需要 19.6 分钟和 21.4 分钟,Tauon 在这次短训练中可节省约 1.8 分钟。
AdamW 在约 1200 步后出现过拟合或发散迹象,是这次对比里最醒目的稳定性差异。问题在于,AdamW 使用了不同学习率,而且原帖没有完整给出权重衰减、预热比例、学习率调度、梯度裁剪和多个随机种子的统计结果,因此不能据此得出“Tauon 天生比 AdamW 稳定”的一般性结论。
Tauon改了什么:把正交化做得更便宜
Muon 是一种将动量更新矩阵正交化的优化器,主要用于 Transformer 中隐藏层的二维权重,而偏置、归一化参数、词嵌入等通常仍交给 AdamW 处理。
普通动量方法会保留梯度各个奇异方向之间的强弱差异,而 Transformer 权重矩阵的梯度往往具有较高条件数,少数较大的奇异方向容易支配更新。Muon 对动量矩阵做近似正交化,可以把直观上的“又长又扁的更新椭球”压成更接近均匀的形状,让原本较弱、但可能包含有效信息的方向获得更充分的更新。
Muon 的代价来自矩阵正交化不是一次普通逐元素运算。常见实现会使用 Newton-Schulz 迭代近似矩阵的极分解或正交化结果,这类运算包含多次矩阵乘法;尽管优化器步骤通常只占完整前向和反向计算的一部分,但在小模型、短序列或高效训练内核下,它更容易成为可见开销。
Tauon 的第一项调整是谱过滤,即通过低阶多项式更快地塑造矩阵奇异值分布。谱过滤是利用矩阵多项式选择性放大、压低或重新映射不同谱分量的方法;放在这里理解,就是不必把通往近似正交矩阵的迭代走得那么完整,而是用设计过的多项式快速逼近需要的变换。
Tauon 的第二项调整是系数调度,即不同迭代步骤使用不同的多项式系数,而不是机械重复同一组变换。作者称其先通过谱过滤把相关过程压到三步,再通过系数调度进一步减少到两步;如果每一步都包含规模相近的矩阵乘法,减少迭代次数就有机会直接降低优化器步骤的耗时。
Tauon 的第三项调整是 DCT-II 降维,即利用二型离散余弦变换把矩阵信息集中到较少的频率分量中,再在更小的表示上执行后续计算。DCT-II 是一种把离散信号投影到不同余弦频率分量上的正交变换,JPEG 等压缩方法也利用了相邻数据在低频区域更集中的特性。
DCT-II 在优化器中的关键假设是,梯度或动量矩阵存在足够强的可压缩结构。如果主要信息集中在有限分量中,缩小矩阵可以减少计算;如果重要更新恰好落在被削弱或丢弃的分量里,降维也可能引入偏差。因此,DCT-II 不是无条件的免费加速,它把部分精确计算换成了结构先验。
为什么8.5%并不算小
单步耗时下降约 8.5% 的价值取决于优化器在完整训练流水线中的占比。对于计算量较小的 GPT-Mini,矩阵正交化可能占据更明显的时间;到了大模型训练,注意力、前馈网络、通信和数据加载的占比都会变化,Tauon 的相对收益可能收窄,也可能因为大矩阵计算效率更高而扩大。
Muon 已经证明“优化器可以用更复杂的单步计算,换取更少的总训练步骤”。公开资料显示,Muon 在 NanoGPT 速度竞赛的 FineWeb 训练任务中,达到目标验证损失的速度曾比 AdamW 快约 35%;在 1.5B 参数规模实验中,达到 GPT-2 XL 级别性能的时间也曾比 AdamW 缩短约 25%。
Tauon 更有吸引力的地方,是它试图同时改善收敛和单步成本。若一种优化器只是每步快 8.5%,却要多跑 15% 的步骤才能达到同等损失,那么总成本依然更高;而这次初测中,Tauon 不仅单步更快,最终验证损失也低于 Muon,至少没有表现出明显的“用收敛质量换速度”。
总训练成本才是判断优化器优劣的核心指标。更完整的对比应该固定目标损失,然后统计达到该损失所需的训练 token、墙钟时间和 GPU 小时,而不是只比较第 3000 步的损失或某个局部区间的单步耗时。
Tauon还不能取代Muon
Tauon 当前最大的短板不是理论看起来不合理,而是证据规模太小。TinyShakespeare 是一个约百万字符量级的经典教学数据集,适合快速验证训练代码,却无法覆盖现代预训练语料中的长尾词汇、多语言内容、代码、长上下文和高噪声样本。
单个 GPT-Mini 配置也无法说明扩展规律。优化器在 d_model=512 上有效,不代表它在更宽的 4096、8192 维隐藏层上仍保持相同数值稳定性;DCT-II 缩减后的表示如何随矩阵宽高比变化,也会直接影响压缩误差和计算效率。
一次训练曲线更无法排除随机性。作者至少还需要公开 3 至 5 个随机种子的均值和标准差,并对学习率、动量、权重衰减、预热步数、DCT 保留比例以及多项式系数进行独立消融,才能判断 0.05 的验证损失差距是否稳定存在。
混合精度是另一个必须补齐的测试项。Muon 的正交化过程对数值范围和矩阵乘法精度较敏感,Tauon 又加入谱变换与压缩;它在 FP32 上稳定,不等于在 BF16、FP16 或更激进的 FP8 训练中仍然稳定。对真正的大模型训练团队来说,能否兼容 BF16、分布式参数切分和高性能融合内核,比小模型上的单次曲线更重要。
分布式训练兼容性也决定 Tauon 能否走出实验项目。Muon 在接入 DeepSpeed ZeRO 时就面临一个实际问题:传统优化器可以把梯度视为扁平缓冲区,而 Muon 必须知道原始二维权重形状才能做矩阵正交化。Tauon 同样依赖矩阵结构和 DCT-II,接入 FSDP、ZeRO、张量并行和编译器图优化时只会更复杂,不会更简单。
开发者现在该不该试
研究优化器、训练小型 Transformer 或参加训练速度竞赛的开发者,现在就值得复现 Tauon。它的改动集中在优化器步骤,不要求修改模型结构;如果代码实现完整,开发者可以在相同模型和数据管线上直接比较达到固定验证损失的时间。
正在进行大规模预训练的团队暂时不应直接替换生产方案。Muon 本身已经有更大规模实验、公开实现以及 DeepSpeed 等工程适配案例,而 Tauon 目前只有 GPT-Mini 与 TinyShakespeare 的初始结果,验证层级差了不止一个数量级。
一个可信的复现实验至少应包含以下项目:
- 使用完全一致的数据顺序、初始化方式、批量大小和学习率调度。
- 分别为 Tauon、Muon 和 AdamW 搜索合理学习率,而不是只比较单组参数。
- 报告至少 3 个随机种子的验证损失均值、标准差和最差结果。
- 同时记录每步耗时、达到固定损失的总时间、峰值显存和训练 token 数。
- 分离前向、反向、优化器步骤和分布式通信耗时,确认 8.5% 来自哪里。
- 在不同模型宽度、深度和数据规模上检查收益能否延续。
- 对谱过滤步数、系数调度和 DCT-II 压缩比例逐项消融。
Tauon 还需要回答一个理论问题:它是在更高效地逼近 Muon,还是实际上引入了不同的隐式正则化。如果只是近似误差恰好帮助 TinyShakespeare 泛化,那么换到更大、更复杂的数据后,优势可能消失;如果两步多项式与 DCT 压缩能够稳定保留关键奇异方向,它才可能成为一条可扩展的优化器路线。
判断:好想法,但结论要等大模型
Tauon 最有价值的贡献,是把优化器创新从“设计新的更新规则”推进到“重新预算更新规则的计算成本”。Muon 已经说明矩阵级正交化可以改善 Transformer 训练效率,Tauon 则继续追问:既然正交化有效,能否用更少的矩阵乘法、更小的矩阵完成它?
现阶段把 Tauon称为“Muon 杀手”明显过早。验证损失约 1.60、单步 391.5 毫秒、相对 Muon 快约 8.5%,这些结果足以让它进入复现清单,但不足以证明它能在 FineWeb、C4 或数十亿参数模型上保持领先。
如果后续实验能在 100M、1B 乃至更大参数规模上复现“更低目标损失、更短墙钟时间、相近或更低显存”这三个条件,Tauon 才会真正触及 Muon 的位置。到那时,它的意义也不只是又多了一个优化器名称,而是说明大模型训练中的矩阵正交化仍有明显的算法压缩空间。
参考来源
- Reddit:Tauon 初始基准与作者说明:包含 GPT-Mini、TinyShakespeare、学习率、验证损失和单步耗时等首轮实验信息。
- GitHub:Muon 参考实现:Muon 优化器的公开代码与实现说明,可用于理解 Newton-Schulz 正交化及参数分组方式。
- GitHub:DeepSpeed:大模型分布式训练框架,可用于核对 Muon 一类矩阵优化器接入 ZeRO 时涉及的参数切分与梯度形状问题。