Claude Opus 5.5终于告别“Claude体”
Arena 对 2026 年 8 至 9 月 Text Arena 高推理回复的分析显示,Claude Opus 5.5 的破折号使用量较 Opus 5 下降约 95%,分号下降 73%。它的句子更短,但平均回答反而更长,Anthropic 正在重新调整 Claude 的默认表达方式。
Claude Opus 5.5终于告别“Claude体”
Claude Opus 5.5 的写作风格发生了一个非常具体、也非常容易被用户感知的变化:它几乎不再使用破折号了。
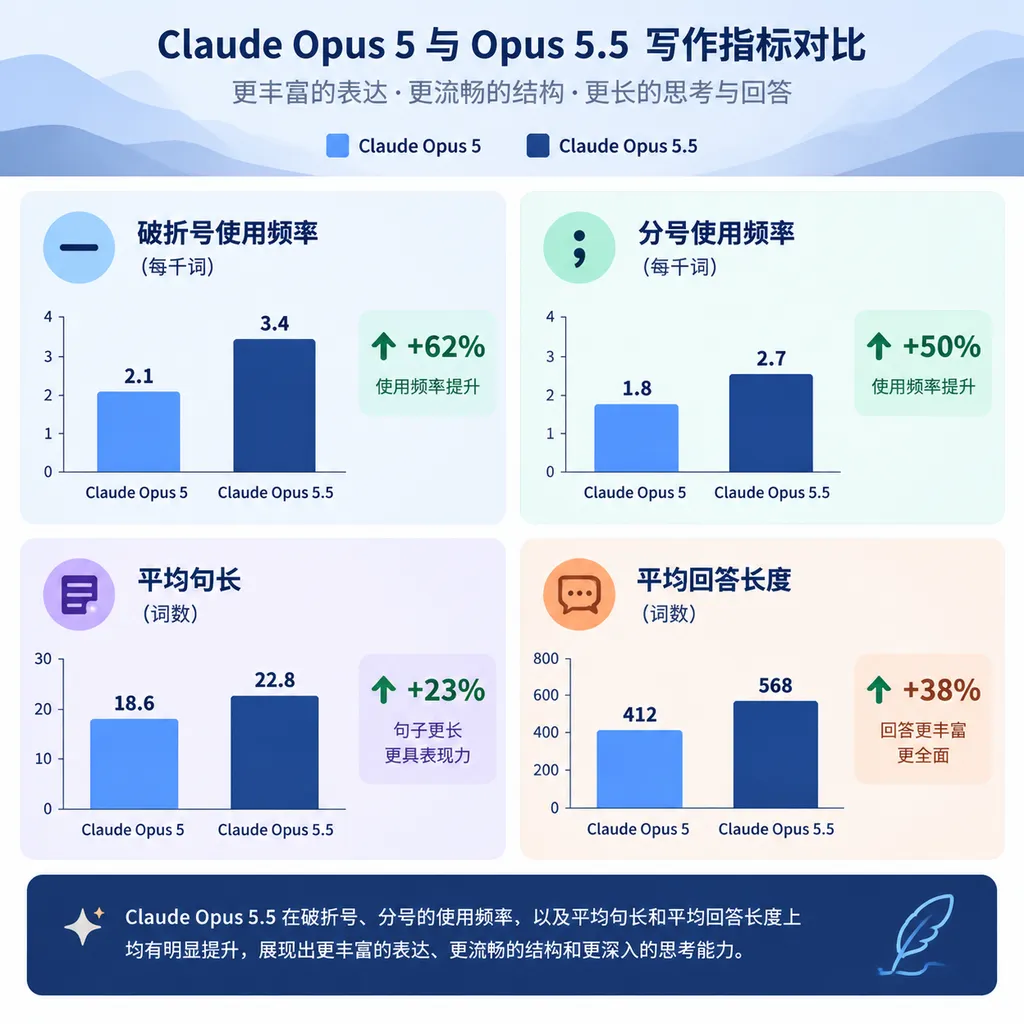
根据 Arena 对 2026 年 8 月和 9 月 Text Arena 高推理回复的分析,Claude Opus 5.5 每 1,000 个单词平均使用 0.8 个破折号,而 Claude Opus 5 的对应数字是 15.2 个,下降约 95%。分号的使用量也从每 1,000 个单词 6.10 个降至 1.64 个,降幅达到 73%。
这不是简单的标点偏好变化,而是 Anthropic 在重新调校 Claude 的默认写作方式。长期以来,Claude 的回答都带有一套明显的语言指纹:长句、层层转折、频繁使用破折号和分号、先复述问题再展开说明,以及在结论不够确定时加入大量缓冲语。用户把这种风格称作“Claude体”,英文社区则常用 “Claudish” 来形容。
Opus 5.5 的变化说明,Anthropic 正在尝试降低这种可识别的模型腔,同时让回答更快进入重点。对于每天用 AI 写代码、做研究、整理会议纪要和生成对外内容的用户来说,这比一次基准测试分数上涨更容易转化成实际体验。
破折号为什么会成为 AI 写作的标志
破折号是一种用于插入补充说明、制造转折或强调语气的标点,但在大模型输出中,它经常承担了原本应该由句号、逗号或标题承担的结构功能。
过去几代 Claude 尤其喜欢用破折号把多个意思串在同一句话里。比如,一个回答可能先提出结论,再用破折号补充背景,接着再用另一个破折号加入例外情况。这样的句子通常语法没有问题,甚至读起来很流畅,但连续出现后会形成非常固定的节奏。
这种节奏之所以容易被识别,是因为模型在训练和生成时倾向于选择高概率、低风险的连接方式。破折号可以同时表达解释、转折和强调,比重新组织句子更省事。对模型而言,它像一块通用的语法胶带;对读者而言,连续使用则会让文章显得公式化。
AI 写作特征是指由模型生成文本中反复出现的词汇、句式、标点和篇章结构模式。破折号本身当然不能证明一段文字由 AI 生成,但在足够长的文本中,某些标点的异常高频使用会成为一种可观察的统计特征。
因此,Opus 5.5 将破折号从 15.2 个降到 0.8 个,并不意味着模型“不会写复杂句子”了。更准确的解释是,它把原来集中在一句话里的多个关系拆开了,更多使用短句、句号和直接陈述来组织内容。
数据显示:句子更短,回答却更长
Opus 5.5 的变化并不是单纯地把回答压缩成更短的版本。Arena 的数据表明,新模型平均句长为 10.03 个单词,Opus 5 为 12.14 个单词;与此同时,Opus 5.5 的平均回答长度从 453 个单词增加到 481 个单词。
也就是说,Opus 5.5 使用了更多短句,却给出了更长的整体回答。这两个数字放在一起,反而更能说明它的写作策略发生了变化:模型正在减少单句内部的复杂嵌套,但没有同步减少信息量。
| 指标 | Claude Opus 5 | Claude Opus 5.5 | 变化 | |---|---:|---:|---:| | 每 1,000 个单词的破折号数量 | 15.2 | 0.8 | 下降约 95% | | 每 1,000 个单词的分号数量 | 6.10 | 1.64 | 下降约 73% | | 平均句长 | 12.14 个单词 | 10.03 个单词 | 下降约 17.4% | | 平均回答长度 | 453 个单词 | 481 个单词 | 增加约 6.2% | | 写作指标改善方向 | 12 项中的基准 | 12 项中 10 项改善 | 约 83.3% 指标改善 |
这里有一个值得注意的细节:回答变长不等于模型变得更啰嗦。判断模型是否冗长,不能只看总字数,还要看每句话承载的信息、重复内容的比例,以及结论是否提前出现。
如果一个 500 字的回答在开头就给出明确结论,后面再按原因、证据和限制条件展开,它可能比 400 字但需要读者读到最后才能找到重点的回答更高效。相反,如果总字数增加只是因为模型加入更多礼貌用语、重复总结和无关背景,那就是另一回事。
从目前披露的数据看,Opus 5.5 更像是在调整信息的排列方式:句子更短,重点更靠前,回答的总展开幅度没有缩小。这也与 Anthropic 对新模型沟通方式的描述一致,即减少术语和特有表达,更遵循用户给出的写作规则。
“告别 Claude体”不只是少用几个标点
Claude 体的核心问题,从来不只是破折号太多,而是模型经常采用一种过度完整、过度礼貌、过度解释的回答结构。
典型的 Claude 回答往往包含以下几个步骤:先确认用户的问题,再重述任务背景,然后列出分析框架,接着给出主要结论,最后补充例外情况和下一步建议。这种结构适合复杂咨询,也容易让人感觉模型认真、稳妥,但在简单任务中会显得拖沓。
更麻烦的是,当模型判断错误时,这种表达方式会放大问题。它可能用大量限定词和解释包装一个并不可靠的结论,让读者误以为回答经过了更充分的论证。部分用户觉得 Claude “讨好”,并不是因为它总是直接说好,而是因为它经常通过温和的语气、完整的铺垫和多轮确认来降低冲突感。
Opus 5.5 如果能把最重要的信息放在前面,价值在于降低了用户的阅读和核查成本。开发者排查一个计费 bug 时,需要先知道问题在哪里,再决定是否查看完整推理过程;产品经理让模型整理用户反馈时,需要先得到主题和优先级,而不是先读一段方法论说明;研究人员让模型比较两篇论文时,也更关心结论、证据和不确定性分别是什么。
这是一种从“把过程写得完整”转向“把信息交付得有效”的变化。
Arena 数据能说明多少问题
Arena 是一个通过用户对模型回答进行比较来评估模型表现的平台,Text Arena 则主要收集文本任务中的模型回复并进行偏好比较。此次分析使用的是 2026 年 8 月和 9 月的高推理回复,Arena 观察了 12 项写作指标,其中 10 项朝其认定的改善方向变化。
这个结论有参考价值,但不能被理解为 Anthropic 官方发布了一份完整的风格评测报告。首先,样本来自特定时间段和特定平台,不能覆盖 Claude 在所有产品、系统提示词和用户任务中的表现。其次,“改善方向”是 Arena 根据可读性和 AI 特征等指标设定的判断,不等同于所有读者都会认可的文学或编辑标准。
另外,统计上的标点下降也可能受到任务分布影响。技术解释、开放问答、创意写作和代码审查,对句长与标点的要求并不一样。如果 Opus 5.5 在样本中处理了更多结构清晰的任务,部分指标也可能随之变化。
但这并不削弱结果的意义。破折号从 15.2 个降到 0.8 个,变化幅度已经足够大,不太可能只是随机波动。分号也同步下降,平均句长和回答长度朝不同方向移动,说明这更像是一次系统性的生成风格调整,而不是单个提示词带来的偶然结果。
对开发者和深度用户意味着什么
对于需要把模型输出直接交付给人的团队,Opus 5.5 的风格变化可能比某项抽象基准提升更重要。
第一,编辑成本可能下降。新闻摘要、产品说明、研究简报和内部报告往往需要人工二次修改。过去,编辑需要频繁删除套话、拆分长句、替换连续破折号,并把结论从段落后面提到开头。如果 Opus 5.5 在默认状态下已经完成一部分工作,后处理链路会更短。
第二,AI 生成文本的统一腔调可能有所减弱。企业不希望所有客服回复、知识库文章和营销文案都像同一个模型写出来的。减少固定标点和句式,能够降低文本的可识别性,但不能把它等同于“绕过 AI 检测”。AI 检测器本身存在误判,改变标点也不能解决事实错误、内容重复和缺乏个人经验等更深层问题。
第三,代码和技术文档的可读性可能受益。技术回答如果把多个条件都塞进一个长句,读者需要反复回看主语和逻辑关系。短句化之后,错误原因、影响范围、修复建议和验证步骤更容易分别检查。不过,句子更短并不代表技术内容更准确,开发者仍然需要核对版本号、配置项、边界条件和实际行为。
第四,提示词设计的重点会发生变化。过去不少用户会在提示词中明确要求“少用破折号”“不要使用 Claude 风格”“像人类编辑一样写作”。如果模型默认风格已经调整,这些约束可以减少,提示词可以更多用于规定受众、证据标准、输出结构和决策边界。
与其他模型相比,风格仍然是产品差异
模型写作风格是模型在默认情况下组织信息、表达不确定性和处理用户指令的稳定倾向。它不是模型能力的全部,但会直接影响使用成本。
GPT 系列通常更倾向于明确分点,Gemini 在长文档和多模态任务中强调上下文覆盖,DeepSeek 等模型在中文技术问答中常见更直接的推导风格,而 Claude 长期以来以长上下文、代码能力和完整解释见长。不同模型的差异不只是跑分,也包括“它会怎样把答案交给你”。
| 模型写作维度 | Opus 5.5 当前表现 | 对用户的实际影响 | |---|---|---| | 句子长度 | 平均 10.03 个单词 | 更容易扫描和逐句核查 | | 破折号使用 | 每 1,000 个单词 0.8 个 | 减少明显的模型腔 | | 分号使用 | 每 1,000 个单词 1.64 个 | 降低复杂并列句比例 | | 总体回答长度 | 平均 481 个单词 | 信息展开并未明显缩减 | | 结论位置 | 更强调先给重点 | 适合报告、排障和摘要场景 |
从这个角度看,Anthropic 的调整并不是让 Claude 变成另一个模型,而是在保留长上下文和复杂任务能力的同时,修正默认沟通方式。它希望模型仍然能解释复杂问题,但不要每次都像在写一份咨询报告。
这次调整也有代价
更少的破折号和更短的句子不必然意味着更好的写作。复杂概念有时需要长句来表达条件嵌套,分号也不是错误标点。模型如果为了降低某项可识别指标而机械拆句,可能导致语气变得过于碎片化,甚至损失逻辑关系。
平均回答长度增加,也意味着用户不能只根据“看起来更像人”来判断效率。对于需要快速获得结论的任务,481 个单词可能仍然偏长;对于需要完整研究综述的任务,453 个单词又可能远远不够。真正重要的是模型能否根据任务自动切换详细程度,而不是固定保持某一种风格。
此外,写作特征变得不明显,并不代表模型输出更原创。模型仍可能重复训练语料中的常见表达,也可能在事实判断上犯错。对于法律、医疗、金融、生产环境代码等高风险内容,清晰的表达只能提高审查效率,不能替代来源核对和专业审核。
OpenAI Hub 判断
Claude Opus 5.5 这次最值得关注的升级,不是“少用了 95% 的破折号”这个容易传播的数字,而是 Anthropic 开始把写作风格当成模型能力的一部分来优化。
过去,模型评测更关注准确率、上下文长度、代码通过率和推理分数。现在,用户已经开始对模型的表达方式提出更具体的要求:能不能先说结论,能不能少套话,能不能区分事实与推测,能不能在长文中保持自然的节奏。模型如果能力很强,却总是以高密度模板化语言输出,用户仍然需要承担额外的编辑成本。
Opus 5.5 给出的方向是合理的:减少高频、固定的 AI 标记,缩短句子,把重要信息提前,同时保留足够的解释长度。它还没有证明自己在所有写作任务中都更好,但至少从 Arena 的 12 项指标和具体数值来看,这不是一次表面改名,而是一次可观测的默认行为变化。
对开发者而言,最值得做的不是简单地把 Opus 5.5 当成“更像人”的写作工具,而是重新测试自己的真实工作流:同一份提示词下,它是否更快给出结论;技术文档是否更容易审阅;长回答是否减少重复;在要求严格格式时,是否更稳定地遵循指令。
如果这些变化能够在代码审查、研究摘要和团队知识库中持续出现,Opus 5.5 才算真正解决了“Claude体”带来的效率问题。少几个破折号只是表面现象,模型能否用更低的阅读成本交付同等甚至更多有效信息,才是这次更新的核心。
参考来源
- IT之家:AI 写作特征减少:Claude Opus 5.5 破折号使用量下降约 95%、分号下降 73%:本文核心数据来源,包含 Arena 对 2026 年 8 月和 9 月 Text Arena 高推理回复的分析。
- 知乎:实测 Opus 5.5:一句提示词造出 100 个网页,还会做动画谱曲:补充用户对 Opus 5.5 写作风格变化的实际体验。