B站开源翻译模型,覆盖150种语言
9月30日,哔哩哔哩 Index LLM 团队发布 Index-Translate 多语言翻译模型家族,开放 2B、9B 与 35B-A3B Preview 权重,覆盖 150 种语言,并延伸至语音、音节控制和长文档翻译。
B站开源 Index-Translate:150种语言只是起点
9 月 30 日,哔哩哔哩 Index LLM 团队正式发布 Index-Translate 多语言翻译模型家族,并将 2B、9B 和 35B-A3B Preview 三个文本模型的权重开放到 Hugging Face 与 ModelScope。
Index-Translate 是一组基于 Qwen3.5 构建、面向翻译任务优化的多语言模型。它的文本模型覆盖包括中文和英文在内的 150 种语言,同时支持术语约束、格式保留、指定内容不翻译等指令。
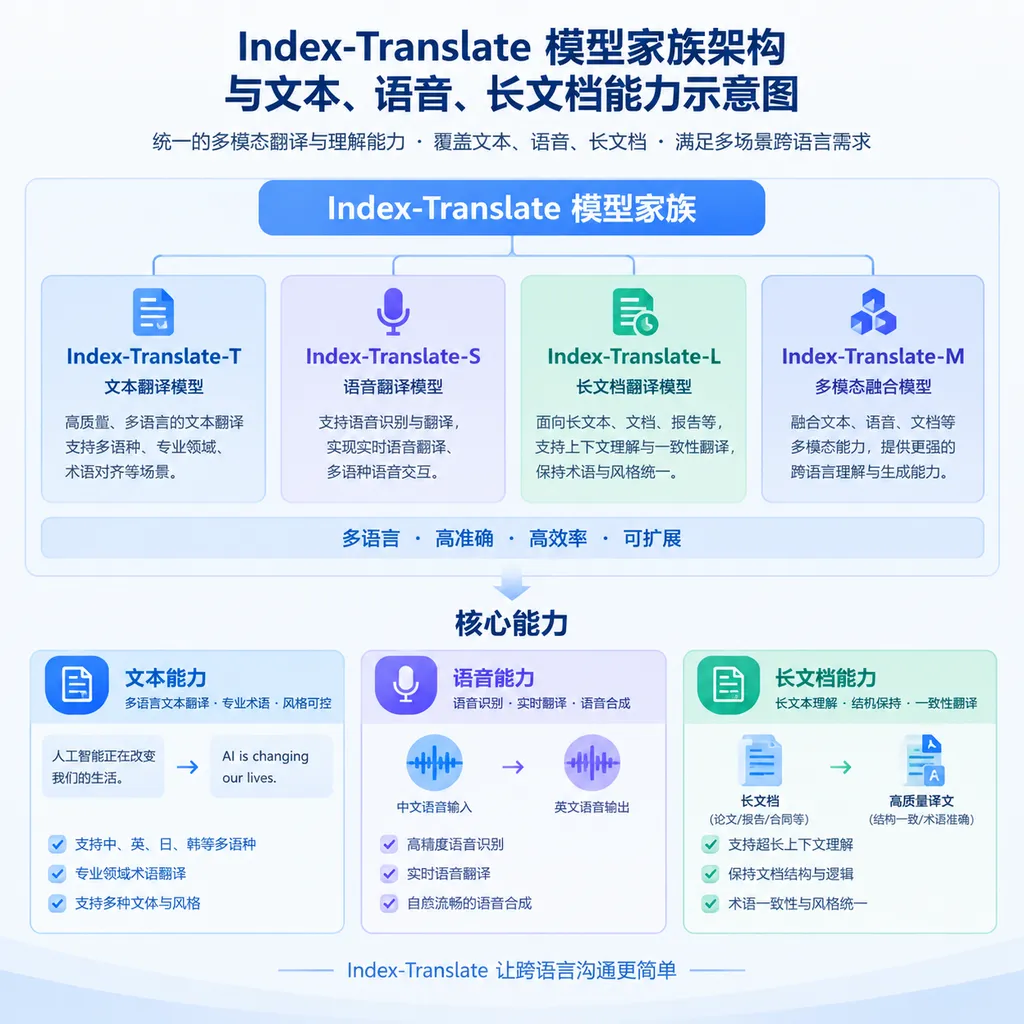
这次发布值得关注的地方,不只是语言数量。B站试图把翻译从一句话的语言转换,扩展成一套围绕内容生产的模型能力:Index-Translate 负责文本、结构化内容和社区表达,Index-Echo 处理字幕与配音,Index-Homura 控制译文的音节长度,Index-NativeLong 则针对长文档中的上下文一致性进行优化。
换句话说,它瞄准的不是单纯的机器翻译评测,而是视频字幕、游戏文本、社区内容、本地化发行和长篇文档这些更容易暴露模型短板的场景。
150 种语言之外,真正的竞争在指令跟随
多语言翻译模型是能够在多种语言之间进行文本转换,并根据上下文、术语和格式要求生成目标语言内容的模型。对于开发者和深度用户来说,支持多少种语言只是第一层指标,更重要的是模型能否理解翻译任务的边界。
传统机器翻译通常默认用户只需要一段通顺译文,但真实工作流往往复杂得多。用户可能要求产品名不翻译、代码变量保持原样、专有名词统一、Markdown 结构不变,或者只翻译某个字段。Index-Translate 将术语、格式和保留内容作为可控制的翻译指令,说明它更接近大语言模型驱动的翻译工作流,而不是单一的句对句转换器。
从产品定位看,Index-Translate 的优势可能集中在三件事上:
- 术语和专名控制:适合游戏、影视、软件和品牌内容的本地化,减少同一个名字在不同段落中被翻译成不同写法。
- 结构化内容保留:面向表格、Markdown、字幕和带标签文本时,模型需要同时处理语言转换与结构约束。
- 非标准表达理解:面对网络流行语、社区黑话和语境化表达,模型不能只依赖词典匹配。
这也是它与传统翻译引擎的分界线。传统系统更擅长稳定、规整、可预测的句子;大模型则更有机会理解省略、隐喻和社区语境,但代价是输出稳定性、事实一致性和推理成本仍需要验证。
一个社区梗,能看出模型的差距
官方展示的案例是游戏社区表达:原文为“狒瘾犯了就去打”。在该语境中,“狒瘾”并不是“猴子上瘾”,而是玩家想玩《最终幻想 XIV》的劲头又上来了,“去打”也指重新进入游戏游玩。
Index-Translate-9B 的译文是:When the FFXIV itch hits, just go play.
Index-Translate-2B 的译文是:Go play when my FFXIV addiction kicks in.
作为对照,Hy-MT2-7B 给出的结果是:If you get monkey addiction, go fight.
这个例子并不能证明 Index-Translate 在所有语言、所有领域都更强,但它清楚展示了翻译模型最难处理的一类问题:词面正确并不等于语义正确。前两种译文都抓住了“想玩 FFXIV 的冲动”,并将“去打”还原成了“去玩”;对照模型则基本按字面拆解,生成了“猴子上瘾”和“去战斗”。
对游戏公司、字幕组和社区内容运营者来说,这类差异比普通新闻句子的语法质量更重要。机器翻译真正节省人工成本的前提,不是每句话都能翻译,而是能少把关键梗翻错。
当然,官方精选案例属于定向展示,不能替代公开评测。Index-Translate 是否在 WMT、Flores 或特定行业测试集上具备稳定优势,目前参考资料没有给出完整分数、语言对拆分和人工评测方法。150 种语言也不意味着每种语言都拥有相同的训练规模和翻译质量,低资源语言的实际表现仍需社区测试。
Index-Homura:把译文写进节奏里
Index-Homura 是能够按照目标音节数调整译文的翻译模型。它面向的是字幕、歌词、配音台词和短视频文案等场景,在这些场景中,译文不仅要表达原意,还必须适配画面时长、口播节奏或旋律结构。
官方使用“生活两天,是一种什么体验”进行测试,并为英文译文设置 10、14 和 18 个音节的目标长度。Index-Homura-9B 分别生成:
| 目标音节数 | 实际音节数 | 英文译文 | | ---: | ---: | --- | | 10 | 10 | To live for two days. What would that be like? | | 14 | 14 | What would it be like to live there for two days, I wonder? | | 18 | 18 | What would it be like to live there for two days, trying to get by somehow? |
这里的价值不在于把一句话机械地缩短或拉长,而在于模型需要同时处理语义和长度约束。普通翻译模型往往先生成最自然的译文,再由人工压缩;音节可控模型则把“能不能唱、能不能念、能不能对上嘴型”提前纳入生成过程。
不过,音节数控制仍然不是完整的配音对齐方案。英文音节和中文汉字并非一一对应,实际配音还涉及重音、语速、停顿、口型和情绪。Index-Homura 更适合作为本地化初稿和候选生成器,不能直接等同于完成后的专业字幕或歌曲改编工具。
Index-Echo:翻译开始进入声音层
Index-Echo 是面向目标语言字幕和配音生成的模型,配音时可以参考源语音中的说话人声音特征。
这意味着 Index-Translate 家族并不把语音翻译停留在“语音识别、文本翻译、语音合成”三个模块的简单串联,而是试图保留说话人的听觉身份。对于知识视频、游戏直播、纪录片和跨语言内容分发,这种能力可以减少重新录音的时间,并让同一个角色在不同语言版本中保持更一致的声音印象。
但声音特征参考也带来更高的合规要求。实际部署时,需要明确说话人授权、声音数据使用范围和合成内容标识,尤其是在影视、直播和商业广告场景。官方资料目前主要强调能力方向,关于声音克隆的具体输入格式、授权机制、模型边界和安全策略,还需要等待正式文档进一步说明。
Index-NativeLong:长文档翻译的核心是人物和术语一致
Index-NativeLong 是面向长文档翻译的模型,能够输入完整文档,并利用上下文维持前后内容的一致性。它的简称被写作 Index-Nailong,定位则是解决长篇翻译中常见的跨段落一致性问题。
长文档翻译最难的部分,往往不是单句语法,而是模型在几十页之后是否还记得前文。人物姓名、地名、称谓、物品和世界观术语一旦发生漂移,读者就会怀疑是不同角色,或者误以为剧情出现了新设定。
官方案例是一篇约 32K tokens 的奇幻文本,其中“王妃”是人物姓名。对比结果显示,同一个 9B 模型在原生全文翻译与采用相邻上下文、自动词表的分块翻译中,对该人物的识别并不稳定:
| 文档位置 | Index-NativeLong-9B 原生全文 | 同一 9B 模型分块翻译 | | ---: | --- | --- | | 31.3% | Mentor Wang Fei | Instructor Wangfei | | 56.6% | Wang Fei | the Dean | | 84.8% | Wang Fei | The Queen Consort |
这个结果很有代表性。它说明长文翻译的质量不能只看某一段译文是否流畅,还要看模型是否建立了跨章节的实体记忆。分块翻译如果没有共享词表和上下文,可能把同一个人名先当成姓名,再当成职务,最后又翻译成身份称谓。
Index-NativeLong 的方向是对的:直接利用完整文档上下文,减少人工维护词表的工作。但 32K tokens 仍然只是特定案例,不能直接推导出它能处理多长的小说、技术手册或法律合同。长上下文窗口越大,显存占用和推理成本通常也越高;模型是否会在更长文本中出现注意力稀释、早期信息遗忘或错误传播,还需要更多公开测试。
三个尺寸,覆盖本地部署到高质量生成
Index-Translate 文本模型目前提供 2B、9B 和 35B-A3B Preview 三种规模。2B 和 9B 属于相对容易本地部署的密集模型,35B-A3B 则采用参数规模更大的混合专家路线,但目前仍是预览版本。
| 模型 | 参数规模 | 当前状态 | 更适合的场景 | 主要取舍 | | --- | ---: | --- | --- | --- | | Index-Translate-2B | 2B | 正式开放权重 | 本地翻译、批量初译、边缘设备实验 | 资源占用较低,但复杂语境上限有限 | | Index-Translate-9B | 9B | 正式开放权重 | 通用翻译、社区表达、字幕初稿 | 质量与部署成本相对平衡 | | Index-Translate-35B-A3B | 35B-A3B | Preview | 高质量翻译、复杂语境、研究测试 | 能力潜力更高,但部署和稳定性要求更高 |
这里需要区分“总参数量”和“每次激活参数量”。35B-A3B 中的 A3B 通常表示混合专家模型在一次推理中激活约 3B 参数,但实际显存占用、加载方式和吞吐表现仍取决于具体实现,不能简单按照 3B 模型的成本估算。
对个人用户而言,2B 是最容易尝试的入口;9B 更可能成为质量和速度之间的平衡点;35B-A3B Preview 则更像面向研究者和企业团队的能力验证版本。真正决定模型能否进入生产环境的,还包括许可证、量化支持、批处理吞吐、长上下文限制以及 150 种语言的具体覆盖清单。
它与通用大模型是什么关系
Index-Translate 不是一个面向所有任务的通用聊天模型,而是基于 Qwen3.5 构建、针对翻译与内容本地化场景优化的模型家族。它的价值在于把通用大模型的指令理解能力,集中用于翻译约束、跨语言表达和长上下文一致性。
与通用模型相比,专用翻译模型通常有三个潜在优势:输出格式更可控、任务边界更清晰、同等硬件下推理效率可能更高。与传统机器翻译系统相比,它们更擅长理解语境、处理网络表达和执行复杂指令。
但专用模型也有明确边界。当前官方公开信息没有完整披露训练数据规模、训练语料构成、不同语言对的评测分数、幻觉率以及商业许可证细节。因此,不能仅凭 150 种语言和几个案例,就断言 Index-Translate 已经全面超过 Google Translate、DeepL、GPT 系列或其他开源翻译模型。
更准确的判断是:B站把翻译模型的竞争从“覆盖多少语言”推进到了“能否控制翻译结果”。如果后续能补齐系统评测、许可证说明和可复现推理配置,它有机会成为开源多语言本地化工具链中的重要组件;如果缺少这些信息,它目前仍更适合开发者试用和社区验证。
对开发者和内容团队意味着什么
对于开发者,Index-Translate 的价值主要在于可以围绕开源权重构建本地化工作流,例如批量翻译 Markdown 文档、游戏对话、字幕文件、知识库和社区帖子,同时保留术语表和原始格式。
对于视频团队,Index-Echo 与 Index-Homura 提供了从文本翻译到字幕、配音和节奏适配的延伸方向。过去需要分别寻找翻译、字幕、配音和音频后期工具,现在可以尝试围绕同一多语基础模型搭建流程,降低不同模块之间的风格漂移。
对于游戏和软件公司,Index-NativeLong 关注的是本地化最昂贵的部分:术语维护、角色名统一和上下文审校。它不能取代人工编辑,但如果能稳定减少返工次数,价值可能比单句 BLEU 分数提升更直接。
截至 2026 年 9 月 30 日,Index-Translate 最值得观察的不是它是否马上成为“最强翻译模型”,而是 B站能否把 150 种语言、声音生成、音节控制和长文档一致性真正整合成可用的开源产品。首批权重已经开放,下一步应当由社区用真实的游戏文本、长篇小说、字幕和低资源语言数据,检验它在官方案例之外到底能走多远。
参考来源
- IT之家:B站开源 Index-Translate 多语言翻译模型家族,文本模型支持 150 种语言:提供 2026 年 9 月 30 日发布信息、模型规模、能力介绍和官方案例。
- Index-Translate Hugging Face 模型页面:用于查看社区公开的 Index-Translate 模型权重与相关文件,具体信息以模型卡为准。