Qwen正在接管音频模型底座
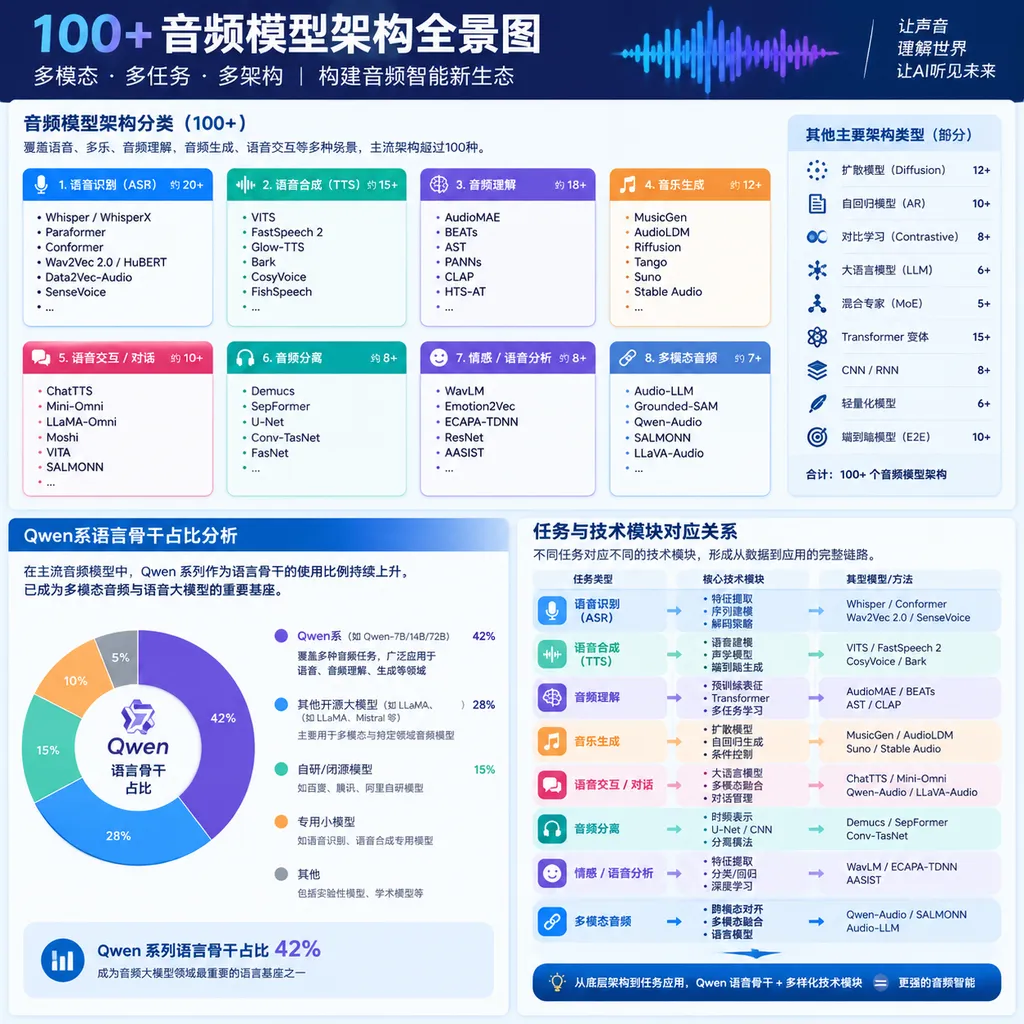
一份覆盖100多个音频模型的架构图显示,32个模型家族采用Qwen系语言骨干,其中20个直接使用Qwen3。Qwen的角色正从语音识别和对话,扩展到TTS、音乐生成、语音到语音以及音视频模型。
Qwen正在接管音频模型底座
一份最近在 Reddit Machine Learning 社区发布的音频模型架构统计显示,在作者梳理的 100 多个音频模型家族中,有 32 个采用了 Qwen 系列架构作为语言骨干,其中 20 个明确使用 Qwen3 LLM。
这个数字还不是一份官方产业统计,也不等于 Qwen 在所有音频模型中的市场份额,但它足以说明一个变化:Qwen 已经不只是“一个能听懂语音的开源模型”,而正在成为音频模型堆栈里最常见的语言推理层之一。
更值得注意的是,Qwen 的覆盖范围已经超出传统语音识别和文本转语音。根据这份架构图,基于 Qwen 的模型正在出现在语音合成、ASR 与音频理解、音乐生成、语音到语音、音频生成以及音视频模型等多个方向。
这不是“Qwen做了一个音频模型”那么简单
音频语言模型是能够接收声音、理解声音内容,并通过语言模型完成识别、推理或控制的多模态模型。它通常由音频编码器、连接模块和语言模型三部分组成,而语言模型决定了系统如何理解上下文、组织答案和执行复杂任务。
传统音频模型往往是一项任务对应一套模型:ASR 负责把语音转成文字,TTS 负责把文字变成语音,音乐模型负责生成旋律,声纹模型负责识别说话人。这种架构在单项指标上可能很强,但每增加一种能力,就要重新训练一套系统,模型之间也很难共享上下文。
Qwen 系列的价值,首先在于它提供了一个相对成熟的“语言中枢”。音频编码器负责把声音压缩成模型能处理的表示,Qwen 负责把这些表示放进更大的语义、指令和推理框架里。简单说,前者解决“听到了什么”,后者解决“应该如何理解和回应”。
Qwen2-Audio 的结构已经体现了这条路线:模型将音频编码器与 Qwen 语言模型连接起来,再通过多任务预训练完成音频和语言的对齐,之后使用监督微调与偏好优化适配具体场景。它的输入可以是语音、自然声音、音乐和歌声,输出则以文本为主。
这类架构的关键并不是把一个普通 LLM 外接麦克风,而是让音频 token 能够进入语言模型的上下文。只要连接方式、训练数据和任务设计足够成熟,同一个语言骨干就可以被重新适配到会议转写、声音问答、环境声音分析,甚至更复杂的音频生成任务中。
32个家族,20个Qwen3:数字说明了什么
这份统计最有价值的地方,不是给出一个“谁赢了”的榜单,而是把音频模型背后反复出现的技术模块画了出来。作者从 audio.cpp 生态中的模型和实现出发,整理了 100 多个音频模型家族的共同组件,并进一步分析语言骨干、音频编码器、生成模块和任务之间的组合关系。
统计结果显示,Qwen 系列是这组样本中最常见的语言骨干,共有 32 个音频模型家族使用 Qwen-family architecture,其中 20 个具体采用 Qwen3 LLM。
这里需要做一个重要区分:使用 Qwen 作为语言骨干,不代表这些模型是 Qwen 官方发布的模型,也不代表它们在所有任务上都优于其他方案。很多团队会保留自己的音频编码器、扩散模块或声学解码器,只把 Qwen 当作理解、规划、对话和指令跟随的核心模块。
但从工程角度看,频繁复用本身就是信号。模型开发者通常不会无缘无故选择一个语言底座。Qwen 的吸引力很可能来自几个现实因素:开放权重、中文和多语言能力、较成熟的工具链、较强的指令跟随能力,以及开发者已经积累的大量微调和部署经验。
| 语言骨干 | 在这份音频模型统计中的数量 | 主要价值 | 典型适用方向 | |---|---:|---|---| | Qwen 系列 | 32 个模型家族 | 开放权重、语言理解和指令能力较完整 | ASR、TTS、音频理解、音乐和音视频 | | 其中 Qwen3 | 20 个模型家族 | 更适合承担复杂推理和多轮交互 | 实时语音、语音 Agent、跨模态任务 | | 其他语言模型骨干 | 未在原统计中统一披露 | 依赖具体模型和授权方式 | 专用语音、研究型或垂直场景 |
这组数字还反映出另一个事实:音频模型正在从“专用声学模型”变成“带有声音输入输出的通用智能体”。当系统需要理解一段会议录音、判断环境里的异常声音、根据自然语言修改音色,或者在对话过程中继续执行任务时,单纯的声学网络已经不够用了。
Qwen的角色,正在从“听懂”扩展到“组织声音”
Qwen-Audio 是阿里云推出的大规模音频语言模型,能够接收人类语音、自然声音、音乐和歌声等多种音频,并以文本形式输出理解结果。它的重要性不只在于支持了更多输入类型,而在于尝试用统一语言接口处理不同声音。
Qwen2-Audio 则进一步把重点放在语音交互和音频分析上。官方公开信息显示,Qwen2-Audio-7B 与 Qwen2-Audio-7B-Instruct 已经开源,并支持语音对话、音频分析以及超过 8 种语言和方言。它还在 LibriSpeech、Common Voice 15、Fleurs、Aishell2、CoVoST2、MELD、VocalSound 和 AIR-Benchmark 等数据集上进行评测。
这条路线对后续模型的影响在于:音频不再只是一个输入模态,而是变成了语言模型上下文的一部分。模型可以把“有人在说话”“背景里有警报声”“这句话带有犹豫和自我修正”放进同一个推理过程,而不是交给互相独立的几个分类器处理。
到了 Qwen3-TTS 以及更近期的 Qwen-Audio-3.1 系列,Qwen 相关技术开始覆盖生成端。Qwen3-TTS 家族支持中文、英语、日语、韩语、德语、法语、俄语、葡萄牙语、西班牙语和意大利语等 10 种主流语言。Qwen-Audio-3.1 系列则把能力拆分为 ASR、ASR-Next、TTS 和 TTS-Next 等方向。
其中,TTS-Next 的产品思路已经不再是“输入一句文字,输出一段人声”,而是根据文本、时间戳和参考音频,统一生成对白、音效与环境声。对于播客、有声书、游戏和影视后期,这意味着声音制作流程可能从多轨人工剪辑,变成由模型先生成完整场景,再由创作者做局部修改。
这类模型真正难的地方不在于能不能发声,而在于能否维持角色、情绪、节奏和声场的一致性。多人对话中,角色不能每句话都变声;跨语言合成时,音色不能因为语言变化而失真;环境声也不能盖住对白。Qwen 系列如果要成为这类系统的语言骨干,就必须同时承担脚本理解、角色管理、情绪控制和时间结构规划。
为什么开发者更愿意复用Qwen
开放权重是 Qwen 被广泛采用的第一层原因。音频模型通常需要大量定制:有的团队要接入自己的声学编码器,有的要改变采样率和上下文长度,有的要把语言模型嵌入实时 Agent。相比完全封闭的模型,开放权重更适合做这些结构级修改。
多语言和中文能力是第二层原因。很多音频产品并不只面对标准英语。中文普通话、方言、夹杂英文的会议、行业术语和中英混读,都要求语言骨干具备稳定的文本建模能力。对于国内开发者而言,Qwen 在中文语境中的可用性降低了从音频到语言的适配成本。
生态成熟度是第三层原因。一个音频模型团队真正需要的,通常不只是权重文件,还包括 Transformers 支持、量化方案、推理框架、社区样例和可复现的微调路径。语言底座越常见,围绕它形成的工程经验越多,团队从实验走向部署时的不确定性越低。
Qwen3 的出现还加强了它在复杂音频任务中的吸引力。音频 Agent 不仅要把声音转成文字,还要判断用户意图、调用工具、记住上下文并处理打断。对这类任务来说,语言模型的推理和指令跟随能力往往比单纯的 ASR 词错率更重要。
不过,复用 Qwen 也有明显代价。第一,语言骨干并不能自动解决音频生成问题。音频编码、连续声学表示、离散音频 token、扩散或自回归解码,仍然是独立且复杂的技术环节。第二,大量模型使用相同底座,可能导致能力趋同,产品差异被压缩到数据、后训练和解码器层面。第三,Qwen 适合做语言中枢,并不意味着它在所有低延迟、极端长音频或高保真音乐任务上都是最优选择。
对音频模型开发者意味着什么
对于开发者来说,最重要的变化是模型选型的重心正在从“找一个最大的音频模型”,转向“设计音频系统的模块分工”。一个可用的系统通常至少包含以下部分:
- 音频前端:负责降噪、分帧、特征提取和音频编码。
- 语言骨干:负责上下文理解、指令跟随、对话管理和任务规划。
- 声学或生成模块:负责把文本、音色、节奏和情绪转换成可播放声音。
- 实时调度层:负责流式输入、端点检测、打断处理和首字响应。
- 后处理模块:负责说话人分离、时间戳、标点、敏感内容控制和音频混音。
Qwen 在这里更像一个可替换但高价值的中枢,而不是一套完整的音频产品。开发者需要根据任务判断:是要文本输出还是语音输出,是要单轮转写还是多轮交互,是要稳定的低延迟还是高保真的离线生成。
如果目标是会议记录,重点应该放在长音频上下文、说话人标签、时间戳、行业词和流式转写,而不是盲目追求更大的语言模型。如果目标是语音 Agent,首字响应、打断恢复和工具调用可靠性可能比离线基准上的少量提升更重要。如果目标是音乐或影视声音生成,则必须单独评估旋律结构、声场一致性、版权数据和长时序稳定性。
Qwen-Audio-3.1-ASR 的公开信息提供了一个较具体的参考:该系列覆盖 30 种语言和 16 种中文方言,支持说话人标签、时间戳、专业词和长音频上下文,并宣称首字响应约 160 毫秒。其在 KeSpeech 和 WSYue 的 11 个子集上测试时,平均字符错误率为 4.55%,并在其中 6 个子集取得最优结果。
这些数字有参考价值,但不能直接等同于真实产品体验。字符错误率主要衡量转写准确性,无法完全反映重叠说话、噪声、情绪理解、端点检测和对话延迟。开发者在选型时,应该把公开基准拆成自己的业务测试集,尤其要加入真实录音中的口音、远场噪声、多人抢话和专业实体。
“主流语言骨干”还不是“主流音频模型”
把 Qwen 称为音频模型的主流语言骨干,是一个关于架构复用的判断,而不是性能冠军的结论。那份 Reddit 统计覆盖的是作者能够收集和识别的模型,样本可能受到开源社区关注度、代码可见性和 audio.cpp 生态偏好的影响。大量闭源商业模型并不公开内部语言骨干,因此不会出现在这类图表中。
另外,32 个模型家族和 20 个 Qwen3 模型的统计口径也需要谨慎理解。模型家族、模型版本和衍生项目并不是同一概念;一个家族可能包含多个尺寸、多个任务版本,多个项目也可能只是共享底座而不是共享完整架构。它适合用来观察趋势,不适合作为严格的市场份额报告。
但即便考虑这些限制,趋势仍然清晰:音频模型的竞争正在向“谁能更好地把声音接入通用语言智能”转移。Qwen 的优势并不是单点指标突然甩开所有对手,而是它在开放权重、中文能力、语言推理、工具生态和可改造性之间形成了相对均衡的组合。
接下来要看三件事
第一,Qwen 系列能否在实时音频上继续降低延迟。对于语音 Agent,160 毫秒左右的首字响应只是一个环节,端到端体验还取决于音频上传、端点检测、语言模型首 token、声码器启动和网络抖动。真正自然的对话,需要把这些延迟叠加控制在用户几乎察觉不到的范围内。
第二,Qwen 能否把“理解音频”和“生成完整声音场景”统一起来。ASR、TTS、环境声理解和音乐生成目前仍然存在明显的模块边界。未来更有竞争力的系统,可能不再把音频看成一串需要转写的语音,而是同时理解内容、说话人、情绪、空间和事件,并能以结构化方式编辑这些信息。
第三,开发者是否会继续围绕 Qwen 形成事实标准。语言骨干一旦被大量项目复用,模型权重格式、音频 token 接口、训练配方和部署工具就可能逐步标准化。这会降低新团队进入音频领域的门槛,但也会让数据质量、后训练能力和产品交互成为更关键的差异来源。
截至 2026 年 9 月,Qwen 还不能被简单概括为“音频领域唯一的底座”。但从公开模型的架构复用情况看,它已经从一个可选方案变成了开发者必须认真评估的默认选项。更准确的说法是:未来的音频模型未必都由 Qwen 驱动,但越来越多音频模型的语言理解、任务规划和多轮交互,正在采用 Qwen 的方式来完成。
这才是这份架构图最值得关注的地方。音频模型的主战场,已经不只是让机器听得更准、说得更像,而是让声音成为通用智能系统可以理解、推理和创作的另一种语言。
参考来源
- Reddit:Qwen-family LLMs are quietly becoming the backbone of modern audio models:统计 100 多个音频模型架构,并给出 Qwen 系列语言骨干的数量观察。
- Qwen-Audio GitHub 镜像页面:介绍 Qwen-Audio 与 Qwen-Audio-Chat 的模型定位、输入输出形式及开源信息。
- Qwen-Audio 模型页面:介绍 Qwen-Audio 作为大规模音频语言模型支持的音频类型。
- Qwen2-Audio 官方项目页面:提供 Qwen2-Audio 系列模型和相关开源信息。
- IT之家:阿里千问发布 Qwen-Audio-3.1 系列语音大模型:整理 Qwen-Audio-3.1 系列的 ASR、TTS、音频生成和实时交互能力信息。