Janus 开源:一套 Vulkan 跑遍三家显卡
Janus 是一个用 Go 编写的本地 GGUF 推理工具,通过 Vulkan 同时支持 AMD、Intel 和 NVIDIA 显卡。它没有重新发明模型格式,而是试图用更低的安装和适配成本,把跨厂商 GPU 推理做成一个可分发的单文件工具。
Janus 开源:一套 Vulkan 跑遍三家显卡
近日,开发者 Vibra-Ingenn 在 Hacker News 发布了 Janus 项目:这是一个用 Go 编写的本地大语言模型运行工具,能够通过 Vulkan 加载并运行 GGUF 模型,并覆盖 AMD、Intel、NVIDIA 三家主流 GPU 平台。
Janus 是一个基于 Go 和 Vulkan 的 GGUF 本地推理工具,目标是在不依赖 CUDA 的情况下,让不同厂商的显卡共享同一套模型运行路径。
这件事的价值不在于又多了一个聊天窗口,而在于它瞄准了本地 AI 生态里一个长期存在、但一直没有被彻底解决的问题:模型文件已经逐渐统一,硬件加速却仍然高度碎片化。
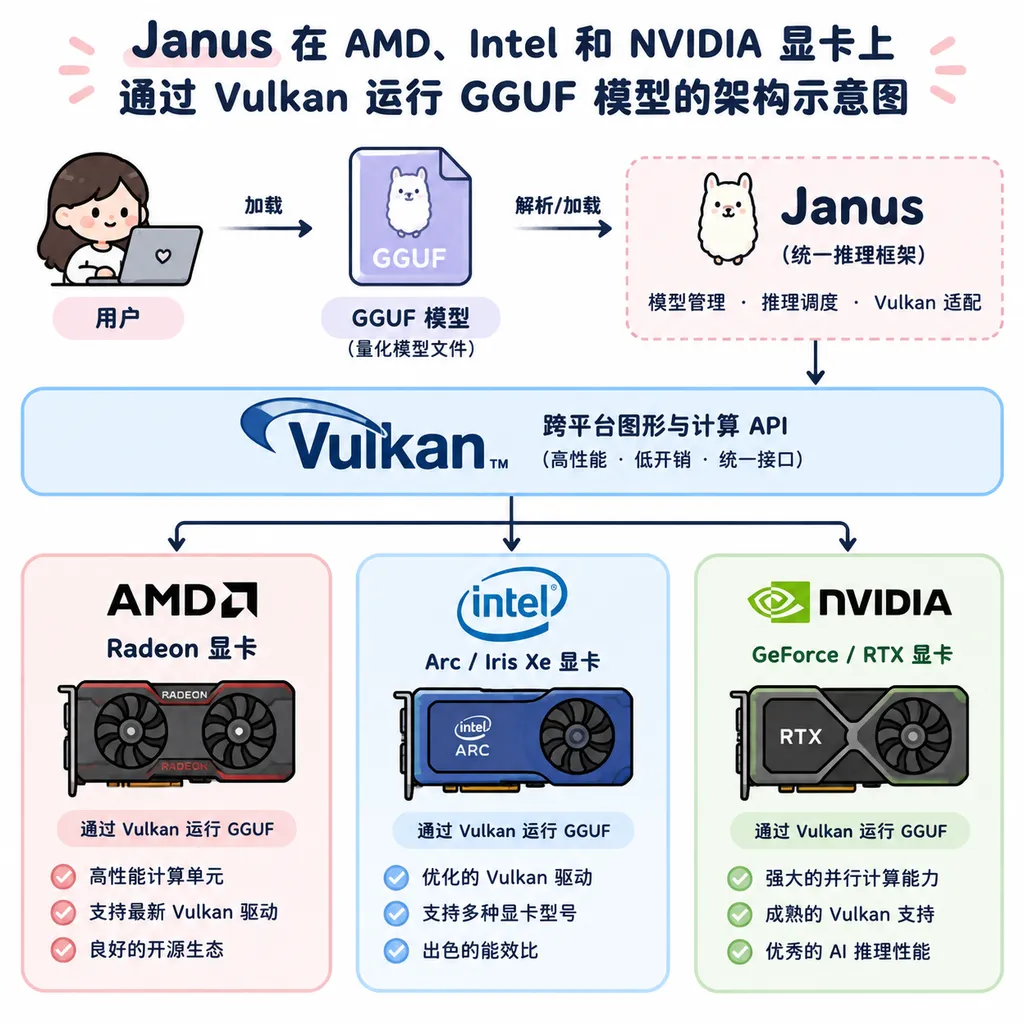
Vulkan 解决的是什么问题
Vulkan 是一个跨平台的低开销图形与计算 API,能够直接调用现代 GPU 的计算能力。与 NVIDIA 专属的 CUDA 不同,Vulkan 不绑定单一显卡厂商,因此理论上可以在支持 Vulkan 的 AMD、Intel 和 NVIDIA GPU 上运行相同的计算程序。
本地大模型工具过去常见的路线大致分成三类:
- CUDA:NVIDIA 生态最成熟,性能和算子支持通常最好,但不能直接覆盖 AMD 和 Intel 独立显卡。
- ROCm:AMD 的 GPU 计算平台,适配范围和安装体验近年来有所改善,但硬件、驱动和系统组合仍然比较敏感。
- Metal:苹果平台的原生 GPU 框架,在 Apple Silicon 上体验较好,但无法解决 Windows x86 电脑的显卡兼容问题。
Vulkan 则像一层共同的硬件语言。它不一定在每一张卡上都能达到 CUDA 的极限性能,但可以显著减少“换一张显卡就要换一套后端”的麻烦。
Vulkan 后端的核心优势是硬件覆盖面,而不是在所有设备上都提供最高吞吐量。 对于拥有 AMD 显卡、Intel Arc,或者不想安装 CUDA 和 ROCm 的 NVIDIA 用户,这种取舍有现实意义。
Janus 为什么选择 GGUF
GGUF 是一种面向大语言模型推理的文件格式,由 llama.cpp 生态推动普及。它把模型权重、量化信息、词表以及架构元数据放进同一个文件,方便在本地应用之间分发和加载。
GGUF 是一种将量化模型权重和运行所需元数据封装在一起的本地推理文件格式。 与需要多个配置文件、运行时和框架配合的模型目录相比,GGUF 更接近“下载一个文件即可加载”的分发方式。
量化是 GGUF 在本地运行中最重要的特性之一。以一个 7B 规模模型为例,FP16 权重通常需要约 14GB 显存或内存,仅权重就可能超过普通消费级显卡的可用空间;如果转换为 Q4 量化版本,模型文件通常可以压缩到约 4GB 至 5GB,代价是一定程度的精度损失。
常见量化等级可以这样理解:
| 量化格式 | 典型特点 | 适合场景 | | --- | --- | --- | | Q4_K_M | 文件较小,速度和质量较均衡 | 8GB 显存、普通家用电脑 | | Q5_K_M | 比 Q4 保留更多权重信息 | 追求质量且显存稍充足 | | Q6_K | 质量更接近高精度模型 | 12GB 以上显存或大内存设备 | | Q8_0 | 接近原始权重质量,文件更大 | 对输出质量敏感的本地部署 | | F16 | 半精度原始权重,资源占用最高 | 高显存设备或研究用途 |
Janus 因此并不负责重新训练模型,也不是一个新的模型家族。它的定位更接近一个推理运行时:用户准备好兼容的 GGUF 文件,Janus 负责把模型加载进 CPU 或 GPU,并完成文本生成。
它和 Ollama、llama.cpp、LM Studio 有什么区别
Janus 所处的赛道并不空白。Ollama、llama.cpp、LM Studio、GPT4All 和 Jan 等工具,已经覆盖了从命令行到桌面 GUI 的多个本地运行场景。Janus 的差异主要在于实现方式和分发形态。
| 工具 | 主要定位 | GPU 后端特点 | 使用门槛 | 更适合谁 | | --- | --- | --- | --- | --- | | Janus | Go 编写的 Vulkan GGUF 运行工具 | 面向 AMD、Intel、NVIDIA 的统一 Vulkan 路径 | 偏命令行和工程化 | 想要轻量、跨厂商运行时的用户 | | llama.cpp | 成熟的本地推理底座 | CUDA、Metal、Vulkan、CPU 等后端较多 | 需要理解参数和编译选项 | 开发者、性能调优用户 | | Ollama | 易用的本地模型服务工具 | 默认体验偏向成熟平台,后端由运行时管理 | 较低 | 想快速拉取和切换模型的用户 | | LM Studio | 桌面端模型管理和聊天应用 | 依赖系统与后端配置 | 很低 | 需要图形界面的普通用户 | | GPT4All | 桌面端本地 AI 应用 | 偏向开箱即用和兼容性 | 很低 | 低配置电脑和轻量聊天场景 | | Jan | 开源桌面端本地 AI 应用 | 依赖系统和具体后端 | 较低 | 需要完整 GUI 工作流的用户 |
Janus 的竞争力不在于功能数量,而在于用一个较小的运行时覆盖多个 GPU 厂商。 如果用户只是想在桌面上下载模型、打开聊天窗口,LM Studio 或 Jan 的产品完成度仍然更高;如果用户需要稳定的本地服务接口、模型管理和生态兼容,Ollama 的成熟度也更强。
Janus 更像是一个值得关注的底层工具,尤其适合希望绕开 CUDA 依赖、直接测试 Vulkan GPU 推理的开发者。
单文件分发是另一个卖点
Janus 使用 Go 编写,这个选择直接影响了它的分发方式。Go 程序通常可以编译为单个可执行文件,减少 Python 虚拟环境、依赖包和复杂构建链带来的安装成本。
这里需要区分两个概念:Go 二进制本身可以比较容易地分发,但 GPU 推理仍然依赖操作系统中的 Vulkan 驱动。换句话说,Janus 可以把应用层压缩成一个文件,却不能绕过显卡驱动、Vulkan loader 和具体 GPU 驱动的安装要求。
Janus 的单文件优势主要体现在应用依赖简单,不代表用户完全不需要安装显卡驱动。 如果系统无法正确识别 Vulkan 设备,或者驱动版本缺少必要能力,Janus 仍然无法凭空解决底层环境问题。
对 Linux 用户而言,需要重点检查显卡驱动和 Vulkan 运行库是否正常;Windows 用户则需要确认显卡驱动已经安装,并且系统能够枚举对应的 Vulkan 设备。AMD、Intel 和 NVIDIA 三家硬件的驱动质量、算子支持和显存管理仍可能存在差异。
真正的性能,不能只看“支持 Vulkan”
“支持 AMD、Intel、NVIDIA”听起来很有吸引力,但这句话不等于三家显卡都能获得相同的推理速度。
大模型推理性能至少受到以下因素影响:
- 显存带宽:生成速度经常受限于权重读取,而不是纯粹的计算能力。显存带宽越高,模型权重搬运通常越快。
- 显存容量:模型权重、KV Cache 和运行缓冲区需要共同占用显存。显存不足时,部分层会退回系统内存,速度可能明显下降。
- 量化格式:Q4、Q5、Q8 的模型大小和计算路径不同。更高精度通常需要更多内存,也可能降低吞吐量。
- 上下文长度:上下文从 4K 增加到 32K,KV Cache 占用会显著增加,长对话不一定能保持短文本生成时的速度。
- 算子实现:不同 GPU 对矩阵乘法、注意力机制和量化算子的支持情况不同,统一 API 并不意味着统一性能。
- 驱动和后端成熟度:Vulkan 驱动对计算能力的暴露程度,会直接影响实际结果。
因此,目前不能仅凭项目支持的 GPU 列表,就断言 Janus 比 CUDA、ROCm 或 Metal 更快。参考项目公开信息,Janus 的主要卖点是跨厂商运行和较轻量的 Go 二进制形态,而不是已经公布一组全面、可复现的三家 GPU 对比跑分。
在没有统一模型、统一量化、统一上下文和统一驱动版本的基准测试之前,Janus 的“跨平台”应理解为兼容性承诺,而不是性能承诺。
对于实际部署,建议至少记录以下指标:
- 首 token 延迟,也就是输入提示词后生成第一个 token 所需的时间;
- 生成速度,通常以 tokens/s 表示;
- 提示词处理速度,尤其是长文档场景;
- 显存占用和系统内存占用;
- 模型加载时间;
- 长上下文运行时是否发生显著降速或崩溃。
只有在这些条件一致的情况下,Janus 与 llama.cpp Vulkan、CUDA 后端或其他本地运行工具的比较才有意义。
对 AMD 和 Intel 用户更有价值
Janus 最明确的受益人不是已经拥有成熟 CUDA 工作流的 NVIDIA 用户,而是 AMD 和 Intel 显卡用户。
NVIDIA 用户通常可以直接使用 CUDA 后端,相关文档、量化内核和性能优化积累更丰富。除非用户希望减少 CUDA 依赖,或者需要在多种显卡之间共享部署脚本,否则 Janus 未必会立刻改变其工作流。
AMD 用户则经常需要在 Vulkan、ROCm、DirectML 和 CPU 后端之间做选择。ROCm 对硬件型号、操作系统和版本组合较为敏感,Vulkan 虽然不一定能提供最优性能,却可能是一条更容易启动的路径。
Intel Arc 用户的情况也类似。Arc 显卡并非不能运行本地模型,但不同框架对其支持程度并不一致。一个能通过 Vulkan 直接识别并运行 GGUF 的工具,至少可以降低测试门槛,让用户不用先投入大量时间研究 CUDA 替代方案。
不过,跨厂商兼容的代价也很现实:后端需要在共同能力上工作,厂商专属优化未必能够完全利用;当模型使用新算子、特殊注意力结构或更激进的量化方案时,兼容性和性能都可能落后于专门优化的实现。
Janus 现在适合做什么
从项目定位看,Janus 当前更适合以下几类任务:
- 在没有 CUDA 的 AMD 或 Intel 电脑上快速测试 GGUF 模型;
- 在多台不同厂商显卡的机器上维持相对统一的本地运行方式;
- 将本地模型推理作为桌面工具或轻量服务的一部分进行集成;
- 验证 Vulkan 后端对特定模型和量化格式的支持情况;
- 在不希望安装完整 Python 深度学习栈的设备上运行小型指令模型。
它不一定适合直接承担高并发生产服务,也不应被当作 vLLM、TensorRT-LLM 或成熟 CUDA 推理栈的替代品。Janus 目前更像一个面向本地推理的轻量实验平台:它把“能不能运行”这一步做得更容易,但距离在所有硬件上都达到最佳性能,还有很长的工程距离。
对于显存有限的电脑,模型选择比运行时名称更重要。8GB 显存或 8GB 系统内存设备,不应盲目加载 7B 以上高精度模型;小型 1B 至 4B 指令模型配合 Q4_K_M 量化,通常比强行运行大模型更稳定。上下文长度也应从较小值开始,再根据显存和内存余量逐步增加。
还需要观察哪些进展
Janus 能否成为长期有影响力的本地运行时,取决于后续工程细节,而不仅是首个版本能否启动模型。
第一是模型兼容范围。GGUF 虽然已经覆盖大量 Llama、Qwen、Mistral、Gemma 和 DeepSeek 系列模型,但不同模型架构需要不同的张量、词表和采样处理逻辑。项目需要持续跟进 GGUF 元数据和主流模型架构变化。
第二是 Vulkan 算子覆盖。基础矩阵乘法只是起点,注意力、RoPE、MoE 路由、量化解码和 KV Cache 管理,都会影响真实推理速度。尤其是 MoE 模型,如何避免不必要的数据搬运,可能决定 Vulkan 后端能否在大模型上保持竞争力。
第三是多 GPU 和异构内存支持。许多本地用户并非只有一张同型号显卡,模型层分配、CPU/GPU 混合推理以及多卡通信,都会显著增加实现复杂度。
第四是可复现基准。项目如果能公布 AMD、Intel、NVIDIA 三个平台上的统一测试结果,包括模型版本、量化格式、驱动版本、上下文长度、首 token 延迟和 tokens/s,用户才能准确判断它与其他工具的差距。
第五是 Windows 体验。Vulkan 本身跨平台,但 Windows 上的驱动识别、显存分配和不同 GPU 共存问题,往往比 API 设计更影响普通用户能否成功运行。项目资料如果能够提供稳定的预编译版本、设备选择参数和错误诊断信息,实际使用门槛会进一步下降。
OpenAI Hub 判断
Janus 值得关注,但它目前更像“跨厂商 Vulkan 运行时的有潜力尝试”,还不是本地大模型工具的全面替代者。
它最有价值的地方,是把 AMD、Intel 和 NVIDIA 放进同一条 GGUF 推理路径里,并通过 Go 二进制降低应用层依赖。对于不想折腾 CUDA、ROCm,或者需要在不同 GPU 设备之间迁移本地模型的用户,这个方向比又做一个模型管理 GUI 更有技术含量。
但也要保持克制:Vulkan 解决的是后端统一问题,不会自动解决驱动质量、显存不足、算子缺失和量化兼容问题。没有公开且可复现的性能数据之前,不能把“支持三家显卡”翻译成“性能超过三家原生后端”。
如果你使用 AMD 或 Intel 显卡,Janus 值得下载测试;如果你是 NVIDIA 用户并且已经用 CUDA 跑得稳定,迁移的理由主要是减少环境依赖,而不是期待必然的速度提升。对于所有用户,最实际的评估方法仍然是用自己常用的 GGUF 模型,在相同上下文和量化配置下测量首 token 延迟、生成速度和显存占用。
这也是 Janus 目前最准确的定位:它不是一个新的大模型,而是一条试图让本地 GGUF 推理摆脱单一 GPU 厂商绑定的技术路线。随着本地 AI 从“能不能跑”进入“在哪张卡上稳定跑、跑得是否足够快”的阶段,这类跨后端项目的价值会越来越明显。
参考来源
- Janus GitHub 仓库:项目主页、实现方式与安装信息,本文关于 Janus 的核心事实来源。
- Janus-Pro-1B-GGUF 模型页:用于说明 GGUF 量化文件的常见规格与文件大小差异。需要注意,Janus 项目与 DeepSeek 的 Janus-Pro 模型不是同一个项目。
- Hugging Face GGUF 模型生态:用于了解 GGUF 模型的分发方式和可选模型范围。