12GB显卡跑125B模型
开源推理引擎 Strata 让 RTX 5070 这类 12GB 显卡运行量化版 Qwen3.8-Flash-Next,官方测试 Q2_0 达到 94 token/秒。它并没有把 125B 参数硬塞进显存,而是用 RAM、SSD 和 CPU 与 GPU 协同完成推理。
12GB 显卡跑 125B 模型,Strata 把本地推理的边界往前推了一步
开源推理引擎 Strata 在 2026 年 10 月初引发关注:它可以让一张只有 12GB 显存的消费级显卡运行量化版 Qwen3.8-Flash-Next,并在 RTX 5070 上测得最高 94 token/秒的生成速度。
这个数字最容易被误读。Strata 并没有把 1250 亿个参数完整装进 12GB 显存,也没有创造一种能无损压缩模型的魔法。它真正做的事情,是把一个本来按照“显存大小”设计的推理问题,改造成 GPU、系统内存、CPU 和 SSD 共同参与的调度问题。
这也是 Strata 值得关注的地方:它证明了对于拥有稀疏激活结构的超大模型,消费级显卡的显存容量未必等于模型能否运行的硬门槛。代价则是更复杂的内存管理、更高的系统内存要求,以及量化精度和长上下文下仍然需要验证的性能波动。
先看结论:它跑得快,但不是把服务器塞进了台式机
Strata 是一个面向大规模稀疏模型的本地推理引擎,核心目标是在显存有限的消费级电脑上运行 Qwen3.8-Flash-Next 这类 MoE 模型。MoE,即混合专家模型,是一种只激活部分专家网络来处理每个 token 的模型架构。
根据项目公开测试,在 RTX 5070 12GB、AMD Ryzen 5 7600 和 64GB 系统内存的平台上,Qwen3.8-Flash-Next 的不同量化版本表现如下:
| 量化版本 | 显存配置 | 生成速度 | 读取提示速度 | 主要取舍 | |---|---:|---:|---:|---| | Q2_0 | RTX 5070 12GB | 94 token/秒 | 2650 token/秒 | 速度最高,压缩最激进 | | IQ2_XS | RTX 5070 12GB | 79 token/秒 | 2090 token/秒 | 速度与质量折中 | | IQ3_XXS | RTX 5070 12GB | 62 token/秒 | 1750 token/秒 | 精度进一步提高 | | IQ3_S | RTX 5070 12GB | 53 token/秒 | 1620 token/秒 | 质量更好,速度下降 | | Coder | RTX 5070 12GB | 55 token/秒 | 2180 token/秒 | 面向代码任务的专用量化 |
在 AMD Radeon RX 9070 XT 16GB 平台上,Q2_0 版本的生成速度约为 60 token/秒。不同平台之间不能简单用显存大小判断结果,显卡计算能力、驱动、CPU、内存带宽以及 Strata 对具体硬件的适配程度,都会影响最终速度。
94 token/秒对应的是短对话场景和 Q2_0 量化,并不意味着用户无论输入多长提示词、选择哪个量化版本,都能稳定获得同样的速度。公开资料显示,随着上下文长度增加,解码速度会下降;有测试记录显示,Q2_0 在 6.4 万 token 上下文时约为 76.2 token/秒。这个数字仍然很快,但已经明显低于短上下文下的峰值。
Qwen3.8-Flash-Next 为什么能被这样拆开运行
Qwen3.8-Flash-Next 是阿里巴巴 Qwen 团队于 2026 年 8 月推出的多模态 MoE 模型,拥有 1250 亿参数、约 510 亿参数的 n-gram 嵌入表,并原生支持 262K token 上下文长度。
MoE 模型的关键特征是“总参数很多,但每次计算只用其中一小部分”。据公开介绍,Qwen3.8-Flash-Next 包含 24576 个专家,每个 token 只激活其中 10 个。也就是说,模型的存储规模接近 125B,但单个 token 的实际计算路径远小于一个同等规模、每次都激活全部参数的稠密模型。
可以把它理解成一家拥有 24576 名专家的公司。公司档案全部存在,但每个客户只会被转交给其中 10 名最合适的专家。传统推理框架可能倾向于把更多专家放进显存,换取稳定的访问速度;Strata 则试图预测哪些专家最常被调用,把它们放在显存中,把其余专家放到更大的系统内存里。
这解释了为什么 12GB 显存能够参与运行一个 125B 模型:12GB 只需要容纳当前计算必需的常驻数据、活跃专家缓存和中间状态,而不是整个模型的全部量化权重。
不过,“只激活少量参数”不等于“模型只占少量空间”。所有专家仍然需要被保存,且模型运行时需要频繁访问它们。因此,Strata 的最低配置仍然包括 32GB 系统内存和 80GB 存储空间,推荐使用 SSD;实际使用中,64GB 内存更合理。
Strata 的两项关键技术
第一层:把专家权重放进 RAM,而不是强行塞进 VRAM
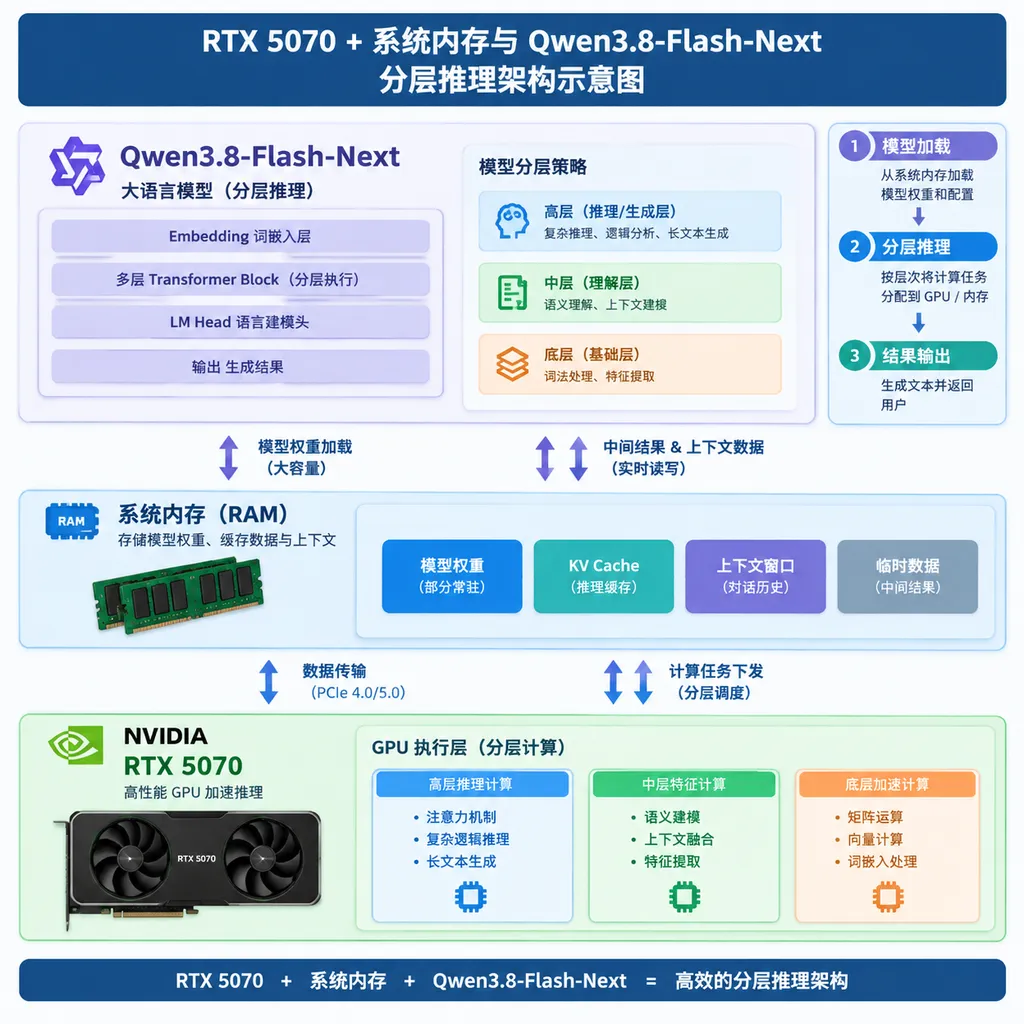
Strata 的第一项核心技术,是将 MoE 模型整体加载到系统内存,再把高频使用的专家加载到 GPU 显存。
传统 GPU 推理的思路比较直接:模型权重放入显存,GPU 负责尽可能多的计算。问题是,量化后的 125B 模型仍然远超 12GB 显存容量。Strata 采用的是分层存储:显存负责高频和低延迟数据,RAM 保存大部分模型专家,SSD 则承担加载模型文件和部分更大规模的数据承载。
这种方法的收益是降低显存门槛,代价是数据移动和缓存命中率变得重要。如果当前 token 恰好需要一个已经位于显存中的热门专家,计算可以较快完成;如果需要访问冷门专家,就必须由系统内存甚至 CPU 参与处理,速度会受到影响。
这不是简单的系统交换分区,也不是把显存不足的问题交给操作系统随机处理。Strata 需要理解 MoE 的专家路由结果,并主动维护专家缓存,尽量把高频路径留在 GPU 上。缓存策略做得好,GPU 就像一个容量不大但速度很快的“工作台”;RAM 则像后方仓库,保存完整库存。
第二层:用投机解码减少大模型的等待次数
Strata 的第二项技术是投机解码。投机解码是一种让小模型先提出多个候选 token,再由大模型批量验证的推理加速方法。
正常生成时,大模型每次只能确定下一个 token,生成一个、验证一个、再继续下一个。投机解码则让一个轻量模型先快速猜测后续内容,例如一次提出多个 token,再交给目标大模型并行检查。如果猜测大部分正确,大模型就能一次确认多个 token,减少完整推理轮次。
Strata 公开资料显示,投机解码可以带来约 1.6 至 1.8 倍的加速。这个提升并非固定值,取决于小模型与目标模型的匹配程度、任务类型以及上下文内容。普通聊天、代码补全这类具有较强局部规律的任务,通常更适合投机解码;需要频繁改变推理路径的复杂问题,候选 token 的接受率可能下降。
需要强调的是,投机解码不是降低输出质量的同义词。最终答案仍由目标大模型验证,关键在于草稿模型能否提出足够多且足够准确的候选。如果草稿模型质量不够,验证失败频繁,额外的草稿计算就可能抵消加速收益。
94 token/秒究竟意味着什么
94 token/秒已经超过大多数人阅读模型输出的速度。以中文为例,token 与汉字并非一一对应,但在短句、代码和英文混合文本中,94 token/秒足以让交互体验接近“即时输出”。
但这个数字不能直接等同于完整任务的响应速度。推理通常分为两部分:prefill 和 decode。Prefill 是模型读取用户提示词和上下文的阶段,decode 是模型逐步生成答案的阶段。
Strata 在 RTX 5070 上公开的 Q2_0 读取速度约为 2650 token/秒,生成速度约为 94 token/秒。对短问题来说,用户几乎不会感到提示词处理的延迟;对长文档、代码仓库或 10 万 token 级别的上下文来说,prefill 时间和 KV cache 占用会成为更明显的瓶颈。
| 使用场景 | 更值得关注的指标 | Strata 的实际意义 | |---|---|---| | 短聊天 | Decode 速度 | Q2_0 的 94 token/秒带来很强的实时感 | | 长文档问答 | Prefill 速度与内存容量 | 读取长上下文会增加首 token 等待时间 | | 代码补全 | 草稿模型接受率 | 投机解码可能带来更明显收益 | | 深度推理 | 输出质量与量化损失 | 不能只看 token/秒,需比较答案可靠性 | | 多轮对话 | KV cache 与上下文长度 | 上下文增长后速度和内存压力都会上升 |
因此,Q2_0 更适合追求速度和日常交互的用户,IQ3_S 则适合更重视回答质量、愿意接受约 53 token/秒速度的用户。对于代码任务,Coder 量化版本的速度约为 55 token/秒,但是否优于通用量化,仍应根据具体编程语言、仓库规模和任务类型测试。
它和传统本地推理方案有什么不同
过去运行超大模型,主流思路通常有三种:使用多张高端显卡,把模型完整切分到多张卡上;把模型大量卸载到 CPU,接受较低速度;或者选择参数规模更小的模型。
Strata 走的是第四条路线:利用 MoE 的稀疏激活特性,把“容量问题”和“计算问题”拆开处理。显存负责高频专家和高速计算,系统内存承载完整专家集合,CPU 处理部分 GPU 不适合或暂时无法覆盖的路径,SSD 负责存储和加载。
这套方法的价值不只在于让 Qwen3.8-Flash-Next 运行起来。它还说明,未来本地推理优化的竞争点可能不再只是 CUDA kernel 或显存带宽,而是模型结构、专家路由、缓存策略和异构硬件调度的组合效率。
当然,Strata 并不意味着小显存显卡已经取代了高端 GPU。服务器级显卡拥有更大的显存、更高的内存带宽和更强的并发能力,在长上下文、多用户并发和高精度量化场景下仍然占据明显优势。Strata 更像是把单用户本地推理的可行范围向前扩展,而不是重新定义生产级部署的硬件标准。
最低配置与适用人群
Strata 运行量化版 Qwen3.8-Flash-Next 的公开最低配置包括:
- NVIDIA 或 AMD 显卡,显存至少 12GB;
- 系统内存至少 32GB,实际更推荐 64GB;
- 至少 80GB 可用存储空间,推荐 NVMe SSD;
- Windows 10、Windows 11 或 Linux;
- 支持相应指令集的现代 CPU,CPU 性能和内存带宽会影响冷门专家处理速度。
它最适合三类用户。
第一类是希望在本地运行大模型、但只有一张中端显卡的开发者。对他们来说,Strata 提供了一个尝试 125B 级别模型的入口,而不必先购买多张高端显卡。
第二类是重视隐私和本地数据处理的专业用户。长文档、代码库、研究材料可以留在本机,不需要上传到远端服务。不过,本地运行并不自动解决数据安全问题,模型文件、日志、缓存和系统权限仍需自行管理。
第三类是研究推理系统的工程师。Strata 把 MoE 模型的专家缓存、异构计算和投机解码结合在一起,适合用来观察模型结构与硬件调度之间的关系。
它不太适合需要稳定多用户服务、严格延迟指标或高精度输出的生产环境。单张消费级显卡加系统内存的方案,面对并发请求时很容易出现缓存争用和延迟抖动;Q2_0 的量化损失也需要通过实际任务评估,不能只凭速度做决定。
这次发布真正重要的地方
Strata 最值得关注的不是“94 token/秒”这个孤立数字,而是它展示了一种新的本地推理组织方式:模型规模可以很大,但只要模型具备足够强的稀疏性,就有机会将存储、计算和访问路径拆给不同硬件。
Qwen3.8-Flash-Next 的 24576 个专家和每 token 激活 10 个专家,为这种设计提供了基础。Strata 再通过专家缓存和投机解码,把 12GB 显存的限制转化成了一个可以被工程优化的问题。
但这仍是一项需要继续验证的早期技术。当前公开结果主要来自项目方测试,第三方在不同显卡、不同上下文长度和不同任务上的数据还不够充分。尤其是长上下文、复杂推理、连续多轮对话和代码修改任务,才是判断它是否真正实用的关键场景。
截至 2026 年 10 月 6 日,可以给 Strata 一个相对准确的判断:它不是让 12GB 显卡“拥有了 125B 模型的全部性能”,而是让更多用户能够以可接受的交互速度运行一个原本需要服务器级硬件的大型 MoE 模型。对本地 AI 来说,这已经是一次有分量的边界推进;对准备购买硬件的人来说,则仍然应该把系统内存、SSD、上下文长度和量化质量一起纳入预算,而不是只盯着显存容量和峰值 token 速度。
参考来源
- IT之家:12GB 显存显卡跑 125B Qwen3.8 模型:Strata 登场,单张 RTX 5070 跑出 94 词元/秒:整理了 Strata 的公开配置、量化版本和 NVIDIA、AMD 平台测试数据。