Liquid AI 开源 d1,视觉 Agent 开始落地
Liquid AI 于 2026 年 10 月 5 日发布支持图像与文本输入的 d1 决策模型,并在 Hugging Face 开放模型。它在网页操作、游戏画面理解等任务中展示了视觉决策能力,但现有结果仍主要来自厂商测试,距离通用端侧 Agent 还有部署和可靠性问题要解决。
Liquid AI 把视觉输入接进了决策模型
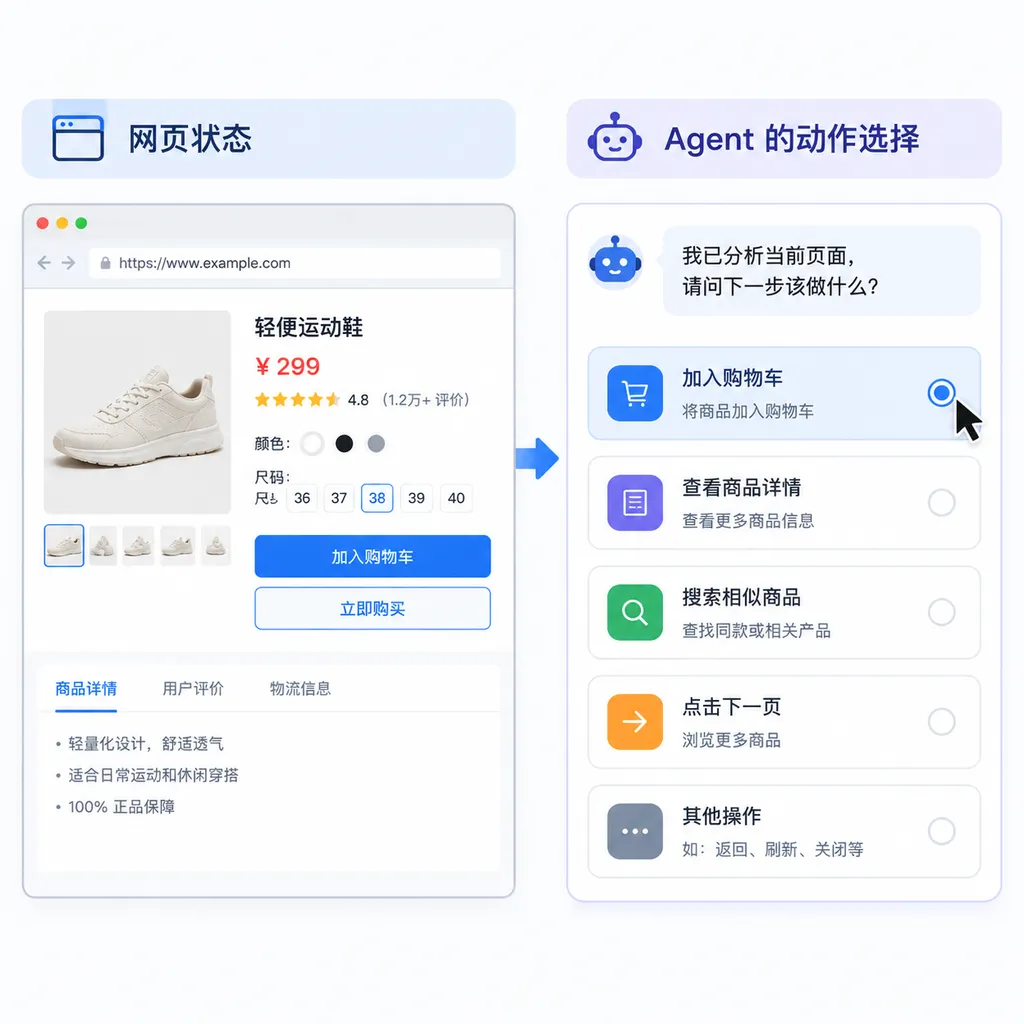
Liquid AI 于 2026 年 10 月 5 日发布支持视觉输入的 d1 决策模型,并通过 Hugging Face 开放模型。d1 的重点不是再做一个能看图聊天的视觉语言模型,而是让模型根据文本、图像或两者组合,直接选择下一步该采取的动作。对 Agent 来说,这意味着它不只需要读页面文字,也可以把屏幕截图当作当前环境状态来判断。
决策模型是把当前观察转换成下一步行动的模型。它与常见的问答模型不同:后者通常生成一段自然语言回答,前者更关心在给定任务和状态下选择哪个动作。网页自动化中的“点击搜索框”“选择日期”就是动作;游戏中的“向左移动”也是动作。d1 的产品方向,是把这种动作选择扩展到图像输入。
这件事值得关注,但不必把它读成“端侧 Agent 已经能看懂并操控一切”。目前公开材料展示的是若干具体任务和测试结果,还不足以证明模型已经能在陌生软件、复杂流程或高风险场景里稳定工作。更准确的判断是:视觉开始进入小型决策模型的输入通道,Agent 的观察方式正在从结构化文本向屏幕状态拓展。
从读网页文本到读屏幕状态
传统网页 Agent 往往依赖页面结构、可访问性树或浏览器工具提供的元素信息,再把按钮名称、链接文本等整理成模型可读的上下文。这条路径清晰、可定位,也容易调试;但遇到画布、图片化界面、自定义控件,或者工具没有暴露足够结构信息时,Agent 就可能“看不见”界面真正呈现的内容。
视觉决策走的是另一条路:模型拿到屏幕图像,结合用户目标判断页面状态,再选择下一步动作。它更像人类操作电脑时的工作方式,不需要每个应用都先把界面翻译成统一的文本结构。代价是截图中信息密度更高,模型得同时处理文字、布局和视觉状态;如果识别错了按钮、数值或页面变化,后续动作也可能一路偏下去。
这让 d1 的定位与通用视觉语言模型有所不同。通用视觉语言模型擅长描述图片、回答图像问题;决策模型则要把理解落实到动作选择。两者能力有交集,但评估标准不一样:描述得像不像,不等于操作得对不对。对于 Agent,关键问题是每一步选的动作是否符合目标,以及动作之后能否根据新状态及时修正。
厂商公布的测试结果
Liquid AI 在发布材料中列出网页操作、游戏和图像识别等示例。以下数字来自厂商公布的测试,不应直接视为独立第三方基准,也不能据此推断模型在所有应用中的表现。
| 场景 | 公布结果 | 能说明什么 | 不能说明什么 | | --- | --- | --- | --- | | Wordle | 读取棋盘截图,完成 12 局,平均每局 3.8 次猜测 | 模型可从图像提取游戏状态并参与连续决策 | 不能证明它能稳定理解任意复杂界面 | | Tetris | 加入屏幕视觉输入后,清除行数从 70 增至 81 | 视觉状态可能帮助模型改善游戏操作 | 不能单凭这一项推断普遍的视觉能力提升 | | Quick, Draw! | 在 62 个词的候选中识别 6 张涂鸦里的 5.2 张 | 模型具备一定的图像分类能力 | 不能替代对真实网页操作成功率的评估 | | 网页任务 | 根据一句话目标操作航班搜索网站 | 展示了从目标到页面动作的 Agent 形态 | 发布摘要未提供足够信息来判断跨网站泛化能力 |
这些结果有参考价值,尤其是 Wordle 测试不需要先把棋盘转写成文本,模型直接依据截图决策。但数字的边界同样重要:样本规模、失败案例、任务设置、重复运行方差和对照组细节,都会影响结果的解释。厂商演示能说明“做得到某些事”,却不能单独回答“在真实工作流里有多可靠”。
开源的价值在复现,而非标签本身
对开发者而言,模型开放的实际价值不只是可以试用,而是能进一步检查模型文件、运行要求、许可条款和推理路径,并尝试把模型放进自己的任务中。Hugging Face 页面是本次开源信息的主要入口。部署前仍应以模型仓库中的说明为准,确认具体权重、许可证、支持的运行环境和图像输入方式;现有参考材料没有给出足够信息来准确列出这些参数,因此不应凭空补齐。
“端侧”也需要拆开看。端侧推理是指模型在用户设备或本地计算环境中运行,而不是每次都把输入发往云端。模型开放并不自动等于它能在手机、笔记本或嵌入式设备上流畅运行:实际体验取决于模型规模、量化方案、内存占用、视觉编码成本、推理引擎和设备算力。当前提供的资料没有给出 d1 的参数量、量化版本、端侧速度或内存数据,所以还不能据此判断它能否在某款消费级设备上本地运行。
这点尤其影响产品落地。屏幕操作任务可能频繁截取新画面,视觉编码和动作循环会共同决定延迟;一旦模型响应慢于用户操作节奏,Agent 就容易在页面状态变化后执行过时动作。若要宣称“端侧可用”,至少还需要补上目标硬件、每步延迟、内存占用、连续任务成功率和离线运行条件等信息。
与通用视觉模型和传统自动化的区别
d1 的路线处在两类方案之间。传统自动化依靠规则、选择器和明确的界面结构,行为可预测,但每个网站或应用都可能需要适配;通用视觉模型更灵活,能描述屏幕内容,却未必擅长稳定地把理解转化成动作。决策模型试图让动作选择成为核心能力,但它仍需要与执行工具、状态检查和失败恢复机制配合。
| 方案 | 主要输入 | 优势 | 主要限制 | | --- | --- | --- | --- | | 规则式自动化 | DOM、控件标识或脚本规则 | 执行路径明确,容易复现和定位故障 | 界面变化后可能需要维护规则 | | 通用视觉语言模型 | 文本与图像 | 能解释画面、回答视觉问题 | 视觉理解不等于可靠的连续操作 | | d1 这类决策模型 | 文本、图像或两者组合 | 目标是直接从状态选择下一步动作 | 仍需验证跨任务可靠性、执行闭环与部署成本 |
实际工程中,这几类方案未必互相取代。面对固定业务系统,DOM 或控件结构通常仍是更稳妥的信号;遇到结构不可得、页面高度动态或只有屏幕截图的环境,视觉输入更有价值。成熟 Agent 也可以混合使用:优先调用稳定的结构化信息,在缺失或失效时再用视觉判断,并在关键操作后检查页面状态。
Agent 的难点不止是“看见”
把截图交给模型,只解决了感知入口的一部分。一个能用于真实工作的 Agent,还要能把目标拆解成步骤、理解动作执行结果、处理弹窗和异常,并在页面状态与预期不符时停下来或重新规划。模型如果仅仅会选下一步,却没有可靠的执行反馈和恢复机制,视觉能力越强,错误操作也可能发生得越快。
对浏览器和桌面自动化而言,权限边界同样关键。搜索航班、整理网页信息和填写订单之间,风险并不相同。删除文件、提交付款、发送消息等操作需要更严格的确认机制;不能因为模型在测试任务里表现不错,就默认把高影响操作交给它自主执行。决策模型负责建议动作,产品仍需决定哪些动作可以自动执行、哪些必须由用户确认。
因此,评价 d1 这类模型时,单看平均成功率不够。更重要的是它在哪些界面和任务上失败、失败能否被检测、是否会在信息不足时拒绝执行、错误动作是否可撤销,以及多步任务中成功率如何随步骤增加而变化。对开发者而言,任务级成功率和故障恢复能力通常比单次截图识别分数更接近真实产品价值。
这次发布的实际意义
Liquid AI 此次发布把一个值得跟踪的变化摆到了台面上:决策模型的输入不再局限于文字和结构化工具输出,屏幕图像也开始成为动作选择的依据。它降低了 Agent 面对“没有干净接口的界面”时的门槛,尤其适合评估网页操作、游戏交互和视觉状态监控等场景。
但就目前公开信息而言,最强的结论仍是“值得测试”,而不是“已经可替代现有自动化”。厂商展示了明确的任务结果,开源入口也给了开发者进一步复现和评估的机会;然而,模型参数、许可细节、端侧硬件要求以及更广泛的独立基准信息仍需从仓库和后续资料中确认。对关心端侧 Agent 的团队来说,下一步应关注的不只是模型能否看图,而是它能否在目标设备上低延迟运行,并在真实任务里稳定完成观察、行动与纠错的闭环。