LittleBit把大模型压到1比特以下
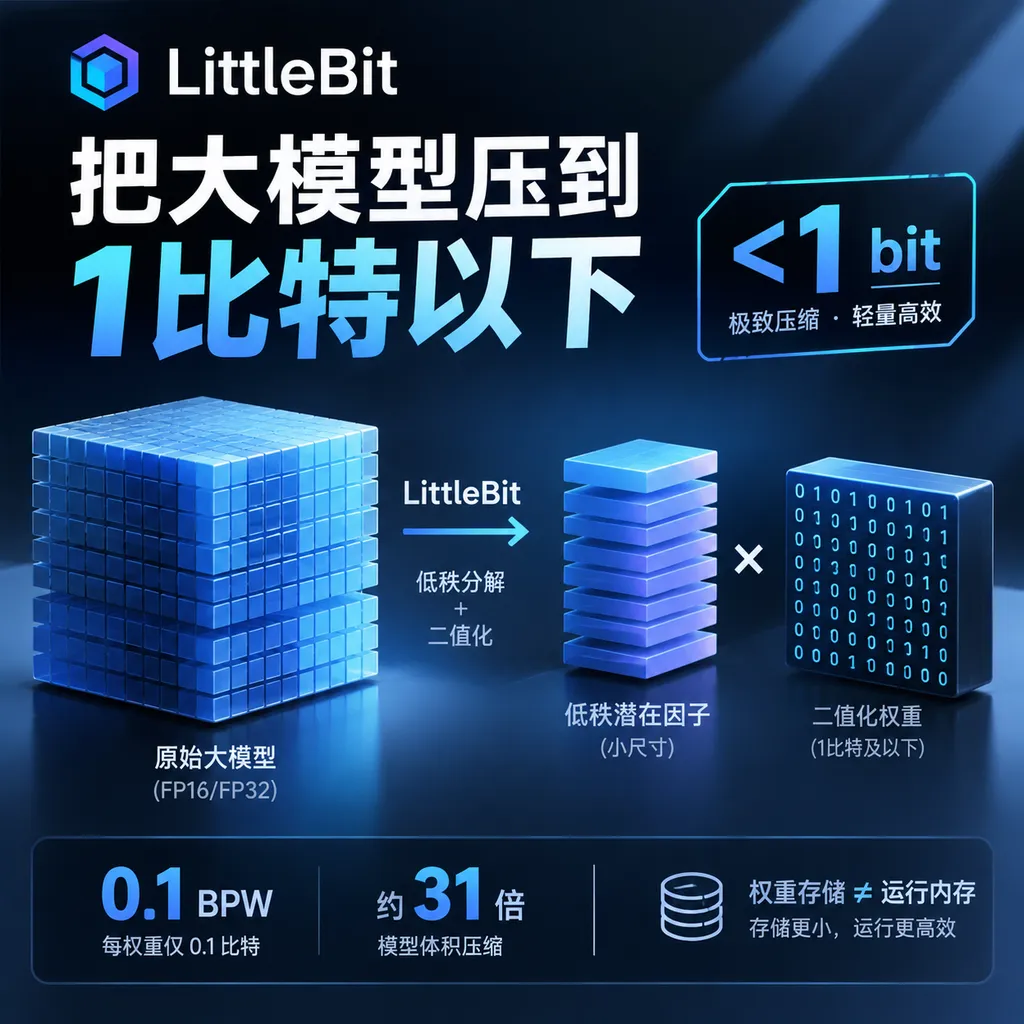
三星研究团队提出的 LittleBit 用低秩潜在因子分解与二值化,把模型权重压到每个权重低至 0.1 bit。论文已入选 NeurIPS 2025,但极限压缩下的精度、推理速度和实际部署成本仍需结合具体模型与硬件评估。
LittleBit把大模型压到1比特以下,离端侧部署还有多远
LittleBit 是一种通过潜在因子分解和二值化压缩大语言模型权重的方法,目标是把存储成本推到每个权重低于 1 bit。三星研究团队的这项工作已出现在 NeurIPS 2025 海报论文中;截至 2026 年 10 月 8 日,它更适合被看作一项已有论文与代码公开的压缩研究,而不是今天刚发布的新模型。
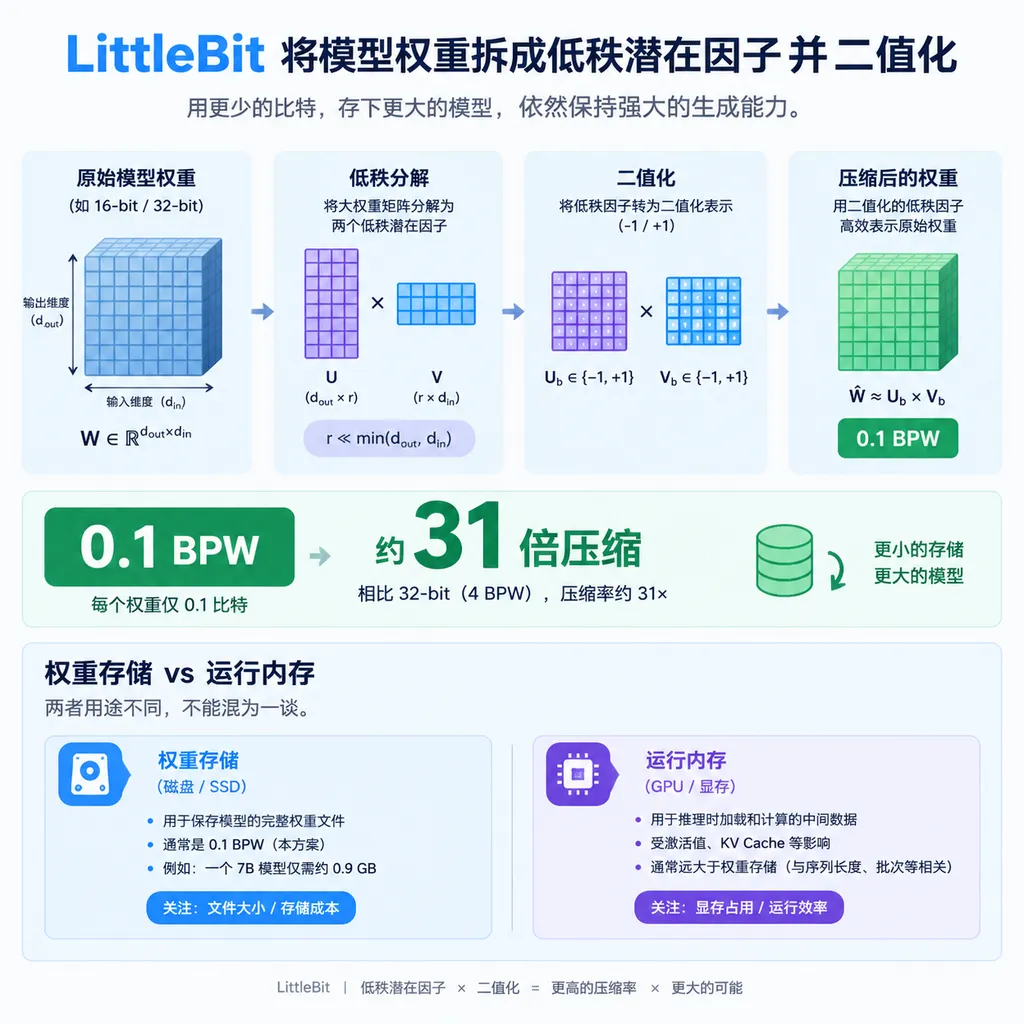
它最醒目的数字是 0.1 BPW。BPW(bits per weight,每个权重的平均比特数)表示压缩后平均用多少比特表示一个模型参数。论文称,在这个档位下,LittleBit 将 Llama 2 13B 压到 0.9 GB 以下,内存缩小约 31 倍;论文还报告 Llama 2 70B 可从约 138.04 GB 降到 2 GB 以下。不过,这些数字描述的是压缩权重的存储规模,不等于模型运行时所需的全部内存,更不意味着一台只有 1 GB 内存的设备就能顺畅运行 13B 模型。
为什么要把权重压到 1 bit 以下
量化是把模型权重从高精度数值转换成更低精度表示的技术,目的是减少存储和计算开销。常见的 8 bit、4 bit 量化仍然给每个权重分配多个比特;当模型规模达到数十亿参数时,即便降到 4 bit,显存与带宽压力也不小。LittleBit 要解决的是更激进的一档:平均表示成本低于 1 bit。
这个目标并非简单地把每个权重四舍五入成 0 或 1。权重里包含模型学到的语言、知识和行为模式,直接丢掉大部分数值精度,通常会破坏模型能力。LittleBit 的核心思路是先换一种方式表达权重:把矩阵近似表示成若干个低秩因子的组合,再对因子进行二值化。打个比方,原来要保存一张精细的高分辨率图像,现在先用几张结构更简单的图层重建它,再把每张图层压成黑白信息。省下的存储空间很可观,但重建误差也必须有人负责处理。
低秩分解加二值化,压缩的关键在误差补偿
低秩因子分解是用规模较小的矩阵组合近似原始大矩阵的方法。若一个权重矩阵里存在冗余结构,用较少的潜在维度就可能保留大部分重要信息;二值化则进一步把因子的取值限制到极少的状态,降低表示成本。两步叠加,才有机会把平均 BPW 推到 1 以下。
低比特带来的问题也很直接:被压掉的信息不会自动回来。LittleBit 为此提出多尺度补偿机制,在行、列和潜在维度上学习重要性参数,调整哪些部分更值得保留;论文还引入 Dual Sign-Value-Independent Decomposition(Dual-SVID)作为量化感知训练的初始化方法,以及 Residual Compensation(残差补偿)来缩小近似误差。量化感知训练(QAT)指在训练或适配过程中把量化误差纳入优化,让模型学会适应低精度表示,而不是训练结束后才突然压缩。
这也是 LittleBit 与“先把模型转成二值,再看输出坏成什么样”的区别。其工程价值不只在于权重变小,而在于围绕极端低精度建立一套分解、初始化和补偿流程。代价是流程更复杂,最终效果会依赖模型架构、分解秩、训练数据和具体压缩率,不是一个对所有模型都能直接套用的开关。
论文数字很亮眼,但不能只看压缩倍数
论文报告,在 Llama 2 7B 上,LittleBit 以 0.1 BPW 压缩时,表现超过了若干采用 0.7 BPW 的领先方法。这是一个值得注意的对照:在作者评测设定下,LittleBit 用更低的表示成本取得了更好的结果。但它不能被解读成“0.1 bit 的模型普遍胜过 0.7 bit”,因为压缩方法、校准或训练流程、评测任务和基座模型都会影响对比结果。
另一个值得关注的测试是 Phi-4 14B。论文摘要所述实验中,LittleBit 将它压到 0.55 BPW 后,在 7 项零样本推理任务上的平均准确率约为 52.3%;作者称其表现略低于对照方法 STBLLM。这个结果提醒读者,极端压缩并不会在所有模型和任务上产生同样收益。语言建模困惑度、常识问答准确率与长链条推理能力也不是同一个指标,不能用单一分数概括模型是否“保住了能力”。
| 比较维度 | LittleBit 论文报告 | 解读时需要留意 | |---|---|---| | 最低压缩率 | 低至 0.1 BPW | 这是平均权重表示成本,不是运行时总内存 | | Llama 2 13B | 低于 0.9 GB,约 31 倍内存缩减 | 实际部署还需计入激活值、缓存、运行时和元数据 | | Llama 2 70B | 0.1 BPW 时低于 2 GB;原始 FP16 权重约 138.04 GB | 超低权重存储不代表 70B 推理可以在普通设备上实时完成 | | Llama 2 7B | 0.1 BPW 的结果优于论文所比较的 0.7 BPW 方法 | 结论限定于作者的评测方案和比较对象 | | Phi-4 14B | 0.55 BPW 下,7 项零样本推理任务平均准确率约 52.3% | 论文同时指出相对 STBLLM 略低,显示模型间结果并不一致 | | 推理速度 | 论文提出相对 FP16 最高约 11.6 倍的潜在加速 | “潜在”不等于各硬件、各推理框架实测均达到该倍数 |
“模型压缩 31 倍”和“推理快 11.6 倍”并不是同一类承诺。压缩倍数主要描述参数表示所占空间;推理速度还取决于因子重建是否引入额外计算、硬件是否擅长执行相应操作、内存访问是否成为瓶颈,以及推理框架能否把二值运算真正映射到高效内核。换句话说,文件变小是结果,端到端加速需要软硬件共同配合。
对开发者有用的地方:先看工作负载,再看 BPW
LittleBit 最直接的潜在用途,是存储容量或权重加载带宽紧张的部署场景,例如在边缘设备上保存较大的模型,或让研究团队在有限存储空间中保留更多模型变体。对于模型提供方,降低权重占用也可能减少分发成本,让原本难以下载和缓存的权重更容易进入实验流程。
但对需要交互式生成的应用,权重文件变小并不自动解决首 token 延迟、吞吐量和上下文长度问题。生成过程还要保存 KV cache(键值缓存,即注意力机制为后续 token 复用的中间状态),并处理输入激活与临时张量。上下文越长、并发越高,这些运行内存成本越明显。若模型的量化格式必须在执行前重建为更高精度,或者推理引擎不能直接消费压缩表示,实际显存节省也可能小于文件大小给人的直觉。
因此,准备评估 LittleBit 的开发者,应该把它当成一种模型表示与压缩方案来验证,而不是先按论文里的最小体积采购或规划硬件。至少要检查四件事:目标任务在压缩后的准确率是否可接受;权重是否需要额外解码或转换;目标设备上的端到端延迟和吞吐量是多少;长上下文与多并发下的峰值内存是否仍在预算内。尤其要在相同提示集、解码设置和硬件上做对照,避免把评测集分数直接当作线上体验。
与常见低比特量化的关系
4 bit 或 8 bit 量化仍然是更成熟的部署选项,通常更容易接入现有推理栈,也更容易在精度、速度与显存之间做工程权衡。LittleBit 则把目标推到更低的存储成本,交换来的是更强的表示约束、更复杂的误差控制,以及对执行内核的更高要求。两类方案的目标不同:前者更像现成的减重工具,后者是在探索极端条件下模型还能保留多少有效能力。
| 方案方向 | 典型取舍 | 更适合优先考虑的场景 | |---|---|---| | 8 bit / 4 bit 量化 | 压缩幅度较温和,部署生态通常更成熟 | 需要较稳妥的精度与推理性能平衡 | | LittleBit 等低于 1 BPW 的方法 | 权重存储可大幅降低,但精度补偿和运行时适配更关键 | 存储限制突出、愿意做模型级评测与工程适配的场景 | | FP16 权重 | 占用较高,但作为未极限压缩的对照更直观 | 需要建立精度、延迟与吞吐基准的评测环境 |
这个比较不是说低比特一定慢,也不是说 4 bit 一定更好。LittleBit 论文提出最高约 11.6 倍的潜在推理加速,说明其设计目标不只有减小文件;但能否兑现,要看推理实现是否避免把压缩收益消耗在额外计算和数据转换上。开发者真正需要比较的是同一任务上的质量、每秒生成 token 数、首 token 延迟、峰值显存和部署复杂度,而不是只比较 BPW。
现在应该如何看待 LittleBit
LittleBit 的贡献,是把“低于 1 bit 还能不能保住模型能力”从概念讨论推进到一套可复现研究方法,并用多个模型家族展示了压缩结果。它尤其值得模型压缩研究者、端侧推理团队和受存储带宽限制的开发者关注。对于大多数需要稳定上线的应用,现阶段更合理的态度仍是把它放入候选技术栈,针对自己的模型和硬件做基准测试,而不是仅凭压缩数字替换成熟量化方案。
判断它是否真的适合部署,有三个问题比“模型能缩到多小”更重要:模型在目标业务数据上的能力掉了多少;推理引擎能否直接高效运行压缩权重;省下来的存储是否足以抵消解码、适配和验证成本。论文提供了积极信号,也暴露出不同模型和任务之间的差异。对一项极限压缩技术来说,这比一个漂亮的单点数字更有参考价值。
截至 2026 年 10 月,LittleBit 的论文和项目代码均可查阅,但具体模型权重、复现配置、支持的推理后端与硬件表现,应以项目仓库当前说明和开发者自行测试为准。它打开的方向很清楚:让大模型权重占用不再被传统多比特表示牢牢限制。距离“把任意大模型塞进手机并保持原有体验”,中间仍隔着精度、运行时和硬件支持三道关。