ALHR把注意力变成树搜索
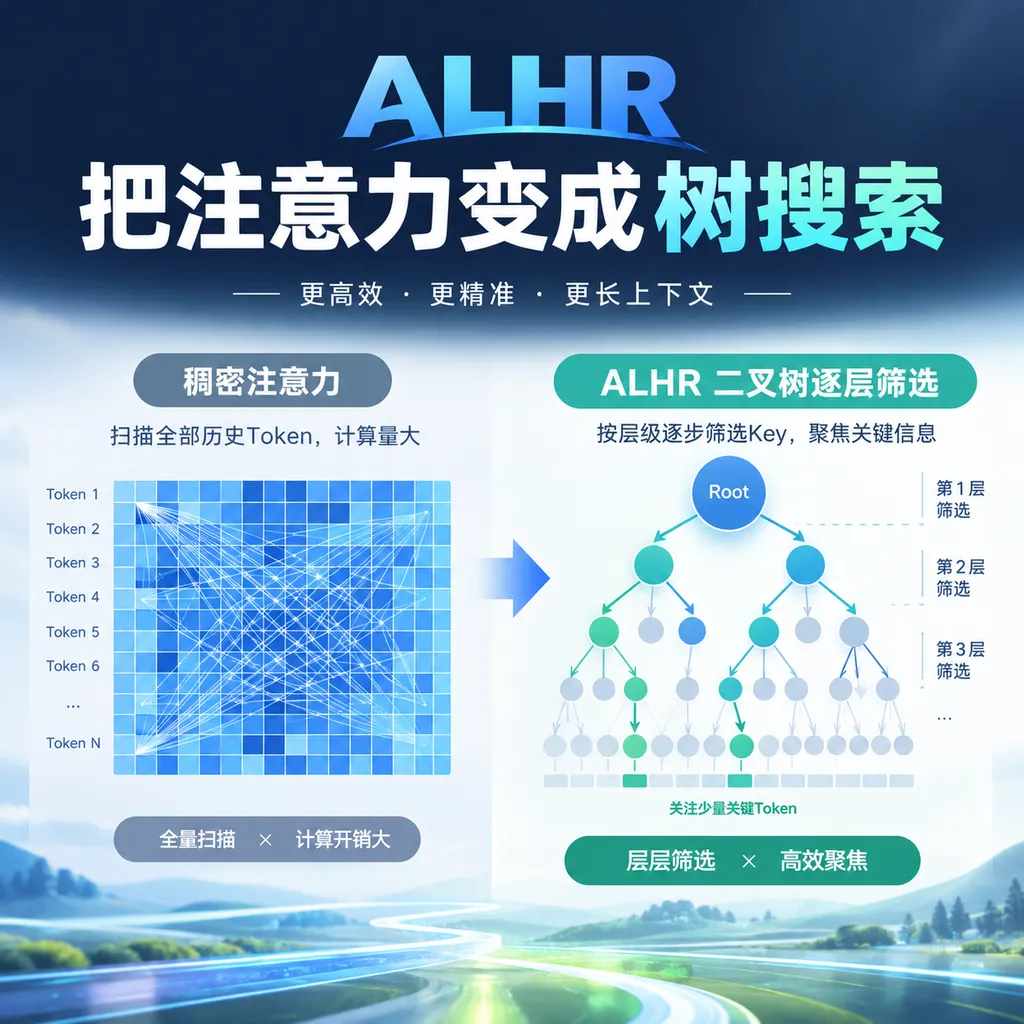
ALHR用可学习的二叉树路由减少KV读取,在1024 token测试中平均只读30个Key,但准确率、显存和评测规模仍暴露出明显局限。
近日,开发者 vdev-ctrl 公布了实验性稀疏注意力系统 ALHR,试图把大模型推理中的注意力复杂度从二次级降到次二次级。其公开结果显示,在长度为 1024 token 的 MQAR 测试中,ALHR 每个 query 平均只读取 30 个 key,Top-1 准确率为 92.1%;稠密注意力平均读取 512 个 key,准确率为 94.9%。
截至 2026 年 10 月 9 日,ALHR 仍然更像一个值得研究的架构原型,而不是可以直接替换 FlashAttention 的成熟方案。它证明了树状路由可能把注意力搜索变成 O(log N) 级过程,但尚未证明这种优势能在完整大模型、长上下文和 GPU 实际墙钟时间上成立。
ALHR是什么:让每个Query沿树寻找Key
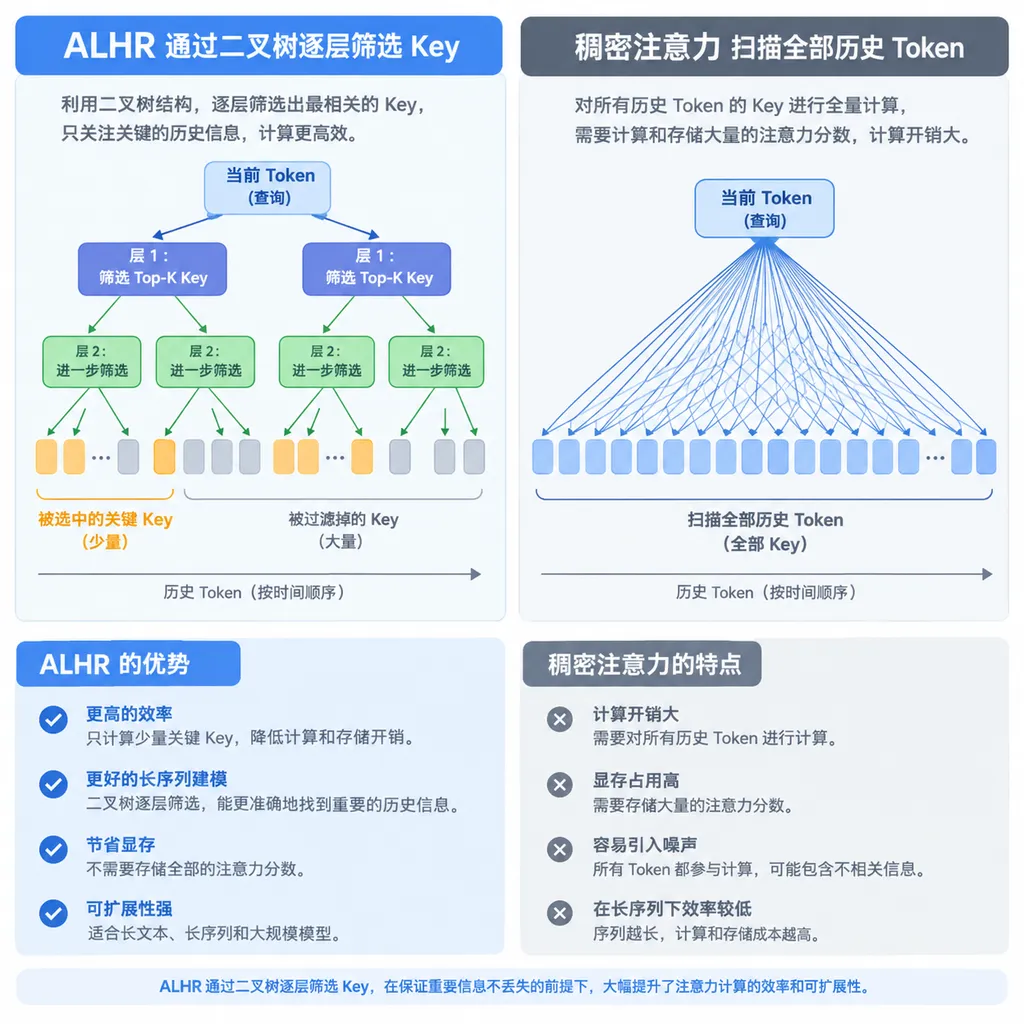
**ALHR 是 Adaptive Learnable Hierarchical Routing 的缩写,即自适应可学习分层路由。**它使用固定拓扑的二叉树组织 key,再通过可学习的路由函数,让每个 query 逐层缩小搜索范围,避免与全部历史 key 计算注意力分数。
标准自注意力的主要问题是全量比较。对于长度为 N 的序列,每个 query 都要与最多 N 个 key 做匹配,完整序列会形成 N×N 的注意力关系,总计算复杂度为 O(N²)。在自回归解码中,单个新 token 的注意力成本是 O(N),连续生成 N 个 token 后,累计成本依然接近 O(N²)。
ALHR 的核心变化是把全量扫描改成树搜索。固定二叉树提供层级索引,可学习函数在每个节点判断 query 应该继续访问哪些分支;如果树保持平衡、每层只展开常数个分支,并且最终叶子桶大小不随序列增长,那么单个 query 的理论检索成本可以接近 O(log N),完整序列则接近 O(N log N)。
这里的“静态树”并不意味着注意力模式也是静态的。固定的是树的拓扑结构,而每个 query 走哪条路径由学习到的路由函数决定,因此不同内容仍可以命中不同 key。它更像图书馆的固定分类架,而不是提前写死的一张注意力掩码:书架没有变化,但检索员会根据问题选择不同楼层、类别和书目。
这种设计真正想省下的是 KV 读取。现代长上下文推理经常受显存带宽限制,而不是纯算力限制;如果一次解码只需从显存读取几十个 key/value,而不是扫描几十万甚至上百万个历史 token,理论上可以同时减少点积计算和内存传输。
1024 Token测试:读取量很漂亮,准确率有代价
**ALHR 当前最关键的公开数据来自 1024 token 的 MQAR 测试。**MQAR 是 Multi-Query Associative Recall,即多查询关联回忆任务,主要考察模型能否从上下文中找回与查询对应的信息,常被用于测试注意力机制的检索能力。
| 指标 | 稠密注意力 | ALHR | 结果解读 | |---|---:|---:|---| | 序列长度 | 1024 token | 1024 token | 目前仍属于较短实验规模 | | 每个 query 平均读取 key 数 | 512 | 30 | ALHR 减少约 94.1% 的因果注意力读取 | | Top-1 准确率 | 94.9% | 92.1% | 下降 2.8 个百分点 | | 报告的 KV 读取压缩 | 1× | 35.3× | 与平均读取数的统计口径存在疑问 | | 报告的 KV 读取比例 | 100% | 2.83% | 似乎使用 1024 而非平均 512 作为分母 | | 峰值显存 | 57 MB | 422 MB | ALHR 原型反而高出约 7.4 倍 | | 训练复杂度 | 二次级 | 仍为二次级 | 第一阶段需要稠密教师模型 | | 推理复杂度 | O(N²) | 声称为 O(N log N) | 尚待完整模型与长序列验证 |
30 个 key 的读取预算确实激进。按照稠密因果注意力平均读取 512 个 key 计算,ALHR 的读取量是稠密方案的 30÷512≈5.86%,也就是减少约 94.1%,对应约 17.1 倍压缩。
项目给出的 35.3 倍和 2.83% 则不能直接与 512 个平均 key 对齐。2.83% 更接近以完整的 1024 token 为分母,而稠密基线的 512 是因果掩码下各位置的平均值;一个用完整长度、一个用平均可见长度,会把压缩比放大约一倍。在作者进一步解释统计方法前,更稳妥的可比数字是约 17.1 倍,而不是 35.3 倍。
准确率下降也不能只看 2.8 个百分点。稠密模型错误率为 5.1%,ALHR 错误率为 7.9%,换算后错误率增加约 54.9%。对于允许少量近似的长文本摘要,这个交换可能可以接受;对于代码补全、精确引用、键值检索和多跳推理,它可能意味着明显更多的漏召回。
MQAR 同样不能代表完整语言模型质量。它适合验证“能否找到正确 token”,但无法覆盖自然语言中的局部语法、全局主题、多轮指代、代码依赖和开放式生成,更不能替代 LongBench、RULER、Needle-in-a-Haystack、困惑度以及真实 Agent 任务。
最反直觉的数据:显存从57MB涨到422MB
**ALHR 当前最大的工程问题不是准确率,而是峰值显存比稠密基线更高。**公开数据中,稠密注意力峰值显存为 57 MB,ALHR 为 422 MB,后者多占 365 MB,约为前者的 7.4 倍。
这个结果说明“少读 KV”不等于“少占显存”。树节点、路由中间状态、候选索引、训练辅助张量以及未优化的实现都可能带来额外开销;如果为了选择 30 个 key,先生成和保存大量树路由状态,理论复杂度优势就可能被常数项吃掉。
项目描述还称稠密方案显存随序列长度二次增长、ALHR 随长度线性增长,但这需要结合具体实现理解。朴素注意力若显式保存 N×N 分数矩阵,峰值显存确实是 O(N²);使用 FlashAttention 一类分块算法后,推理并不需要完整保留注意力矩阵,KV Cache 本身通常仍是 O(N)。因此,ALHR 与未优化稠密实现的峰值显存比较,不能直接推导出它会优于现代推理内核。
所谓 Cache compression 100% 也存在定义歧义。它可能表示历史 KV 被完整保留而未压缩,也可能指某种缓存覆盖率,但仅凭当前字段无法判断;至少从 422 MB 的峰值数据看,不能把它解释成“KV Cache 已被完全消除”。
次二次复杂度成立,需要满足三个前提
**ALHR 的 O(N log N) 结论依赖树平衡、分支数受控和叶子预算稳定三个前提。**二叉树本身并不会自动带来对数复杂度,如果路由器为了保证召回率在每层展开大量分支,最坏情况下仍可能遍历大部分节点。
第一个前提是树必须保持近似平衡。树深度只有在平衡状态下才接近 log₂N;如果 key 的组织导致路径严重偏斜,搜索深度可能退化。
第二个前提是每层展开的候选数必须接近常数。如果一个 query 同时保留多个分支,实际成本更接近 O(k log N+C),其中 k 是每层扩展宽度,C 是最终执行精确注意力的候选 key 数。
第三个前提是路由成本不能依赖全量 key。可学习路由器如果仍需先对所有节点或所有块打分,就只是把昂贵的注意力换成另一个全局索引过程。真正有效的树路由必须只读取当前路径上的节点摘要,而不是先看完整棵树再决定路径。
GPU 利用率也是理论公式没有覆盖的问题。稠密注意力虽然计算多,却能使用高度优化的矩阵乘法;树搜索带来分支、动态索引和不连续内存访问,不同 query 还可能走向完全不同的节点。在 1024 token 这类短序列上,额外的 kernel launch、索引和数据搬运成本甚至可能超过省下来的点积。
因此,复杂度下降不等于端到端延迟按同比例下降。评价稀疏注意力至少要区分四个数字:理论复杂度、实际 KV 读取量、注意力内核耗时和整模型每 token 延迟。ALHR 目前主要证明了前两项中的一部分,后两项仍缺少公开结果。
它和块稀疏、线性注意力有什么区别
**ALHR 属于可学习稀疏注意力,而不是线性注意力或简单滑动窗口。**它仍希望在选中的 key 上执行较精确的注意力,只是把“看哪些 key”变成一项可学习的树状检索任务。
| 路线 | 选择方式 | 理论成本 | 主要优点 | 主要风险 | |---|---|---|---|---| | 稠密 Softmax 注意力 | 查看全部历史 token | O(N²) | 精度稳定、GPU 内核成熟 | 长上下文计算和带宽成本高 | | ALHR | 沿可学习二叉树寻找少量 key | 声称 O(N log N) | 不需要全量扫描 key,粒度可到 token | 路由误差、随机访存、训练仍为二次级 | | 块稀疏注意力 | 先选择 Top-K 块,再读取块内 token | 接近线性或次二次 | 块状读取更适合 GPU | 块摘要可能漏掉少量关键 token | | 滑动窗口注意力 | 只看最近固定窗口 | O(NW) | 实现简单、局部建模稳定 | 远距离信息容易丢失 | | 线性注意力 | 用可递推状态近似注意力 | 常见为 O(N) | 长序列吞吐高、状态紧凑 | 精确复制和检索能力通常较弱 |
ALHR 相比块稀疏方案更强调层级检索。MoBA、Quest 和部分可训练稀疏注意力通常先给块或页面打分,再读取 Top-K 块;这更容易形成连续内存访问,但一个关键 token 可能因为所在块的平均得分不高而被漏掉。ALHR 若能把单个 key 精确路由到叶节点,理论上可以使用更细的选择粒度。
ALHR 相比线性注意力则保留了显式检索的思路。线性注意力通常把历史压缩进固定或递推状态,优势是计算接近 O(N),代价是大量历史信息被混合;ALHR 没有把全部历史揉成一个状态,而是尝试快速找到原始 key,因此更适合关联回忆,但它仍要保存树结构及底层 KV。
稠密教师让训练成本没有同步下降
**ALHR 目前只承诺降低推理复杂度,没有解决训练的二次复杂度。**项目说明第一阶段训练需要稠密教师模型,整体训练过程仍然是二次级,这意味着它更接近“用昂贵教师教会轻量路由器去哪找”,而不是从头到尾都稀疏的 Transformer。
稠密教师的作用很容易理解。路由器需要知道哪些 key 真正重要,而标准注意力的完整分数可以提供监督信号;没有教师时,错误路由会让关键 token 在进入精确注意力前就被删除,后续层无法弥补这种信息损失。
这种训练方式也限制了 ALHR 的即插即用能力。现阶段不能假设把一棵树挂到任意现有模型上,就能在不训练的情况下获得 30-key 的读取预算;至少需要训练或微调路由函数,并验证它能否跨领域、跨长度和跨注意力层泛化。
接下来最该验证的不是更高压缩比
**ALHR 下一步最需要的是完整模型和真实硬件数据,而不是继续刷新单项 KV 压缩数字。**当前仓库提供了运行日志和 Kaggle 实验单元,复现透明度值得肯定,但 1024 token 的 MQAR 仍不足以支撑“大模型长上下文推理方案”的结论。
一套有说服力的后续评测至少应包含以下内容:
- **长度外推必须覆盖 8K、32K、128K 乃至 1M token。**树方法的价值只会在长上下文中体现,1024 token 很难覆盖索引开销与带宽收益的交叉点。
- **质量评测必须加入自然语言和代码任务。**除 MQAR 外,还需要报告困惑度、LongBench、RULER、代码仓库问答、精确引用和多轮 Agent 轨迹。
- **性能基线必须使用优化后的稠密注意力。**合理对手应包括 FlashAttention、分页 KV Cache、GQA,以及 Quest、MoBA 等稀疏方法,而不是只比较会显式保存完整注意力矩阵的朴素实现。
- **墙钟数据必须报告预填充与解码。**至少应给出首 token 延迟、每输出 token 延迟、吞吐量、显存带宽、峰值显存和不同 batch size 下的变化。
- **路由开销必须单独拆账。**树遍历、候选整理、KV gather 和最终 Softmax 各自花费多少时间,决定了 O(N log N) 能否变成真实加速。
- **准确率必须按层和任务分析。**固定 30 个 key 是否对所有层都合适,以及路由错误集中在哪些层,比单一平均准确率更重要。
判断:方向对,但离“大模型可用”还有两道关
**ALHR 最有价值的地方,是把注意力检索从平面 Top-K 选择改成了层级路由。**只要树节点摘要足够便宜、路由召回率足够高,这种方法确实有机会绕开对全部 KV 块打分的成本,并把单 query 检索压到对数级。
第一道关是精度。平均只读 30 个 key 却保留 92.1% Top-1 准确率,说明模型能学到相当强的选择能力;但相对错误率增加约 54.9%,也说明极端稀疏并非免费午餐。真实模型可能需要根据层、query 和任务动态调整预算,而不是统一固定为 30。
第二道关是系统实现。422 MB 对 57 MB 的峰值显存、尚未公布的端到端延迟,以及 GPU 不擅长树状随机访问的问题,都可能让漂亮的渐近复杂度无法落地。只有配套专用 kernel、连续化节点布局和批量路由,ALHR 才可能从算法原型变成推理基础设施。
截至目前,最准确的结论不是“ALHR 已解决二次注意力”,而是“ALHR 给出了一个可复现的树状稀疏注意力实验,并在小规模关联回忆任务上证明了极低 KV 读取预算的可行性”。对于关注长上下文推理的开发者,这个项目值得跟踪;对于生产部署,现在还远不到替换现有注意力栈的时候。
参考来源
- ALHR GitHub 仓库:项目实现、实验日志与 Kaggle 运行记录,是本文技术参数的主要来源。
- Reddit:ALHR 项目发布与讨论:作者公布 MQAR 准确率、KV 读取量、显存数据和当前限制。
- 知乎:稀疏注意力与 MoE 原理综述:用于补充稀疏注意力的基本背景和应用场景。