Claude动态工作流单次调度千个智能体
Anthropic 于 10 月 9 日为 Claude Managed Agents 引入动态工作流,单次执行最多可协调 1000 个智能体。官方漏洞检测测试中,动态工作流检出 66 个漏洞,单智能体则检出 14 至 27 个。
Anthropic 为 Claude Managed Agents 加入动态工作流
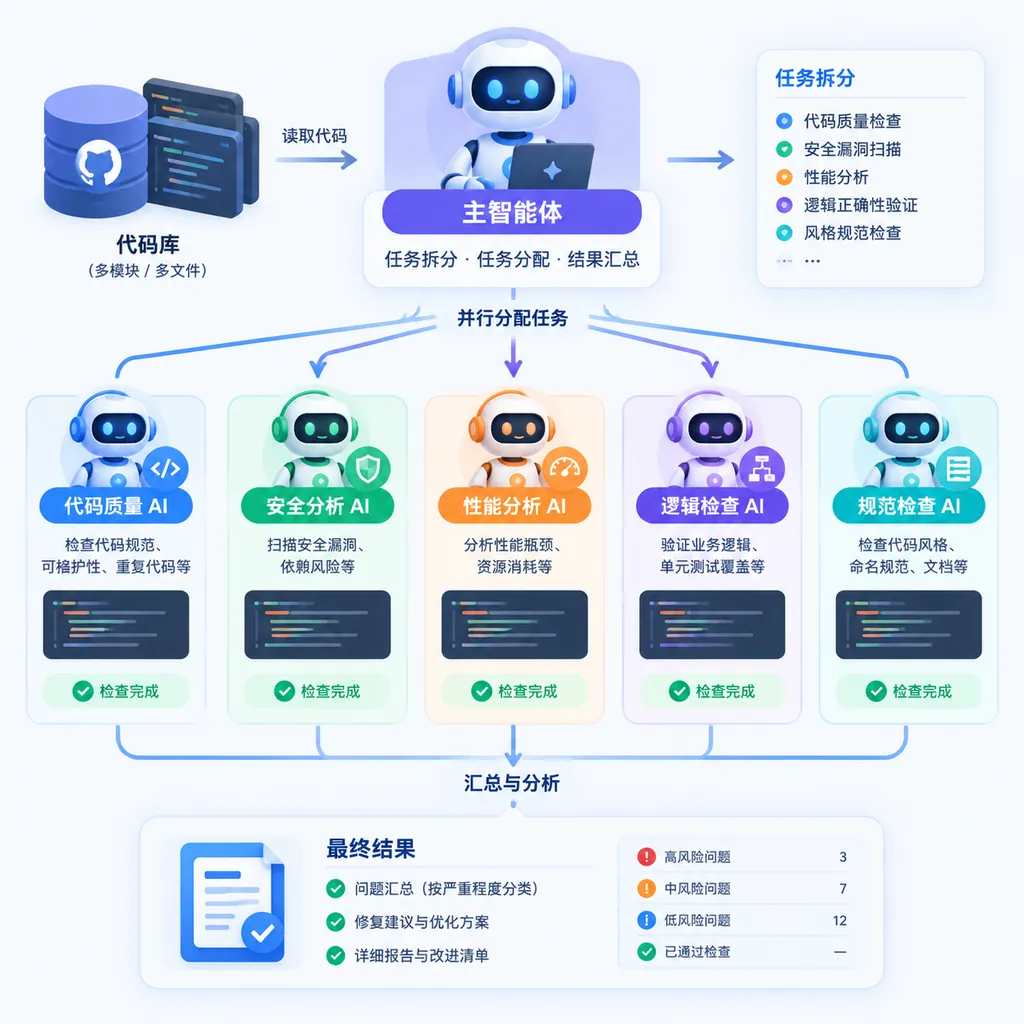
Anthropic 于 10 月 9 日宣布,Claude Managed Agents 新增动态工作流能力,单次执行最多可协调 1000 个 AI 智能体。新功能面向代码审查等大型任务:由主智能体规划工作,把任务拆成子任务并分派给多个智能体处理,再汇总各自结果。
这项更新的看点不只是“数量达到 1000”。它试图把 Claude 从一个接收任务、逐步作答的助手,变成能够规划并组织一组执行者的任务协调系统。对于工作内容能切分、结果能验证的任务,这种变化可能直接影响完成时间和覆盖率;但智能体数量上限并不等于一次任务必然使用 1000 个智能体,也不意味着结果会随数量线性变好。
动态工作流是什么
动态工作流是一种由主智能体根据任务规划、拆分和分派工作,并在子智能体完成后汇总结果的执行方式。它与简单地让模型“多想几步”不同:重点在于把一项大任务拆成多个可独立处理的部分,让多个执行单元并行推进。
以检查大型代码库为例,主智能体可以把仓库划分成多个区域,安排不同智能体分别检查潜在漏洞,再将发现集中起来。原本一个智能体需要依次读过大量文件;采用并行流程后,不同部分可以同时检查。能否获得收益,取决于任务是否适合拆分、拆分边界是否合理,以及最后有没有可靠的结果核验。
Anthropic 此次介绍的功能属于 Claude Managed Agents。根据目前提供的信息,动态工作流的核心流程是“规划—分派—执行—汇总”,而不是用户手工预先写好固定的任务清单。它强调的是主智能体按任务组织协作,让执行过程可以围绕具体工作展开。
官方测试:单智能体检出 14 至 27 个,动态工作流检出 66 个
Anthropic 用一个模拟漏洞检测任务展示了动态工作流的效果:研究人员在一个包含 11.6 万行代码的代码库中隐藏了 70 个 Bug,并比较单智能体与动态工作流的检出数量。
| 测试方式 | 代码库规模 | 隐藏漏洞数 | 检出数量 | | --- | ---: | ---: | ---: | | 单智能体 | 11.6 万行 | 70 个 | 每次运行检出 14 至 27 个 | | 动态工作流 | 11.6 万行 | 70 个 | 稳定检出 66 个 |
在这组测试中,动态工作流每次都检出 66 个漏洞,约占全部隐藏漏洞的 94%;单智能体每次检出 14 至 27 个,约占 20% 至 39%。这组结果说明,并行拆分可能提升特定任务的覆盖率,尤其是需要检查大量代码、且不同区域可以分别处理的场景。
但它不是对所有编程任务的通用性能结论。官方给出的比较聚焦一个特定的模拟漏洞检测任务,不能直接推导出动态工作流在所有代码库、所有缺陷类型或所有真实开发流程中都能达到相同水平。测试展示的是一个值得关注的方向,不是“智能体越多,代码质量就越高”的证明。
1000 个上限意味着什么
单次最多协调 1000 个智能体,意味着任务拆分的规模上限可以很大,但不能简单理解为 1000 个智能体始终同时运行。参考资料给出的明确表述是“单次执行最多可并行协调 1000 个智能体”;它没有提供此功能的并发数、调度方式、运行时长、具体费用或各类任务的性能数据。因此,不能把智能体总数与同一时刻的并发执行数混为一谈。
真正有价值的变化,是工作流可以面向大规模任务设计。比如代码库安全检查、跨模块梳理、批量审阅或大量相似内容的归类,往往包含许多可拆分的工作单元。若协调系统能合理分配任务并整理结果,开发者就不必把所有上下文和检查步骤压在一个智能体的一次执行里。
然而,拆分并非免费的午餐。子任务越多,系统需要处理的调度、结果去重、冲突判断和汇总工作也越多。如果几个智能体重复检查同一批文件,或者各自使用不同标准,规模扩张反而会增加噪声。最终效果不只取决于“派出去多少个”,也取决于任务定义是否清晰、各部分是否足够独立,以及结果如何复核。
它与传统单智能体工作方式的区别
单智能体适合边做边调整的任务:模型在同一条执行路径上理解上下文、调用工具、根据反馈继续处理。它的优点是过程相对直接,任务状态集中;当问题范围有限,或者各步骤高度依赖前一步的结果时,强行拆分未必划算。
动态工作流更适合可以分块并行的任务。它先组织多个执行单元分别处理子问题,再收集结果。这种方式有机会缩短整体处理时间、提高覆盖面,但也需要一个更强的协调环节来避免遗漏、重复和互相矛盾的结论。两者不是简单的替代关系,更像是不同任务结构对应的两种执行方式:依赖链长、需要连续判断的任务,单智能体可能更自然;大量重复检查、相对独立的任务,动态工作流的优势更容易体现。
从开发者的角度看,这也改变了评估 AI 工具的方式。过去,人们常比较单次回答是否准确;对多智能体工作流来说,还需要问:任务是如何拆开的?哪些子任务可以并行?结果是否可以复现?汇总阶段怎样处理冲突?这些问题决定了系统能不能在真实仓库中稳定工作,而不只是演示时表现亮眼。
这项更新值得关注,但边界仍要看清
Claude Managed Agents 的动态工作流最明确的产品信号,是 Anthropic 开始把“大规模任务组织能力”作为智能体产品的重要部分。模型本身能否写出好代码、理解复杂上下文仍然重要;但当任务从单轮问答扩展到跨文件、跨模块的大型工作时,执行架构同样会影响结果。能够拆分任务并行处理,是让模型从回答问题走向承担完整工作的一步。
这对代码安全检查尤其有吸引力,因为漏洞排查本身就常常需要覆盖大量文件和路径。不过,漏洞检出数量不能代替真实项目中的误报率、漏报率和修复质量。Anthropic 公布的测试给出了隐藏漏洞的数量和检出结果,但参考资料没有提供误报统计,也没有说明这些漏洞的类型分布。因此,66 个检出结果能证明这次测试中覆盖率较高,却还不足以说明输出可以不经人工审查直接进入安全流程。
对团队来说,更稳妥的预期是把它视作扩大检查覆盖面的工具,而不是自动替代资深工程师的审计系统。可以让工作流帮助扫出疑点、归纳证据,再由工程师判断问题是否真实、影响范围有多大、修复方案是否安全。尤其是涉及身份认证、权限控制或敏感数据的漏洞,结论仍需要结合代码路径和运行环境复核。
成本和资源消耗也需要留意。让更多智能体参与任务,通常意味着更多模型执行和结果整理环节;但本次可用资料没有给出该功能的定价、实际调用量或与单智能体的成本对比。开发者目前不应只依据“1000 个”的规模上限判断投入产出,实际采用前还需要关注官方公布的使用限制、费用和运行控制方式。
对开发者意味着什么
这次更新适合关注智能体编排、代码审查和大规模自动化任务的开发者跟进。它展示了 Claude Managed Agents 从单个执行者走向多智能体协作的产品方向,也通过漏洞检测案例提供了一个具体的并行任务样本。相比单纯宣传“智能体更多”,检出数量对比至少让外界看到这套方式试图解决什么问题:在大规模代码库中提高检查覆盖率。
与此同时,产品价值还要看真实使用中的任务拆解质量、结果可信度和运行成本。1000 个是单次执行的协调上限,不是效果承诺;66 个是特定测试的检出结果,不是所有代码库都能复现的基准。现阶段最合理的判断是:动态工作流为大型、可拆分任务提供了新的执行模式,潜力值得关注,但实际效果仍需结合更多任务类型和真实项目验证。
简而言之,Anthropic 正在把智能体协作从“多个模型分别回答”推进到“由工作流组织分工并汇总结果”。 这一步可能让 Claude 更适合处理体量大、可并行的工程任务;它能否成为开发团队的可靠工具,最终还要由可复现性、误报控制和成本表现来决定。
参考来源
- IT之家:Claude 管理智能体新增动态工作流,单次最多并行调度 1000 个 AI Agents —— 报道 Anthropic 于 10 月 9 日发布的功能更新,并介绍漏洞检测测试数据。
- 知乎:Claude Workflow 完整技术指南:多智能体编排深度解析 —— 补充介绍动态工作流的编排机制与多智能体执行背景;本文未将其中未由主参考资料确认的参数作为确定事实。