Cloudflare 推出 Clef-omni,四模态一次处理
Cloudflare 于 10 月 9 日发布开放权重决策模型 Clef-omni,支持单次调用处理文本、图像、音频和完整视频。它不生成自由文本,而是为结构化问题的候选选项打分,主打将多模态理解直接接入决策与工具路由流程。
Cloudflare 把多模态输入接进了结构化决策
Cloudflare 于 10 月 9 日发布开放权重模型 Clef-omni,支持在单次调用中处理文本、图像、音频和视频,并为结构化问题给出选项概率。对开发者来说,这次更新的重点不是又多了一个能看图、听音频的聊天模型,而是 Cloudflare 把多模态理解放进了 Clef 系列原本擅长的决策任务:输入一段状态信息和预先定义的问题,模型直接对候选答案打分,而不是先生成一段自然语言,再依赖另一套程序解析。
Clef-omni 是面向结构化决策任务的多模态模型。它接收文本、JSON、图像、音频或视频等状态信息,以及带类型约束的问题,随后在一次前向计算中为每个问题的允许选项输出概率。模型权重已在 Hugging Face 开放,底层基于 Qwen3-Omni-30B-A3B-Instruct 构建。
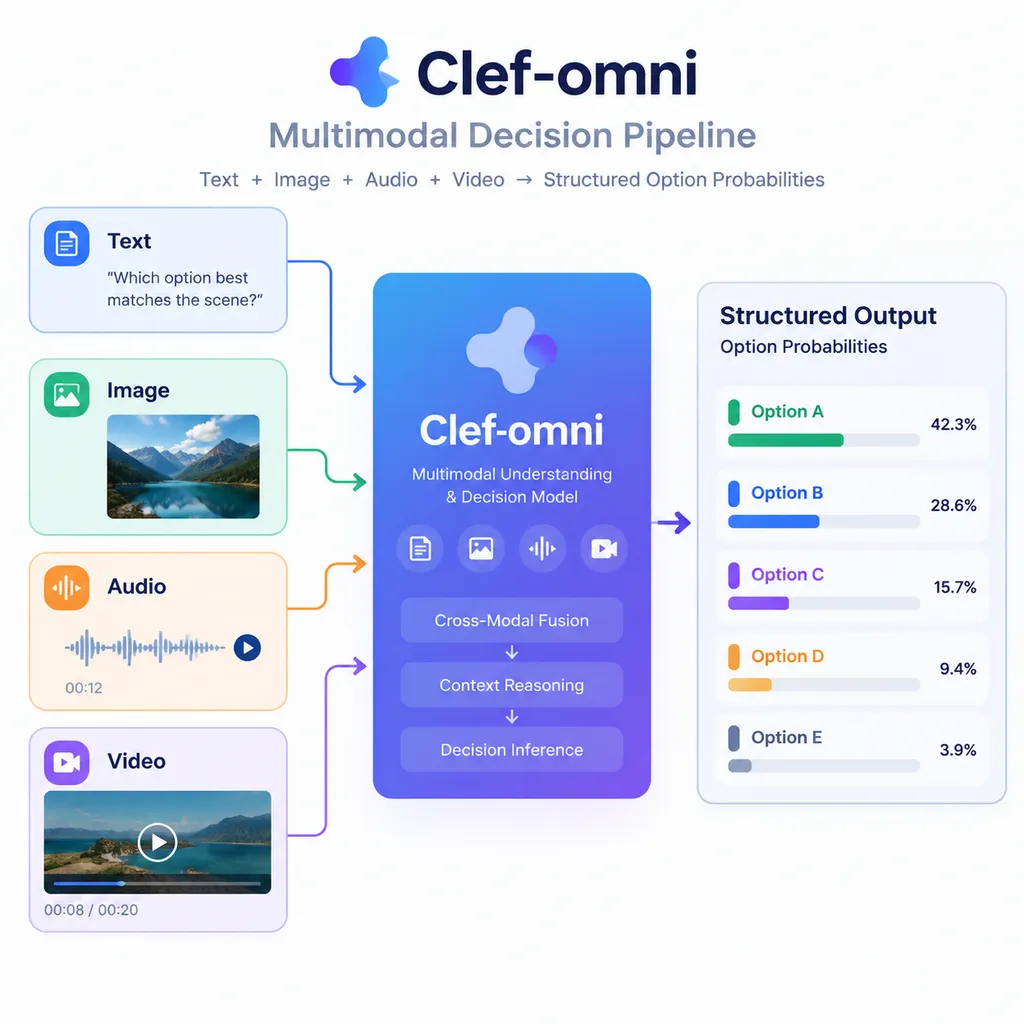
这套产品思路与通用多模态助手不同。助手通常以生成文本为中心,用户问“这段视频里发生了什么”,模型回答一段描述;Clef-omni 则更适合回答“画面里是否出现安全帽”“来电属于哪个意图类别”“这段录音是否符合某个告警条件”等有明确选项的问题。前者服务开放式交互,后者瞄准分类、路由、审核和工具调用前的判断环节。
从抽帧输入,走到音视频一起理解
Clef-omni 相比此前 Clef 系列的关键变化,是不再只靠文本、图片和从视频中抽出的静态画面处理多模态任务。此前,开发者可以把视频按时间抽成一组图像,再按顺序交给模型;这能保留部分视觉变化,却无法自然覆盖声音,也需要应用侧完成抽帧、整理和拼接。Clef-omni 新增音频与完整视频输入,支持 WAV、MP3、MP4 和 WebM 格式。
对工程团队而言,减少预处理链路比“四模态”这个标签更有实际意义。传统方案往往要先把音频送去转写,再把视频切帧,最后把字幕、图像和上下文拼成一个提示词;每一步都可能引入延迟、额外成本或信息损失。若模型能直接接收视频及其声音,开发者就有机会把原本由多个模型和服务组成的流水线收敛到一次模型调用中。
不过,“单次调用”不等于任何场景都能无条件省掉全部工程工作。任务仍需要定义清晰的问题和选项,输入也要符合模型处理能力;实时流、超长视频、低延迟要求以及复杂的业务规则,仍可能需要切片、采样、队列和结果校验。模型减少的是多模态预处理和模型串接,不是把整个产品系统压缩成一个按钮。
Hugging Face 模型说明显示,视频文件按每秒 2 帧采样;视频带有音轨时,音频可与画面一并处理。这个细节决定了它适合捕捉场景变化和关键事件,但不能简单等同于逐帧视频理解。快速动作、短暂闪现的目标或依赖高帧率的细节,可能会被采样策略遗漏,生产部署仍需结合任务做评测。
不生成自由文本,换来更稳定的输出边界
Clef-omni 不以常规自由文本生成为目标,而是对每个结构化问题的允许选项输出概率。Hugging Face 上的模型说明将其概括为:输入状态与类型化问题,模型在单次前向计算中为每个选项作出判断;它不需要生成一段解释性回答,也无需再从自然语言里解析结果。
这一设计在生产系统里有现实价值。比如客服路由系统要判断用户是在查询账单、申请退款还是报告故障,生成式模型可能返回一段解释,应用再用规则或第二个模型抽取类别;Clef 这类决策模型直接对候选类别打分,能减少输出格式漂移和解析失败。对于工具调用场景,它也可以承担“该不该调用某个工具、应该走哪条流程”的前置判断。
代价是灵活性有限。用户提出的问题如果没有被提前编码进问题与选项,模型不会像聊天助手那样自由发挥;它也不适合直接承担长篇总结、开放式问答或需要逐步解释的工作。因此,Clef-omni 更像多模态系统里的判别器或路由器,而不是通用助手的替代品。把它放到对的位置,结构化输出是优势;把它当作聊天模型使用,则会觉得能力受限。
基准成绩并非全面领先
Cloudflare 公布的基准结果显示,Clef-omni 在多项任务上接近此前 Clef,也有一些明显退步。按提供的数据,BFCL 精确匹配率为 98.2%,略低于 Clef 的 98.4% 和 Clef-flash 的 98.76%;API-Bank 准确率为 92.7%,高于 Clef 的 91.93%,但略低于 Clef-flash 的 93.11%。在家用电器任务上,Clef-omni 为 69.3%,低于 Clef 的 82.95%,更低于 Clef-flash 的 97.73%;When2Call 准确率为 63.3%,也低于表中 Jev 的 80.97%。
| 基准 | Clef-omni | Clef | Clef-flash | Jev | 指标 | |---|---:|---:|---:|---:|---| | BFCL | 98.2 | 98.4 | 98.76 | 95.75 | 精确匹配率 | | ToolRet | 66.6 | 69.1 | 66.43 | 65.28 | nDCG@10 | | API-Bank | 92.7 | 91.93 | 93.11 | 88.19 | 准确率 | | 家用电器 | 69.3 | 82.95 | 97.73 | 52.27 | 精确匹配率 | | When2Call | 63.3 | 72.37 | 65.58 | 80.97 | 准确率 | | BANKING77 | 94.8 | 94.20 | 90.93 | 79.74 | 宏平均 F1 | | CLINC150+OOS | 97.7 | 97.43 | 66.77 | 89.27 | 宏平均 F1 | | BRIGHT | 42.0 | 45.91 | 39.26 | 47.52 | nDCG@10 | | Amazon ESCI | 57.8 | 57.48 | 57.39 | 55.21 | 宏平均 F1 | | PhishNChips | 73.2 | 79.60 | 75.05 | 62.55 | 准确率 |
从这些结果看,Clef-omni 并不是在所有纯文本决策基准上都比旧版更强。它在 BANKING77、CLINC150+OOS 等意图分类任务上表现较好,但家用电器、When2Call、BRIGHT 和钓鱼识别等任务仍有差距。多模态能力的加入也不意味着文本能力自动全面升级;更合理的看法是,Cloudflare 在扩展输入范围的同时,保留了相当一部分已有决策性能,但不同任务仍需逐项验证。
不同基准的任务定义、数据集和评测方式并不相同,表格里的数字不能直接当成产品总体排名。真正要上线,团队仍应拿自有数据比较 Clef-omni、Clef、Clef-flash 及现有分类器,并重点检查误判成本、长尾类别和置信度阈值。涉及安全、支付或账号权限的决策,也不应只凭模型分数直接执行高风险操作。
延迟数据说明了它瞄准的工作流
Cloudflare 公布的测试中,纯文本请求中位响应时间约 130 毫秒,图像请求约 150 毫秒;一段带声音的 21 秒视频约 1.5 秒完成评分。数字表明,图像和文本决策可以进入对响应速度有要求的应用链路,而视频评估则更适合异步审核、内容检索和事件检测等场景,不应直接理解为 21 秒视频的实时直播分析能力。
这里还要区分“处理耗时”和“端到端体验”。实际延迟会受到视频长度、采样帧数、音频处理、网络传输和部署配置影响;Cloudflare 给出的数字是特定测试条件下的结果,不是所有输入规模、硬件和并发量下的服务保证。对于开发者,最有用的下一步不是照搬宣传数字,而是拿真实请求构造自己的延迟分布:分别测试文本、图片、短视频和长视频,并记录中位数与高分位延迟。
开放权重与托管服务是两条不同的路线
开放权重意味着开发者可以获取模型权重并尝试自行部署或集成,但不等同于模型使用没有成本,也不自动代表所有数据治理要求都已解决。Hugging Face 页面列出了 Docker Model Runner 等使用路径,并说明 API 与 Jev、SystemOne 兼容;混合文本与多模态记录也可以放在同一批次中。不同推理框架和硬件的支持状态仍需要查看仓库说明,不能把“权重开放”直接理解为开箱即用。
对已有推理基础设施的团队,自部署的价值在于控制模型运行环境、数据路径和版本节奏;代价则是需要承担显存、吞吐、监控和升级维护。托管版本更省运维,但要评估延迟、可用区域、请求限制和数据处理条款。两种方式解决的问题不同,选择时应从数据敏感度、部署能力和流量规模出发,而不是只看模型是否开源。
Clef-flash 降价,产品线开始分层
Cloudflare 同时下调了 Clef-flash 的输入价格:每百万输入 Token 从 0.09 美元降至 0.038 美元,降幅约 58%;托管版上下文窗口则从 64k 缩至 24k。降价让轻量决策任务的调用门槛更低,但上下文窗口缩短是需要一并考虑的变化,尤其会影响依赖长历史或大段状态输入的应用。
| 项目 | 调整前 | 调整后 | 变化 | |---|---:|---:|---| | Clef-flash 输入价格 | 每百万 Token 0.09 美元 | 每百万 Token 0.038 美元 | 降低约 58% | | Clef-flash 托管版上下文窗口 | 64k | 24k | 减少 40k |
这更像是 Cloudflare 在拉开产品线定位:Clef-omni 扩展输入模态,适合需要跨文本、图像和音视频做判断的场景;Clef-flash 则通过降价面向成本敏感的轻量决策请求。对开发者而言,模型选择不应只看“多模态”或单价,还要同时比较上下文长度、任务准确率、延迟和输入类型。需要处理视频的场景,若实际只需文本分类,直接使用更轻量的模型可能更合算。
结论:它补的是决策流水线,不是聊天模型空位
Clef-omni 的产品价值在于把多模态输入与结构化决策结合起来:它能接收音视频,不必先把所有内容转成文本或手工抽帧;它输出候选选项概率,而不是要求业务系统从一段自由文本里猜答案。对于内容审核、客服分流、媒体事件标注、视觉质检和工具路由,这种接口比通用聊天模型更贴近生产系统的接入方式。
但它的边界同样清晰:开放权重不代表部署零成本,支持完整视频也不代表逐帧、实时、无损理解,单次调用也不意味着所有预处理与业务校验都能取消。公开基准里,Clef-omni 在部分分类任务上表现有竞争力,但并未全面超过旧版 Clef 或 Clef-flash。现阶段更稳妥的判断是:Cloudflare 为 Clef 系列补上了音频与视频入口,扩大了可处理任务范围;至于能否替代现有多模型流水线,仍要由真实数据、任务指标和端到端成本决定。
参考来源
- IT之家:Cloudflare 推出开放权重决策 AI 模型 Clef-omni——发布信息、输入格式、延迟数据及基准测试。
- Hugging Face:Cloudflare/clef-omni——模型定位、输入说明、视频采样策略与部署信息。
- 知乎:Jev 的开源替代来了,Cloudflare 开源 Clef——Clef 系列背景与相关产品讨论。