Jebadiah v2.1直接决策
Jebadiah v2.1更新27B与9B模型,改为直接读取候选标签logits,为预设选项评分,跳过文本生成与答案解析。作者报告两款模型在Decision Index 0.3上的成绩提升,但When2Call子项回退,且差异尚无统计显著性结论。
Jebadiah v2.1:让模型直接给选项打分
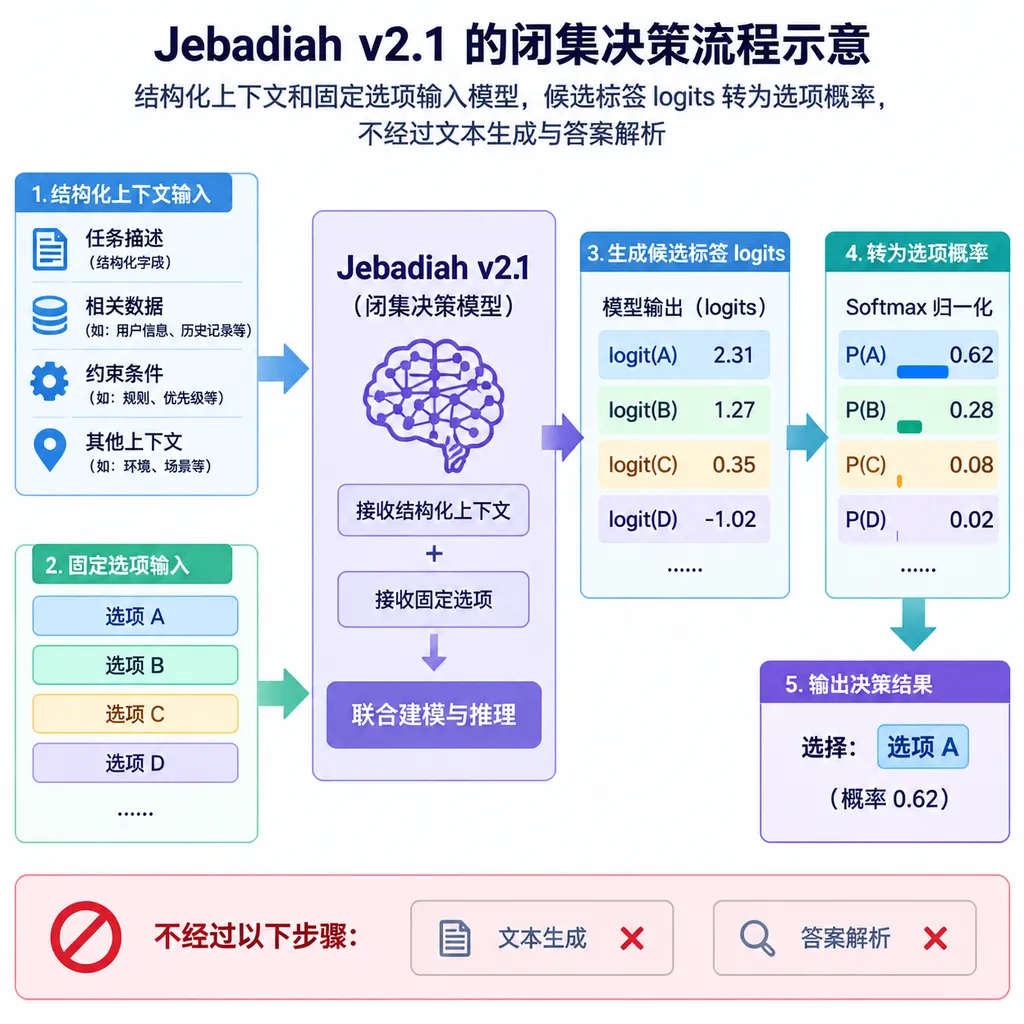
Jebadiah 近日发布 v2.1,更新 27B 与 9B 两个开权重决策模型。与常见的大模型先生成一段文字、再由程序从文字里提取答案不同,Jebadiah v2.1 面向有限选项问题,直接根据候选标签对应的 logits 给每个允许选项评分,并输出各选项的概率。
这次更新的重点不是参数规模增加,也不是 FP16、INT8 一类数值精度变化,而是模型如何作答:当任务的答案空间事先确定,模型不必扮演写作者,可以更像一个直接交卷的分类器。这个方向对结构化决策有实际吸引力,但目前的成绩来自发布者自报评测,不能据此下结论说它已经普遍优于生成式模型。
这次更新到底改了什么
闭集决策是指模型只能在预先给定的一组答案中选择,而不能自由生成任意文本。比如客服系统要把工单分到“退款、物流、账号”三个队列,或审核流程要在“通过、拒绝、转人工”之间做判断,这类任务天然有一个有限的选项集合。
根据发布者的说明,Jebadiah 接收结构化上下文和带类型的问题,并针对每个固定候选标签取分。它不再先采样生成“我认为应该选择退款”这样的自然语言,再依靠正则、JSON 解析或另一个分类器提取“退款”。少了一段生成与解析链路,结果更容易直接交给下游程序消费,也减少了随机采样带来的波动来源。
需要区分的是,“输出概率”不等于“概率已经校准”。当前提供的资料没有说明 v2.1 的概率是否经过校准、候选概率如何归一化,也没有给出可靠性曲线或校准误差。开发者仍应把它视为模型对候选项的打分结果,不能直接把 0.9 理解成“现实中有 90% 的概率正确”。
Decision Index 0.3:两款模型都涨分,回退也很集中
发布者称,以下数字来自其使用未修改的官方评分器进行的自测,并已提交到 Decision Index 0.3 榜单。公开套件成绩可以帮助观察版本变化,但不是独立机构的复现结果;发布者也明确表示,这些差异没有统计显著性结论。
| 模型 | v2.1 分数 | v2 分数 | 总分变化 | Knowledge | Language | Retrieval | Arts | Tools | |---|---:|---:|---:|---:|---:|---:|---:|---:| | Jebadiah 27B | 57.03 | 55.11 | +1.92 | +2.34 | +3.89 | +2.81 | +1.31 | -2.10 | | Jebadiah 9B | 47.20 | 44.09 | +3.11 | +3.67 | +4.34 | +5.96 | +0.01 | -0.84 |
两个版本的整体分数分别提高 1.92 和 3.11 分。分项上,9B 在 Retrieval 上增加 5.96 分,是表格中最明显的正向变化;两款模型在 Knowledge 和 Language 上也都提升。另一面是 Tools 项均有回退,27B 下降 2.10 分,9B 下降 0.84 分。换句话说,更新不是所有能力一起向上,而是某些任务族变好、另一些任务族变差。
更值得注意的是 When2Call 子项:发布者报告 27B 下降 6.38 分,9B 下降 7.44 分,并称尚未找到原因。这个回退幅度不能被总分增长掩盖。对使用者而言,具体子项往往比一个汇总数字更接近生产表现:如果业务恰好依赖类似 When2Call 的判断,v2.1 是否升级应先用自己的样本验证。
发布者还提到,榜单提交流程会在排名前加入私有测试。因此,公开套件的分数与最终排名不是同一件事;目前资料也没有给出私有测试的具体构成或两款模型的最终排名。资料中的污染检查说明在现有摘录里并不完整,不能据此判断训练数据与公开基准之间的重叠风险已经排除。
为什么直接读 logits 有用
Logits 是模型在输出层为不同候选 token 给出的未归一化分数。对闭集分类而言,如果候选标签可以对应到模型的输出标签,系统就能比较各选项的分数,并将其转成面向下游的候选概率,而不必先把答案写成一段自然语言。
传统生成式流程像是先让模型口头回答,再让程序听懂它说了什么。直接候选评分则像把选择题交给模型涂答题卡:答案范围已知,输出结构固定,少了自由文本中可能出现的解释、格式错误、额外前后缀和解析歧义。对只需要路由、分类或有限动作选择的系统,这种简化有工程价值。
但它并不意味着模型不用推理,也不意味着参数越大就必然越准。27B 和 9B 仍需处理输入上下文,推理成本取决于模型架构、精度、上下文长度、硬件和运行框架。资料没有提供这两款模型的延迟、吞吐量、显存需求或量化表现,因此不能把“跳过生成”直接换算成毫秒级响应或固定的成本降幅。
适合哪些场景,不适合哪些场景
**候选集合稳定、输出必须结构化的任务,是这类模型最自然的落点。**例如工单分流、内容审核初筛、检索结果挑选、意图识别、有限动作路由,以及需要在多个已知选项中作判定的内部工具。它们通常不需要长篇解释,核心要求是判断一致、输出可消费、错误可监控。
**候选项会不断变化或答案需要开放生成的任务,则不应强行塞进闭集接口。**用户问答、长文写作、代码生成、探索式研究和未知类别识别,往往需要表达选项之外的信息。若系统只允许从“通过、拒绝、待审”中选择,它就无法直接表达“现有信息不足”或一个尚未定义的新类别,除非设计者把这类选项明确纳入集合。
还有一个容易被忽视的工程问题:候选标签本身会影响判断。标签用词是否清晰、类别是否互斥、选项顺序是否改变结果、一个标签对应单个 token 还是多个 token,都可能影响评分。发布材料没有披露 Jebadiah v2.1 如何处理标签措辞、标签长度和校准问题,因此部署团队应把这些因素纳入本地验证,而不是只测一张公开榜单。
开权重不等于所有开放条件都已明确
发布者把 Jebadiah v2.1 描述为 open weights,即开放模型权重。权重可获取并不自动意味着训练数据、训练代码、完整评测流程和商业使用许可都同样开放。现有参考内容没有附上模型卡、下载地址或许可证文本,因此在实际集成前,仍需从项目发布页核对具体权重、模型许可、依赖框架和使用限制。
参数规模也只能提供部署门槛的粗略判断。通常 9B 比 27B 更容易适配资源有限的机器,但实际能否本地运行、需要多少显存、使用何种量化方案,仍取决于权重格式和推理实现。由于此次资料未提供这些参数,任何精确到显存容量或本地速度的承诺都缺少依据。
现在值得关注,但还不是无条件升级信号
Jebadiah v2.1 的产品思路值得关注:当问题本来就是从固定集合里做判断,让模型生成文字再解析并非唯一方案。直接对候选标签评分,可以把模型接口收窄到机器真正需要的结果,减少应用层处理自然语言输出的工作量。它更像是面向决策任务的专用接口设计,而不是要取代通用聊天模型。
不过,这次评测呈现的是“总分上涨、局部回退”,而不是全面胜出。发布者没有声称这些差异具有统计显著性,When2Call 的明显下降也尚未解释。对于开发者,合理做法不是看到总分提升就立刻切换,而是用自身线上分布、边界样本和类别不平衡数据,对 v2 与 v2.1 做并行对照;重点观察错误类别、拒判能力、概率校准和输入轻微变化时的稳定性。
更具体地说,若业务只关心分类准确率,至少要比较各类召回率和混淆矩阵;若下游会按概率阈值触发动作,还要检查置信度是否可信,并为低置信样本留出人工复核或拒答路径。固定选项带来的结构化便利,不会自动消除分布漂移、标签偏差或错误决策的业务风险。
截至 2026 年 10 月 11 日,Jebadiah v2.1 的核心看点是把 27B 与 9B 模型进一步定位为闭集决策器,并报告了 Decision Index 0.3 上的版本改进。它提供了一个清晰、可验证的方向:在答案集合有限时,直接评分可能比先生成再解析更合适。至于是否更快、更便宜、更可靠,以及能否在真实业务中胜过现有分类器或通用模型,还需要完整模型卡、独立复现和任务侧评测来回答。
参考来源
- Reddit:Jebadiah v2.1 发布者的项目介绍与 Decision Index 0.3 自测结果:包含 27B、9B 的 v2.1 与 v2 分数对比、分项变化及发布者对显著性的说明。