TinyDetect把AI检测器塞进浏览器
开源项目 TinyDetect 将文本和图像 AI 检测模型压缩到约 97 MB 与 26 MB,并借助 ONNX Runtime Web 在浏览器本地运行。它不上传用户内容,但检测准确率、模型偏差和首次加载成本仍是关键限制。
TinyDetect把AI检测器塞进浏览器
TinyDetect 是一个把 AI 文本检测器和 AI 图像检测器部署到浏览器端、无需上传用户内容的开源项目。近日,开发者 Rita Brata Maiti 公布了 TinyDetect 的在线 Demo、代码和压缩脚本,试图解决 AI 检测工具长期依赖云端推理、用户必须上传敏感内容的问题。
项目目前使用两个已有的开源检测模型,并没有从头训练新的检测器:文本侧基于 fakespot-ai/roberta-base-ai-text-detection-v1,图像侧使用 Community Forensics 的 commfor-model-384。经过微调、权重处理、量化和 ONNX Runtime Web 适配后,两个模型可以直接在现代浏览器中运行。
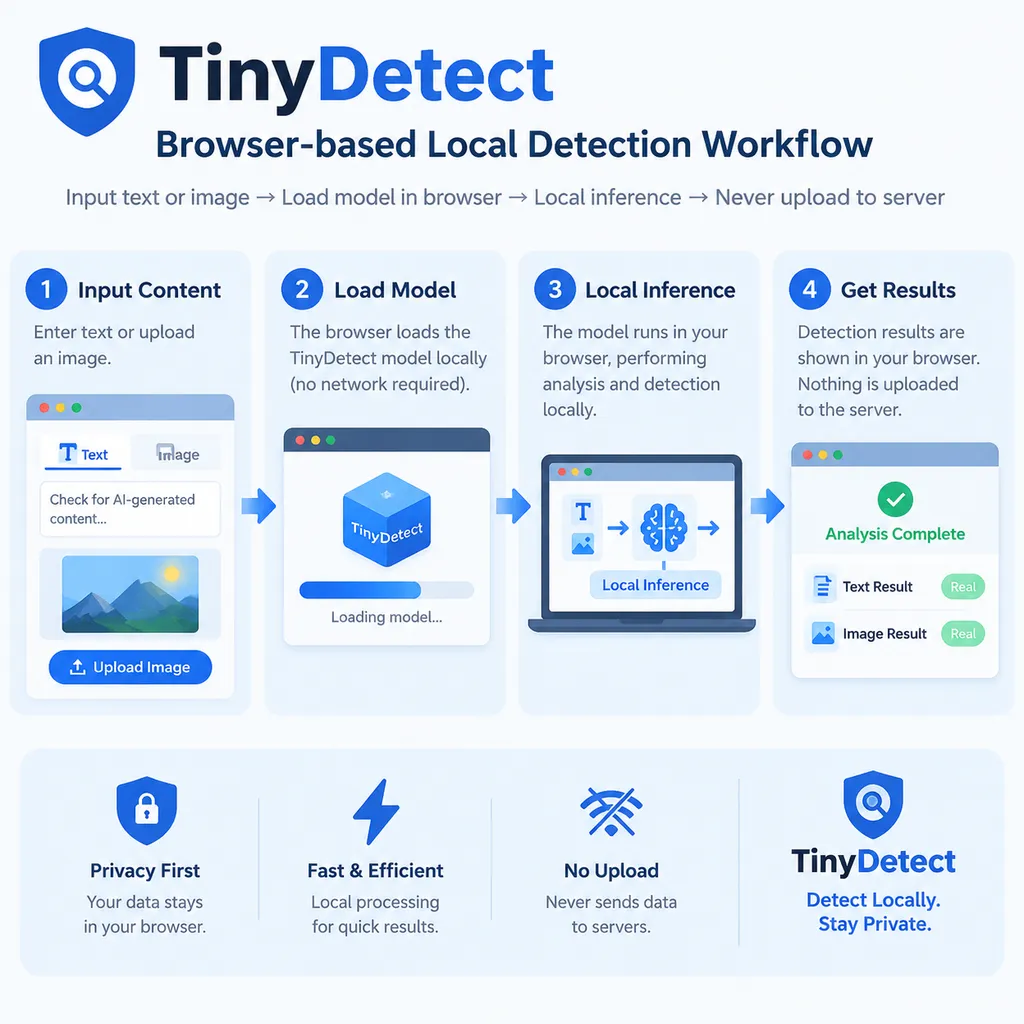
这件事的意义不在于又出现了一个“更准”的 AI 检测器,而在于它把检测任务的部署边界往前推了一步:文本和图片不必先离开设备,浏览器本身就可以充当一个轻量推理客户端。
500 MB 的文本模型,被压到约 97 MB
TinyDetect 的文本模型是一个经过压缩的 RoBERTa 检测器,原始 FP32 版本约 500 MB,压缩后约 97 MB。这里的“压缩”不是简单把模型文件打包成 ZIP,而是同时处理模型权重、计算图结构和浏览器加载方式。
RoBERTa 是一种基于 Transformer 的语言模型架构,擅长通过上下文判断一段文本中词语和句子的关系。TinyDetect 使用它来区分人类文本与模型生成文本,输出的本质是分类结果,而不是对文章事实、文采或原创性做全面评价。
开发者首先对基础模型进行了轻量微调,训练数据混合了 HC3、GPT-wiki-intro、HAP-E、WildChat、Gutenberg,以及使用 Gemma 3 1B 在本地生成的一部分文本。这个数据组合覆盖了问答、百科式写作、网络对话和经典人类文本等场景,目标是避免模型只记住某一种生成器的固定风格。
但微调也会带来一个问题:模型可能在适应新数据后偏离原始检测能力,甚至对训练集中没有出现的文本风格表现更差。TinyDetect 使用了 WiSE-FT,也就是对原始权重和微调后权重进行插值。可以把它理解成“不要把车完全换成新发动机,而是在原发动机和改装发动机之间取一个折中”,用来降低微调造成的能力漂移。
模型压缩中更具体的一步,是把词嵌入矩阵从 ONNX 计算图中移出,并以 int4 格式保存,同时为每一行使用 fp16 缩放参数。该部分约占 19 MB,另有约 2 MB 的缩放数据。相比直接以 FP32 保存,int4 将每个参数压缩到 4 bit,代价是数值精度下降,但在文本分类这种不需要生成长序列的任务中,通常可以接受一定的量化误差。
| 项目 | 文本检测器 | 图像检测器 |
|---|---:|---:|
| 基础模型 | fakespot-ai/roberta-base-ai-text-detection-v1 | Community Forensics commfor-model-384 |
| 原始或参考体积 | 约 500 MB(FP32) | 约 26 MB |
| 浏览器侧体积 | 约 97 MB | 约 26 MB |
| 推理框架 | ONNX Runtime Web | ONNX Runtime Web |
| 运行位置 | 用户浏览器本地 | 用户浏览器本地 |
| 是否需要上传原文或原图 | 不需要 | 不需要 |
| 训练方式 | 轻量微调与 WiSE-FT 权重插值 | 使用已有开源模型 |
| 开源协议 | 基础模型 Apache-2.0 | MIT |
需要注意的是,约 97 MB 是模型压缩后的体积,不等于用户点击页面后立刻完成检测。浏览器还要承担模型下载、权重解码、ONNX 图初始化和推理时的内存占用;在移动网络或低内存设备上,首次打开体验仍可能明显慢于调用云端服务。
ONNX Runtime Web让浏览器变成推理环境
ONNX Runtime Web 是微软 ONNX Runtime 面向 Web 浏览器的推理运行时,它可以通过 JavaScript 在客户端加载 ONNX 模型,并根据浏览器能力选择 CPU、WebAssembly 或 WebGPU 等执行后端。
TinyDetect 选择它,核心原因是跨平台和部署成本。传统浏览器端模型往往要围绕 TensorFlow.js 或特定 WebGPU 实现做适配,而 ONNX Runtime Web 能直接承接从 PyTorch 等训练框架导出的 ONNX 模型。对于一个不追求极致吞吐、但希望“下载网页就能用”的检测工具,这种方案比较务实。
浏览器本地推理有三个直接好处。
- 隐私边界更清晰。 用户粘贴的文章、上传的图片不会为了检测而发送到远程服务器,至少从产品架构上减少了内容泄露、日志留存和第三方数据处理风险。
- 不依赖后端推理服务。 项目维护者不需要持续承担 GPU 服务器、并发扩容和接口防滥用成本,静态网页托管就可以提供 Demo。
- 离线化潜力更高。 模型首次下载并缓存后,部分使用场景可以减少对网络的依赖,尤其适合本地文档检查、课堂演示或内部工具。
代价也很明确:模型文件变成了用户侧下载成本,浏览器之间的执行能力差异会直接影响体验,而且模型一旦下发到客户端,就很难像云端模型那样隐藏权重或快速替换版本。
它不是“AI内容测谎仪”
AI 文本检测器是根据语言统计特征和模型行为模式,估计一段文本是否更像由 AI 生成的分类模型;它不能证明作者身份,也不能单独证明文本一定由 AI 生成。
这是 TinyDetect 最需要被强调的边界。检测结果更接近“模型判断这段文本与某类 AI 生成样本的相似程度”,而不是司法意义上的证据。文本经过人工改写、翻译、拼接、语法纠错或二次生成后,原有特征可能消失;相反,结构规整、用词重复的人工文本,也可能被误判为 AI 生成。
训练数据来源同样会影响结果。HC3、WildChat、Gutenberg 等数据的领域、语言、长度和写作习惯并不相同,模型在英文长文、短消息、学术摘要、非母语英语和中文文本上的表现不能直接等同。参考资料没有给出 TinyDetect 的统一测试集准确率、精确率、召回率或 F1 分数,因此不能把“能在浏览器运行”解读成“检测效果已经达到生产级”。
图像检测也面临类似问题。Community Forensics 的检测器主要学习生成图像在数据分布中留下的视觉和频域痕迹,但生成模型、放大工具、压缩算法和后期编辑都会改变这些痕迹。一张被社交平台重新编码、裁剪或截图的图片,可能与原始生成图像表现不同。
因此,TinyDetect 更适合做低风险的初筛工具,而不是学校处分、招聘筛选、内容下架或版权争议中的唯一依据。真正严肃的判断仍需要查看创作过程、版本历史、原始文件、元数据和人工证据。
与云端检测工具相比,TinyDetect赢在哪里
TinyDetect 的核心优势不是准确率,而是内容不出设备。市场上大量 AI 检测产品采用云端模式:用户上传文本或图片,服务器完成推理,再返回一个概率分数或解释报告。这种方式通常更容易集中更新模型、记录反馈和做大规模计算,但用户需要接受数据上传和服务商留存策略。
| 维度 | TinyDetect | 典型云端 AI 检测器 | |---|---|---| | 数据处理位置 | 浏览器本地 | 远程服务器 | | 隐私 | 原则上无需上传内容 | 取决于服务商隐私政策 | | 首次使用成本 | 需要下载约 97 MB 文本模型 | 通常只需上传内容 | | 模型更新 | 用户需重新加载或刷新缓存 | 服务商可在后台更新 | | 推理资源 | 依赖本地 CPU、WebAssembly 或 WebGPU | 依赖服务商服务器 | | 可审计性 | 模型和脚本可查看 | 多数实现不透明 | | 适合场景 | 本地初筛、隐私敏感内容、开发测试 | 大规模批处理、统一管理、报告系统 |
对于开发者,TinyDetect 还有一个容易被低估的价值:它展示了“浏览器端模型产品”的完整链路。模型导出、量化、权重拆分、静态资源部署和前端推理,往往比单纯调用一个远程接口更接近真正的产品工程问题。
真正的难点是加载体验和可信度
TinyDetect 目前最现实的产品瓶颈是首次加载时间,而不是推理本身。97 MB 对桌面宽带用户并不算不可接受,但对于移动网络、校园网络或受限办公环境,这已经足以成为明显的进入门槛。浏览器还可能因为标签页内存限制、缓存策略或 WebGPU 兼容性导致模型初始化失败。
第二个难点是模型更新。云端检测器可以在服务器切换新模型,用户无感完成升级;浏览器端模型则会被缓存到本地。项目需要处理版本号、缓存失效、模型完整性校验和旧模型回滚,否则用户可能长期使用过时权重。
第三个难点是结果解释。一个“AI 概率”数字很容易制造虚假的精确感。对用户而言,知道模型为什么做出判断、哪些片段贡献最大、在什么文本长度下结果不稳定,通常比看到一个 87% 的分数更有价值。当前资料并未显示 TinyDetect 已经提供经过验证的可解释性机制,这也是它从 Demo 走向严肃工具必须补上的部分。
第四个难点是对抗性。AI 文本检测与“人性化改写”天然处在攻防循环中。只要检测器依赖稳定的风格特征,生成器或改写工具就可能针对这些特征进行调整。像 Monica 等商业产品已经把 AI 检测和文本改写组合成产品功能,这意味着检测器很难通过一个固定模型永久解决问题。
对开发者的启发:检测器也可以是前端能力
TinyDetect 说明,浏览器端 AI 的可行边界正在扩大。过去把百兆级模型放到网页里,常被认为只适合演示;但随着 WebAssembly、WebGPU、ONNX Runtime Web 和浏览器缓存能力成熟,文本分类、图像筛选、OCR 后处理等小型任务已经可以在客户端完成。
不过,选择本地推理不能只看模型大小。更完整的评估至少包括以下指标:
- 首次可用时间: 从打开页面到用户能得到结果需要多少秒。
- 模型峰值内存: 下载体积只有一部分成本,解码和推理可能需要更多内存。
- 设备覆盖率: 低端 Android、iPhone、桌面浏览器和企业受限环境是否都能运行。
- 缓存命中率: 第二次使用是否能避免重复下载模型。
- 准确率与校准: 概率分数是否在不同领域、语言和文本长度上仍然可信。
- 失败策略: WebGPU 不可用、网络中断或内存不足时,是否能优雅降级。
在工程实践上,TinyDetect 采用“较大的文本模型加轻量图像模型”的组合也很有代表性。文本检测往往需要处理长上下文和复杂语言特征,模型体积更难压缩;图像分类模型则可以通过更紧凑的结构和输入尺寸控制体积。两者都放进浏览器并不意味着必须采用相同的优化路径。
结论:它解决了隐私问题,还没有解决检测问题
TinyDetect 是一个值得关注的浏览器端 AI 工程实践:它将约 500 MB 的 FP32 RoBERTa 文本检测模型压缩到约 97 MB,并让约 26 MB 的图像检测模型通过 ONNX Runtime Web 在本地运行。用户可以在不上传文本和图片的情况下完成初步检测,这是它相比云端工具最明确的差异化优势。
但它并没有改变 AI 检测的基本事实:检测结果是概率判断,不是来源证明;模型压缩降低了部署门槛,也可能带来精度损失;浏览器端推理保护了隐私,却把下载、内存和版本管理压力转移给了用户。
截至 2026 年 10 月 12 日,TinyDetect 更像一个完成度不错的开源 Demo 和技术样板,而不是可以直接用于高风险决策的权威鉴定系统。对于开发者,它值得研究的是本地推理链路;对于普通用户,它适合做快速参考;对于学校、平台和企业,最稳妥的做法仍是把它当作证据链中的一个信号,而不是最终结论。
参考来源
- TinyDetect GitHub 仓库:项目代码、模型压缩脚本与浏览器端实现。
- TinyDetect 项目讨论帖:开发者对模型来源、微调数据、WiSE-FT 和量化过程的说明。
- fakespot-ai/roberta-base-ai-text-detection-v1:TinyDetect 文本检测器所使用的基础模型页面。
- Community Forensics 模型: TinyDetect 图像检测器所引用的 Community Forensics 模型来源,具体模型标识为
commfor-model-384。