用TypeScript手写一个LLM
一份面向浏览器与 Node.js 开发者的 LLM 底层实现教程近期引发关注。它的价值不在于训练出 ChatGPT,而在于用熟悉的 TypeScript 拆开分词、注意力、训练与生成全过程。
TypeScript 开发者也开始手写 LLM 了
一份名为《Building an LLM from Scratch in TypeScript》的在线教程近日出现在开发者社区,试图用 TypeScript 从零解释并实现语言模型,而不是继续沿用 Python、PyTorch 和 Notebook 这一套默认组合。
**从零构建 LLM,是指不调用现成聊天模型,也不把 Transformer 封装成黑盒,而是亲手完成文本编码、张量运算、注意力计算、参数训练和自回归生成。**这里的“LLM”更准确地说是一个具备 GPT 类核心结构的小型语言模型;它可以完整跑通训练与推理,但参数量、数据规模和最终能力都无法与商用大模型相比。
这件事值得关注,不是因为 TypeScript 突然成了训练基础模型的最佳语言,而是因为它把模型原理带到了浏览器和 Node.js 开发者最熟悉的运行时里。过去,前端开发者接触 AI 通常从调用模型、拼接 Prompt 或搭建 Agent 开始,模型内部仍然是一只黑盒;现在,开发者可以在同一种语言中看见 token 如何变成向量、注意力如何聚合上下文,以及下一个 token 为什么会被采样出来。
**这套路线的核心价值是降低认知切换,而不是降低算力成本。**如果你已经熟悉 TypeScript,继续使用数组、类、模块系统和类型提示学习 Transformer,门槛确实低于先补 Python、NumPy 和 PyTorch;但模型训练需要的矩阵乘法、自动微分、GPU 内核与显存管理,并不会因为换成 TypeScript 就消失。
先分清楚:这是模型实现教程,不是套壳聊天应用
**模型实现与模型应用是两件不同的事。**使用 LangChain、Agent 框架或模型服务时,开发者处理的是提示词、工具调用、记忆和工作流;从零构建模型时,开发者面对的是矩阵形状、梯度传播、损失函数、参数初始化和数值稳定性。
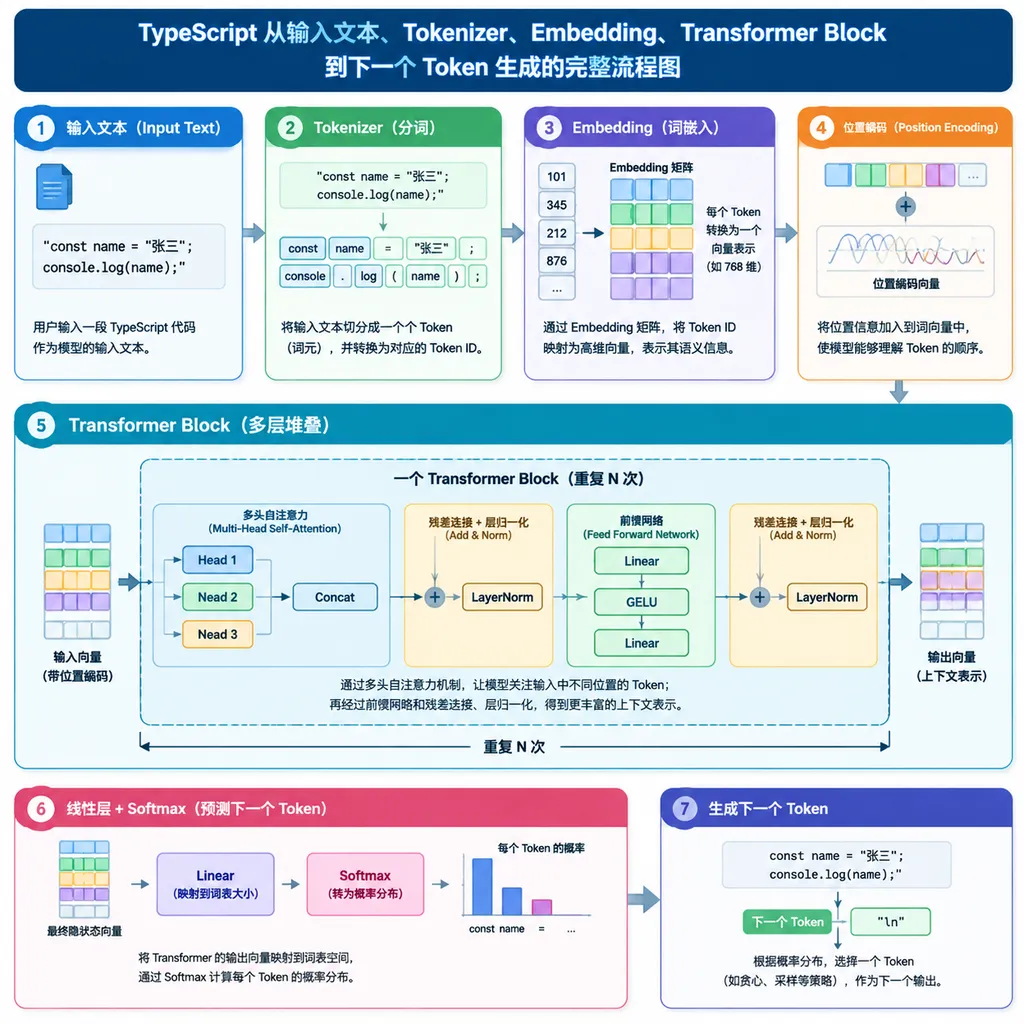
一个最小的 GPT 类语言模型通常包含以下路径:
- 将文本切分为 token,并映射为整数 ID;
- 将 token ID 转换为可训练的词向量;
- 加入位置信息,让模型知道 token 的先后顺序;
- 通过多头因果自注意力读取上下文;
- 通过前馈网络进一步变换特征;
- 使用残差连接和归一化稳定训练;
- 将隐藏状态投影为词表上的概率分布;
- 计算交叉熵损失并反向传播;
- 根据温度、Top-k 或 Top-p 策略逐 token 生成文本。
**只要这条链路能够独立运行,开发者就已经实现了一个语言模型的基本闭环。**它未必“大”,也未必好用,但它与 GPT 类模型在机制上属于同一家族。
TypeScript 在这里究竟扮演什么角色
**TypeScript 是带有编译时类型检查的 JavaScript,而不是一种新的机器学习运行时。**编译器完成检查后会擦除类型,最终执行的仍然是 JavaScript;类型系统不会自动带来 GPU 加速,也不会改变矩阵乘法的运行方式。
这恰好解释了 TypeScript 教学路线的优势与边界。类型可以把张量维度、模型配置、缓存状态和训练批次表达得更清楚,但实际性能仍取决于底层张量库、WebGPU、WebAssembly,或者 Node.js 侧的原生扩展。
例如,一个教学模型的配置可以先被明确描述为:
interface ModelConfig {
  vocabSize: number;
  contextLength: number;
  embeddingDim: number;
  numHeads: number;
  numLayers: number;
  dropout: number;
}

const tinyConfig: ModelConfig = {
  vocabSize: 4096,
  contextLength: 128,
  embeddingDim: 256,
  numHeads: 8,
  numLayers: 6,
  dropout: 0.1
};
**类型定义最大的实际收益是让错误更早暴露。**当注意力头数不能整除嵌入维度,或者输入序列超过上下文长度时,开发者可以在配置检查阶段报错,而不是等到一连串矩阵运算之后才收到难以理解的维度异常。
不过,number[][] 只适合解释概念,不适合真正训练模型。JavaScript 的普通数组包含对象管理和边界处理开销,连续数值计算至少应使用 Float32Array 等 TypedArray;规模继续增长后,则应交给具备 GPU 或原生后端的张量引擎。
第一关不是注意力,而是 Tokenizer
**Tokenizer 是把文本转换为模型可处理整数序列的组件。**语言模型并不直接读取汉字或英文单词,它看到的是 token ID,例如一段文本可能被编码为 [37, 912, 184, 6]。
初学实现可以从字符级 Tokenizer 开始。它的好处是逻辑透明:收集训练文本中出现过的字符,建立字符到整数的映射,再提供编码和解码函数。它的缺点也明显:序列通常更长,中文、Emoji、组合字符和多语言文本会迅速放大词表处理问题。
**字符级分词适合验证训练闭环,但不适合模拟现代基础模型的真实输入管线。**更进一步的实现通常会转向 BPE、WordPiece 或 Unigram,其中 BPE 会反复合并高频符号组合,让常见片段使用更少 token,同时保留处理生僻词的能力。
Tokenizer 还有一个经常被低估的问题:训练与推理必须使用完全相同的词表、规范化规则和特殊 token 定义。只要编码规则发生偏移,即使模型权重没有变化,输出也可能完全失效。
第二关是理解张量形状
**张量是带有多个维度的数值数组,也是神经网络计算的基本数据结构。**对于一个批次的 token,输入通常可以写成 [B, T],其中 B 是批次大小,T 是序列长度;经过 Embedding 后,它会变成 [B, T, C],其中 C 是隐藏维度。
注意力计算最关键的三个张量是 Query、Key 和 Value。它们由同一份输入经过不同的线性映射产生,可以分别理解为“当前 token 想找什么”“每个历史 token 提供什么索引”以及“每个历史 token 实际携带什么内容”。
缩放点积注意力可以概括为 softmax(QKᵀ / √d) · V。QKᵀ 计算 token 之间的相关程度,除以 √d 用于控制数值尺度,Softmax 将分数转成权重,最后对 V 做加权求和。
对于自回归语言模型,还必须加入因果遮罩。位置 t 只能读取位置 0 到 t,不能偷看后面的正确答案;否则训练损失会很好看,生成时却无法工作。
function causalMask(row: number, col: number): number {
  return col <= row ? 0 : Number.NEGATIVE_INFINITY;
}
**多头注意力不是把注意力重复计算几次,而是把隐藏维度拆成多个子空间。**以 embeddingDim = 256、numHeads = 8 为例,每个头的维度是 32;不同头可以分别学习局部搭配、远距离依赖、标点结构或其他统计模式,最后再拼接回 256 维。
第三关是反向传播,而不是前向推理
**前向传播负责得到预测,反向传播负责告诉每一个参数应该向哪个方向调整。**手写线性层和 Softmax 并不算太难,真正让实现复杂起来的是计算图、梯度累积、广播规则以及每种算子的导数。
教学项目通常有三条实现路线:
| 路线 | 实现难度 | 运行性能 | 能学到什么 | 适合场景 | |---|---:|---:|---|---| | 手写标量自动微分 | 高 | 很低 | 计算图、链式法则、梯度累积 | 理解反向传播 | | TypedArray 手写矩阵运算 | 很高 | 较低 | 内存布局、矩阵形状、数值稳定性 | 深入系统细节 | | 使用 JS 张量库 | 中 | 中到高 | Transformer 结构与训练流程 | 跑通可用原型 | | Python + PyTorch | 中 | 高 | 标准研究与工程工作流 | 正式训练、复现实验 |
**如果目标是理解原理,先手写一个微型自动微分引擎通常比直接依赖框架更有价值。**每个数值节点保存当前值、梯度、父节点和局部求导规则,反向传播时按照拓扑序逆向执行,便能看清损失如何影响权重。
**如果目标是训练一个能输出连贯文本的小模型,就不应执着于手写所有底层算子。**矩阵乘法、LayerNorm 和 Softmax 都存在大量数值与性能细节,教学代码一旦扩展到较大批次,JavaScript 主线程很容易成为瓶颈。
一个适合初学者的模型规模
**入门模型应该小到能快速失败,而不是大到看起来更像商用 LLM。**推荐先使用 4,096 词表、128 token 上下文、256 隐藏维度、6 层 Transformer 和 8 个注意力头,这不是性能最优配置,而是便于检查各层形状的教学配置。
按照这一配置,仅词嵌入矩阵就包含 4096 × 256 = 1,048,576 个参数。若使用 32 位浮点数,仅这一部分权重约占 4 MiB;训练时还要额外保存梯度、优化器状态和中间激活,实际内存消耗会是权重本身的数倍。
**训练内存不能只按参数文件大小估算。**以 Adam 类优化器为例,除参数外通常还需要一阶与二阶动量状态;再加上梯度和各层激活,即便一个参数量不算大的模型,也可能迅速碰到浏览器标签页或普通 Node.js 进程的内存边界。
参数量可以用下式粗略理解:
总参数 ≈ 词嵌入参数
       + 层数 ×(注意力参数 + 前馈网络参数 + 归一化参数)
       + 输出投影参数
**前馈网络往往比注意力矩阵本身占用更多参数。**如果前馈层中间维度取隐藏维度的 4 倍,那么每个 Transformer Block 中,仅两次线性映射就大约需要 8C² 个权重;这也是增加隐藏维度后,参数量近似按平方增长的原因。
浏览器与 Node.js 的分工并不相同
**浏览器适合展示、交互和小规模推理,Node.js 更适合数据预处理、训练脚本和文件管理。**两者都运行 JavaScript,但资源限制、线程模型和可用接口明显不同。
浏览器路线最大的优势是零安装和可视化。开发者可以实时绘制损失曲线、观察注意力热力图,甚至允许用户在本地输入一段文本后完成微调实验;如果使用 WebGPU,矩阵运算还可以交给 GPU,而不必把数据发送到服务器。
浏览器路线最大的限制则是兼容性和资源预算。WebGPU 的可用性取决于浏览器、操作系统与显卡驱动,长时间训练还会占用页面资源;模型权重的下载、缓存和序列化也必须考虑 IndexedDB、Cache Storage 以及标签页生命周期。
Node.js 路线更接近传统训练程序。它可以直接读取语料文件、使用 Worker Threads 分担 CPU 工作、保存检查点,并通过脚本稳定复现实验;但 Node.js 的事件循环不会自动加速 CPU 密集型矩阵计算,真正的性能仍要依靠原生算子、WASM、WebGPU 或其他硬件后端。
| 维度 | 浏览器 | Node.js | Python/PyTorch | |---|---|---|---| | 安装门槛 | 最低,可打开即用 | 较低 | 中等,需要环境管理 | | 本地数据隐私 | 强,可完全在端侧运行 | 强,可本机运行 | 强,可本机运行 | | GPU 计算 | WebGPU,兼容性需确认 | 取决于运行时与库 | CUDA/ROCm 生态成熟 | | 数据处理 | 受沙箱限制 | 文件与流处理方便 | 数据工具最丰富 | | 教学可视化 | 最方便 | 需要额外界面 | Notebook 生态成熟 | | 大规模训练 | 不适合 | 通常不适合 | 最合适 |
**TypeScript 的合理定位是教学、原型和端侧实验,而不是取代 PyTorch 训练基础模型。**它可以让 Web 开发者更快理解 Transformer,也适合构建可交互的模型演示,但到了多 GPU、混合精度、分布式训练和高性能内核优化阶段,Python 生态仍占据压倒性优势。
训练时最容易踩的五个坑
**数值稳定性是手写模型最先遇到的隐形故障。**Softmax 如果直接对较大的 logits 求指数,可能产生 Infinity;标准处理方式是在指数运算前减去当前行最大值,这不会改变最终概率,却能显著降低溢出风险。
**训练样本错位会让模型学不到下一个 token 预测。**输入应当是序列的前 T 个 token,标签则是整体向右移动一位的后 T 个 token;如果输入和标签完全相同,模型学到的就可能是复制当前 token,而不是预测下一个 token。
**Dropout 在训练与生成阶段必须采用不同模式。**训练时随机丢弃部分激活用于正则化,推理时则要关闭随机丢弃;如果忘记切换,完全相同的输入也会出现不必要的输出波动。
**随机种子只能提高可复现性,不能保证跨平台逐位一致。**浏览器、Node.js、不同 GPU 后端和并行归约顺序都可能带来浮点误差,因此更现实的检查方式是比较损失趋势和输出分布,而不是要求每个参数完全相同。
**生成质量不能只看训练损失。**小语料上的损失持续下降,可能意味着模型正在背诵训练文本;至少要保留验证集,并同时检查训练损失、验证损失、重复率以及未见提示上的续写效果。
推荐的实战顺序
**最有效的学习路径是逐层增加复杂度,并为每一步准备可验证结果。**一次性写完整个 Transformer,最终只能得到一堆无法定位的 NaN 或维度错误。
第一阶段可以只实现字符级语言模型。输入一小段重复性较强的文本,验证编码和解码完全可逆,并确认模型能记住局部模式。
第二阶段可以实现二维矩阵乘法、转置、逐元素运算和稳定 Softmax。每个算子都应使用极小矩阵手工核对结果,并检查输出形状。
第三阶段可以只实现单头因果注意力。将注意力权重画成热力图,确认右上角未来位置全部被遮挡,且每一行权重之和接近 1。
第四阶段可以加入多头注意力、前馈层、残差连接和 LayerNorm。此时先做一次前向传播,不急于训练,并记录每一层输出均值、方差和最大绝对值。
第五阶段可以接入自动微分与优化器。先在极小数据集上测试模型能否过拟合;如果连几十条样本都无法拟合,通常说明梯度、标签或参数更新存在错误。
第六阶段可以加入检查点、验证集、温度与 Top-k 采样。只有完成保存、加载和继续训练,项目才算从算法演示进入完整实验系统。
这类教程真正改变了什么
**TypeScript 手写 LLM 的最大意义,是把前端开发者从“模型消费者”变成“模型机制的观察者”。**当开发者亲自处理上下文窗口、KV 状态、采样温度和显存占用后,再使用 Agent 框架或推理服务时,会更容易判断哪些问题来自提示词,哪些来自模型能力,哪些只是运行时约束。
这条路线同样有明确上限。现代基础模型涉及海量语料治理、分布式并行、低精度训练、高性能注意力内核、容错检查点与大规模评测,不可能靠一个浏览器项目完整复刻;所谓“从零构建 LLM”,更多是在较小规模上复现核心机制,而不是从零复制一个 ChatGPT。
**与 Python 版从零构建教程相比,TypeScript 版本不是更专业,而是更贴近另一批开发者的工作现场。**Python 项目拥有成熟的研究工具、GPU 生态和公开复现经验;TypeScript 项目则能把模型直接嵌入网页、开发者工具、桌面应用和 Node.js 服务,让模型内部状态更容易被可视化和交互。
最终判断很简单:如果目标是训练更强模型,优先学习 Python 和 PyTorch;如果目标是彻底理解 GPT 的每一个零件,同时已经熟悉 Web 技术,那么用 TypeScript 手写一个小模型,是一条合理而且反馈足够快的入门路线。
参考来源
- rasbt/LLMs-from-scratch:从零实现 GPT 类语言模型的经典开源项目,覆盖数据处理、预训练与微调流程。
- Datawhale:llms-from-scratch-cn:面向中文读者的 LLM 从零构建资料,包含 GPT、Llama、GLM 和 RWKV 等架构内容。
- karpathy/nanoGPT:结构精简的 GPT 训练实现,可用于对照理解训练循环、模型配置与生成逻辑。
- Hugging Face Tokenizers:高性能分词器实现,可用于理解 BPE、预分词与词表训练的工程化方案。
- Hugging Face Transformers 文档:主流 Transformer 架构、分词器和生成策略的参考资料。