560B模型压到4卡,蚂蚁百灵开源
蚂蚁百灵开源Ling-3.1-flash:总参数560B、激活25B,最高支持1M上下文。它真正值得关注的不是参数规模,而是292GB量化权重、高缓存场景延迟和面向长任务的吞吐优化。
蚂蚁百灵开源Ling-3.1-flash,重点不是又一个560B模型
蚂蚁百灵在10月15日正式开源Ling-3.1-flash,这是一个面向办公协作、长周期软件开发和复杂Agent任务的混合推理模型。模型在9月30日上线服务,经过约两周体验期后开放权重;截至10月16日,模型文件已经可以从Hugging Face获取,采用MIT许可证。(ithome.com)
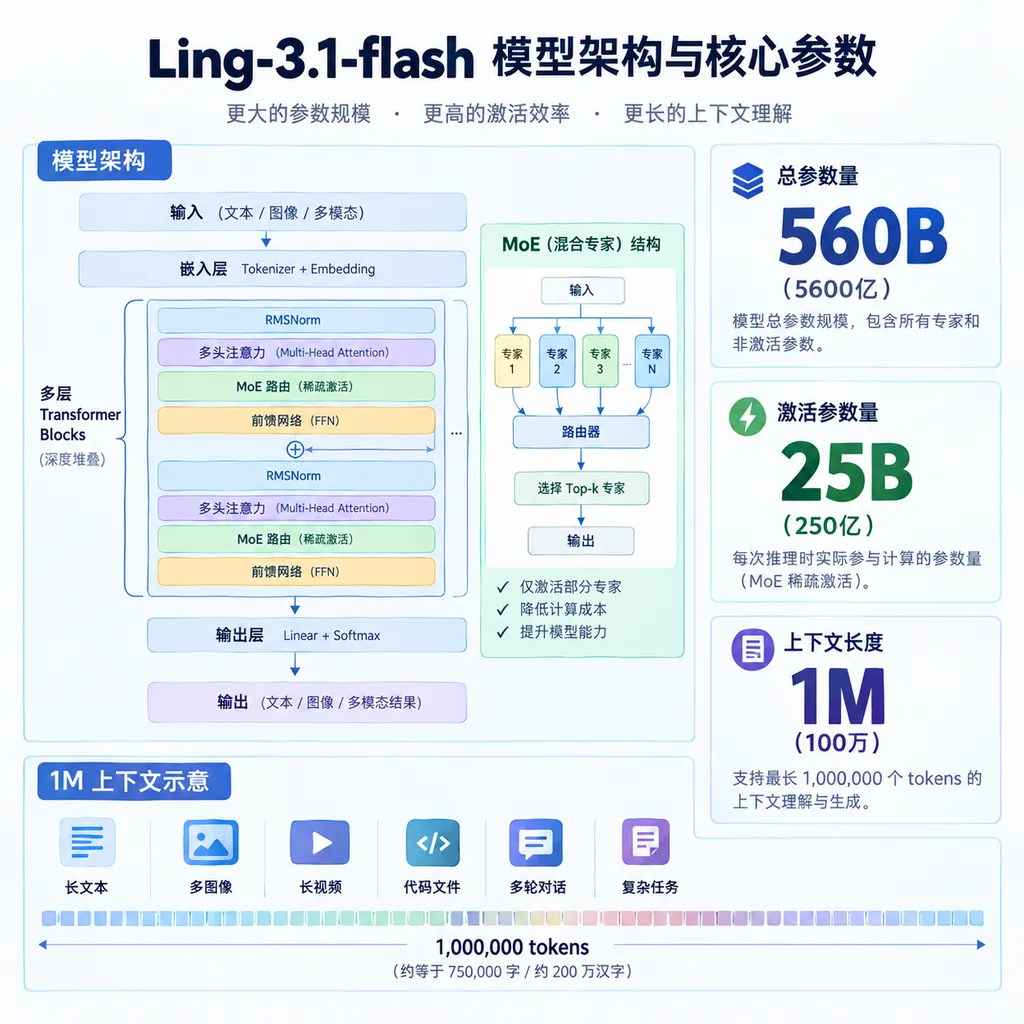
**Ling-3.1-flash是一个总参数约560B、每个Token激活约25B参数的混合线性MoE模型。**它最高支持1M Token上下文,核心定位不是追求单轮聊天的极限跑分,而是在长文档、代码仓库和连续工具调用中维持较高吞吐。
这次开源最有价值的部分,是蚂蚁百灵把一个560B级模型做成了相对可部署的工程产品。通过对路由专家采用MXFP4量化、对稠密层保留block-FP8,模型权重占用从约534GB降至292GB,下降约45.3%;在官方披露的对应Hopper GPU测试配置中,服务所需GPU数量从8卡降至4卡。(m.ithome.com)
不过,“4卡可跑”不能被理解成4张普通消费级显卡就能部署。292GB只是权重体积,实际服务还要预留KV Cache、运行时、通信缓冲和并发请求空间;官方Hugging Face模型卡给出的推荐启动配置仍是8张H200,而4卡示例对应的是显存更充裕的GB300配置。换句话说,Ling-3.1-flash降低的是服务器级部署门槛,不是把560B模型变成了工作站模型。(huggingface.co)
560B容量,实际只激活4.46%
**MoE是混合专家架构,它让每个Token只调用模型中的少数专家网络,而不是计算全部参数。**Ling-3.1-flash共有560B总参数,但每个Token只激活约25B,激活比例约为4.46%。这意味着模型可以保留较大的知识容量,同时把单步推理计算量控制在数百亿参数级别。
根据公开模型卡,Ling-3.1-flash采用Hybrid-linear MoE架构,包含63层KDA和9层Gated MLA,比例为7:1;模型拥有4个Dense层、512个路由专家和1个共享专家,每个Token选择8个路由专家。隐藏层维度为4096,词表规模为157184。(huggingface.co)
这里的KDA可以理解成一种更偏向持续更新记忆状态的线性注意力机制,而Gated MLA负责保留关键位置的精细注意力计算。两者混合的目的,是避免所有Token之间都进行完整的二次复杂度计算,同时不完全牺牲传统注意力在复杂推理中的表现。
与Ling-3.0-flash相比,Ling-3.1-flash并不是一次常规的小版本升级。前代模型总参数为124B、激活参数为5.1B;新模型的总参数扩大到约4.52倍,激活参数扩大到约4.90倍,定位也从高频、低成本任务转向更复杂的长周期工作流。(developer.ant-ling.com)
| 模型 | 总参数 | 每Token激活参数 | 最高上下文 | 主要定位 | |---|---:|---:|---:|---| | Ling-3.1-flash | 560B | 25B | 1M | 长周期开发、办公协作、复杂Agent | | Ling-3.0-flash | 124B | 5.1B | 1M | 高频处理、批量任务、低延迟交互 | | Ling-3.0-flash-VL | 124B | 5.5B | 256K | 图像、文本、视频多模态任务 | | Ling-2.6-1T | 1T | 63B | 1M | 旗舰推理、复杂多跳任务 |
需要注意的是,上表中的“最高上下文”不等于所有在线服务默认开放的上下文长度。Ling-3.1-flash模型架构最高支持1M,但蚂蚁百灵官方服务目前开放256K,OpenRouter等托管服务显示的窗口也约为262K;要真正运行1M上下文,通常需要自行部署,并配置长上下文并行推理方案。(developer.ant-ling.com)
1M上下文真正考验的是显存和首Token时间
**1M上下文是模型单次请求最多可处理约100万个Token,而不是模型能够无成本记住无限信息。**对于企业知识库、代码仓库分析和办公助手,真正影响体验的指标通常不是最大窗口,而是长输入后的首Token时间、缓存命中率以及并发吞吐。
蚂蚁百灵为长上下文提供了PCP和DCP并行推理方案,并通过算子融合与DSpark投机解码减少推理开销。PCP和DCP的核心思路,是把超长序列或解码过程分散到多张GPU上处理,避免单卡成为上下文长度和KV Cache容量的瓶颈。
在一组接近企业知识问答的模拟生产请求中,平均输入长度约25.47K Token、输出长度约224 Token,缓存命中率为76%。在8卡Hopper配置下,Ling-3.1-flash的平均首Token时间为604毫秒,相邻输出Token平均间隔为3.28毫秒。(m.ithome.com)
这组数据比单纯的“每秒生成多少Token”更有参考价值。用户提交数万Token的合同、研究报告或代码后,604毫秒即可看到第一个Token,意味着系统没有因为长输入出现数秒甚至数十秒的沉默;3.28毫秒的相邻Token间隔,折算为解码阶段每秒约305个Token,但它不能直接等同于包含预填充、排队和网络开销的端到端吞吐。
在另一组容量测试中,平均输入约8.5K Token、输出约800 Token,4卡Hopper配置达到约1.36 QPS,同时满足首Token时间P50低于3秒、相邻输出Token间隔P90低于70毫秒的约束。这个结果说明Ling-3.1-flash的优化方向很明确:它不是只为单用户跑出高速度,而是要让固定GPU预算承载稳定的企业请求量。(m.ithome.com)
Artificial Analysis指数41,但速度比排名更关键
**Artificial Analysis智能指数是一个汇总多项推理、知识和任务基准的综合指标。**Ling-3.1-flash目前的公开智能指数约为41,公开输出速度约为每秒210 Token。(m.ithome.com)
指数41意味着它进入了当前高性能模型的主流区间,但还不能仅凭这个分数断言模型已经达到闭源旗舰的综合能力。更值得关注的是,Ling-3.1-flash试图同时提供较大的模型容量、较低的Token价格和较高生成速度,这三项通常很难兼得。
官方模型卡重点列出了GDPVal-AA V2.1、HealthBench Professional、FrontierSWE、Terminal-Bench 4.0、SWE-bench Pro、AutomationBench和MCP-Atlas等任务。它们覆盖办公交付、医疗专业问答、软件工程和终端工具操作,明显比只测数学选择题或短代码生成更接近Agent的实际工作方式。(huggingface.co)
Ling-3.1-flash还增强了JSON Schema支持,这对生产部署非常重要。Agent调用工具时,模型不是输出一段“看起来像JSON”的文本,而是要严格生成符合字段类型、必填项和枚举约束的结构化参数;否则模型能力再强,也会因为一个括号、一处字段名错误而让整条工作流中断。
在线价格很低,但3.1并不是3.0的平替
**Ling-3.1-flash当前在线价格采用限时2.5折,计价单位为每100万Token。**OpenRouter价格为输入0.075美元、输出0.225美元、缓存读取0.015美元;Ling Studio价格为输入0.5元、输出1.5元、缓存读取0.1元。(m.ithome.com)
| 平台 | 输入价格/百万Token | 输出价格/百万Token | 缓存读取/百万Token | |---|---:|---:|---:| | OpenRouter | 0.075美元 | 0.225美元 | 0.015美元 | | Ling Studio | 0.5元 | 1.5元 | 0.1元 |
在前述平均输入25.47K、输出224 Token、缓存命中率76%的模拟请求中,如果按OpenRouter优惠价格粗略计算,单次Token费用约为0.0008美元;按Ling Studio价格约为0.0053元。这个估算只计算模型Token费用,不包括服务器、网络、向量检索、文件解析和Agent工具执行成本。
Ling-3.1-flash的在线价格虽然便宜,但仍约为Ling-3.0-flash的3.6倍。原因并不复杂:3.1每Token激活25B参数,而3.0只激活5.1B,前者承担了更高的计算和显存访问成本。因此,批量分类、摘要、清洗等短任务仍更适合Ling-3.0-flash;只有当任务需要长时间维护状态、跨文件修改代码或多轮调用工具时,3.1增加的成本才更容易转化成完成率。(optimtoken.optimnow.io)
判断:这是一款服务器模型,不是“人人本地运行”的模型
**Ling-3.1-flash最大的意义,是把开源模型竞争从跑分重新拉回部署效率和任务吞吐。**560B和1M上下文本身并不稀缺,真正稀缺的是模型能否在可接受的GPU数量上运行,能否在输入数万Token后快速返回,能否让工具调用稳定遵循Schema,以及能否在长周期任务中减少上下文失控。
它目前仍有三个明显限制。第一,292GB量化权重决定了它主要属于服务器和集群,而不是个人本地模型;第二,1M是模型上限,当前多数在线服务仍停留在256K左右;第三,官方披露的高吞吐结果高度依赖Hopper级GPU、缓存命中和专用推理优化,不能直接复制到任意硬件。
但对有H100、H200、H800或新一代Blackwell服务器的团队来说,Ling-3.1-flash确实提供了一个值得测试的新选项。它不一定是最聪明的开放权重模型,却可能是当前少数认真回答“一个大模型如何处理长资料、长期运行并承接稳定并发”这一问题的模型。
参考来源
- IT之家:蚂蚁百灵开源Ling-3.1-flash,最高支持1M上下文——整理模型参数、量化部署、延迟、吞吐和在线价格数据。
- Hugging Face:inclusionAI/Ling-3.1-flash——官方模型卡、MIT许可证、架构参数、评测范围和部署配置。
- GitHub:inclusionAI/Ling——蚂蚁百灵Ling系列开源代码与项目入口。
- GitHub:inclusionAI/ling-cookbook——Ling系列本地部署方案、推理框架适配与工程实践。