Rust 复现 PyTorch,nanoGPT 逐 bit 对齐
一个名为 DenseCore 的 Rust 深度学习框架据称能让未经修改的 nanoGPT 在 50 步训练中与 PyTorch 逐 bit 一致,覆盖初始化、loss、梯度和权重。它展示了复现数值行为的工程难度,但目前仍是开发者的自测结果,不能等同于跨平台或大规模训练验证。
DenseCore 做到了什么
一名开发者近日在 Reddit 发帖称,他用 Rust 开发的深度学习框架 DenseCore,已经可以运行 Karpathy 的 nanoGPT,并在自己测试的 50 个训练步骤中,与 PyTorch 得到逐 bit 一致的结果。这里的“一致”不是 loss 数值看起来差不多,而是帖子所称的初始化权重、loss、梯度和更新后的权重都完全相同,测试还包含 dropout。
DenseCore 是一个用 Rust 编写、提供类 PyTorch Python 接口的深度学习框架。它试图让现有 PyTorch 风格代码在底层由 Rust 实现,而不是要求用户先把模型训练脚本改写成另一套语言或框架。按照发帖者的描述,他让 import torch 指向 DenseCore,再直接运行未经修改的 nanoGPT;“未经修改”是这项结果的关键限定,因为它意味着测试的不只是模型公式,还包括框架对 PyTorch 接口和数值行为的复现。
这是一项值得关注的工程实验,但目前不应被解读为 DenseCore 已经替代 PyTorch,或已经证明能在任意设备、任意模型上复现 PyTorch。现有材料是开发者的项目进展与自测描述,样本是 50 步训练;帖文没有提供足够细节来确认测试硬件、软件版本、完整复现脚本、性能数据,也没有独立验证结果。准确的新闻判断应当是:DenseCore 展示了复现特定 PyTorch 工作负载数值行为的可能性,而不是已经完成通用兼容性认证。
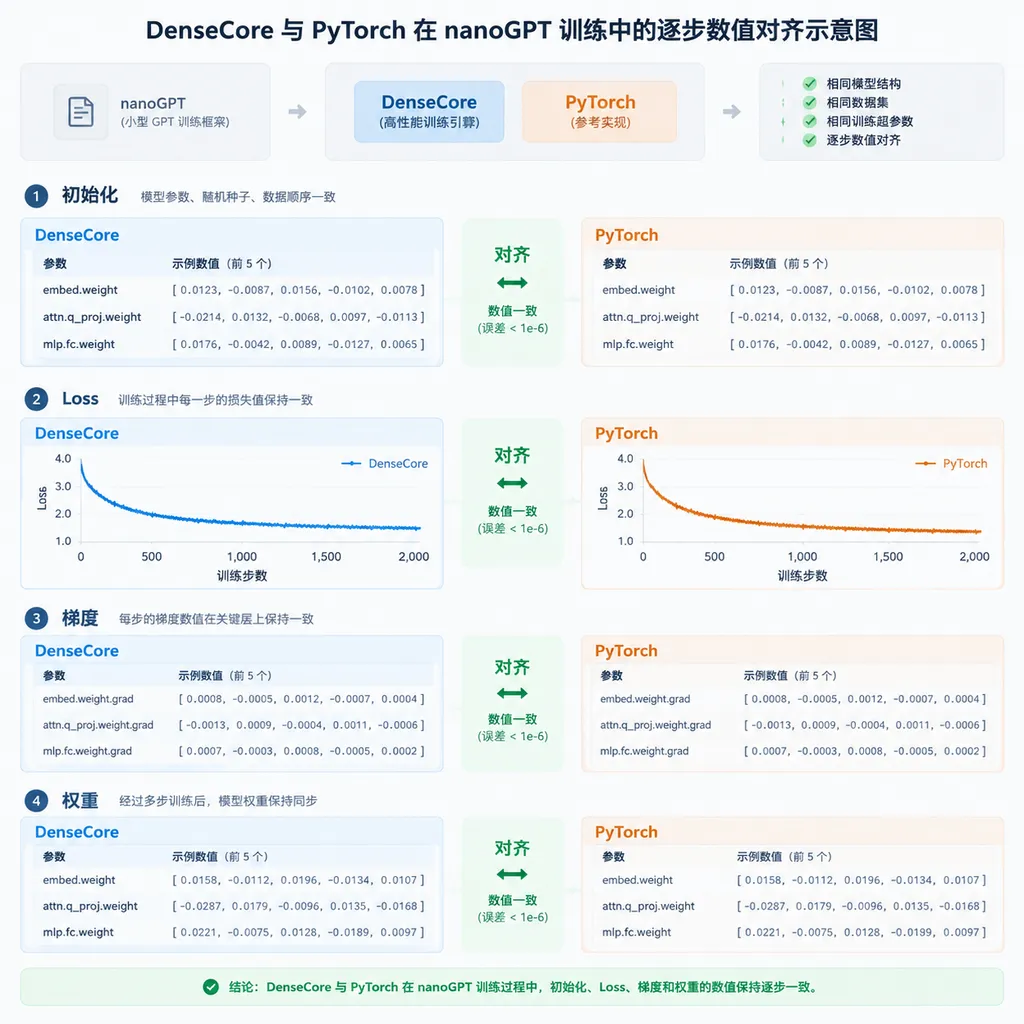
“逐 bit 一致”为什么不容易
逐 bit 一致是指两个实现对同一计算产生完全相同的二进制浮点结果,而不仅仅是误差落在容差范围内。对深度学习框架来说,这个要求比“模型能跑通”严格得多:只要中间某一步的舍入结果不同,后续运算就可能把差异继续传下去。
普通用户常用容差判断两个张量是否接近,例如允许误差小于某个阈值;训练评估通常也关注 loss 是否相近、模型效果是否达到同一量级。但 DenseCore 发帖者强调的是更苛刻的目标:同一输入、同一初始化和同一训练配置下,逐元素结果完全一致。它像是要求两台计算器不只算出同一个答案,还必须在每一步中采用相同的中间舍入方式。
浮点运算并非实数上的精确运算。以浮点数求和为例,先计算 (a+b)+c 与先计算 a+(b+c),可能因为中间舍入产生不同结果。并行归约、循环展开、向量化指令和编译器优化都可能改变运算顺序。只要某个算子的结果不同,后续的矩阵乘法、归一化、梯度计算和参数更新就可能继续放大或传播差异。
因此,复现 PyTorch 不只是照着论文里的公式重新写一遍。框架实际执行的是一条包含算子实现、内存布局、分块策略、随机数生成、浮点舍入和编译器行为的计算路径。要把结果对齐,DenseCore 必须追踪的不是“理论上该怎么算”,而是目标 PyTorch 版本在目标环境里“实际上怎么算”。
实现细节藏在算子路径里
发帖者提到,PyTorch CPU attention 的实现并非简单套用教科书公式,而是使用了 FlashAttention 风格的计算内核;开启 dropout 时还会走另一条路径。这说明即使两个实现都完成了注意力计算,矩阵分块方式、掩码处理、随机数消耗顺序或中间张量的生成方式不同,也可能让后续结果不再一致。
FlashAttention 的核心思路是在计算注意力时减少显式读写完整注意力矩阵的需要,从而降低内存访问开销。它的价值主要是性能和内存效率,不是改变注意力的数学定义。但一旦把它作为具体的执行实现,分块和累积顺序就成为数值行为的一部分。复现者需要匹配的不只是公式,还包括内核如何安排计算。
Dropout 又增加了一层约束。训练时它会按随机掩码丢弃部分激活,因此随机数生成器的种子、每次调用消耗随机数的数量与顺序,都会影响训练结果。即便两个框架使用同一个初始 seed,只要某个算子的实现多消耗或少消耗了一组随机数,后续层拿到的掩码就会不同。DenseCore 据称在开启 dropout 时仍能对齐,这比只验证无随机性的前向计算更有信息量,但仍然只覆盖发帖者测试的工作负载和步骤。
优化器和辅助函数也可能成为差异来源。发帖者举例称,Adam 在每个线程处理分块的尾部元素时,因为编译器对循环尾段的处理与融合方式不同,舍入结果会出现差异;clip_grad_norm_ 的计算也不是简单地把 max_norm 除以范数,而是通过 reciprocal() 再乘以 max_norm。这类实现细节看上去微小,却足以在严格的逐 bit 比较中被发现。
这也解释了为什么“按定义重写 Adam”不等于“复现 PyTorch 的 Adam”。训练框架对外提供的是操作接口,内部执行可能涉及融合运算、特定张量布局和边界分支。只有把这些路径也纳入比较,逐 bit 对齐才有可能成立。
nanoGPT 是合适的压力测试,但不是全套证明
nanoGPT 是一个刻意保持精简的 GPT 训练项目,适合检验 Transformer 模型训练链路,也让研究者较容易看清执行差异从哪里出现。把原始训练脚本不作修改地交给另一套框架运行,可以同时检验接口兼容性和数值兼容性;比只用几个手写算子做单元测试,更接近真实训练程序。
不过,50 步测试能够证明的范围需要说清楚。它说明发帖者在这次测试的配置下,观察到 DenseCore 与 PyTorch 的结果一致;它不能自动推导出训练 5000 步、换一个模型、换一张 GPU、换一个操作系统,结果仍然一致。某些差异可能要在更长训练、特定张量形状或特定边界条件下才会出现。更何况,逐 bit 对齐不等于训练速度更快、显存占用更低或部署更稳定。
| 维度 | 帖文所述结果 | 目前仍缺少的信息 | |---|---|---| | 工作负载 | 未修改的 nanoGPT | 完整配置、数据和运行脚本 | | 训练步数 | 测试 50 步 | 更长训练的连续验证 | | 数值比较 | 初始化、loss、梯度和权重逐 bit 一致 | 比较工具、张量范围及完整日志 | | 随机性 | 测试包含 dropout | 随机数生成器和跨环境的详细行为 | | 性能 | 没有给出 | 速度、内存占用和与 PyTorch 的基准对比 | | 兼容范围 | 类 PyTorch Python 接口 | 算子覆盖率、设备与版本矩阵 |
这个表也划出了 DenseCore 下一阶段最需要补足的证据。要让项目从“有意思的复现结果”迈向可供他人评估的框架,公开测试脚本、固定依赖版本、列出硬件与操作系统、提供逐步对照日志,以及覆盖更多模型和张量形状,都会比一句“能对齐”更有说服力。若项目目标包括替代或兼容现有训练环境,还需要明确哪些 PyTorch API 已实现、哪些只是接口占位,以及出现不支持算子时会怎样处理。
逐 bit 可复现并不等于跨机器可复现
可复现训练是指在明确的代码、数据、随机种子和计算环境下,能够重现训练过程或结果;逐 bit 可复现是其中要求最严格的一种。它对调试特别有价值,但“同一台机器上两个实现对齐”和“不同机器得到相同结果”是两个不同的问题。
发帖者还提到,他对同一版本 PyTorch 在 macOS 与 Linux x86 环境下进行的 26 个操作测试中,只有 1 个操作给出了相同结果。现有帖子片段没有说明这 26 个操作的具体清单、其余 25 个差异的幅度和原因,因此这个观察应当被视为开发者报告的实验结果,而不是对 PyTorch 跨平台行为的完整统计结论。它至少提示了一点:框架版本号相同,不代表底层算子、编译选项和硬件路径完全相同。
PyTorch 面对不同设备时可能使用不同的内核;操作系统、处理器指令集和编译器版本也会影响执行路径。GPU 计算还可能涉及并行归约的顺序、原子操作和确定性算法开关。因而,一个严谨的复现报告需要把“在哪个环境中一致”写清楚,而不能把单机上的 bitwise 结果扩展成“任何机器上都一样”。
对模型开发者来说,这个边界有实际意义。调试一个新的优化器或算子时,逐 bit 对齐可以排除框架迁移导致的数值偏差;但用于长期实验复现时,仍需保存代码版本、依赖、数据处理配置、硬件信息和随机数状态。逐 bit 结果是强证据,却不是一张可以覆盖整个软件栈的保证书。
对 Rust 深度学习生态意味着什么
DenseCore 更有价值的部分,可能不是“Rust 能不能训练 GPT”,而是它把框架兼容性问题推进到了数值语义层。Rust 在内存安全、系统级性能和部署等方向有明确优势,但深度学习生态长期由 Python 主导,真正的难题是能否复用已有模型与训练代码,而不是单纯把一个算子写得更快。
一个能接住 PyTorch 风格代码的 Rust 框架,理论上可以降低部分基础设施的工程风险,也可能为嵌入式部署、服务端推理或更严格的资源管理提供不同选择。但要从实验走向工程使用,用户还会看算子覆盖、自动微分稳定性、设备支持、生态工具、文档、性能和维护节奏。当前材料没有提供这些指标,也没有 DenseCore 与 PyTorch 的训练速度对比,因此现在谈性能优势为时过早。
已有 Rust 与 nanoGPT 的尝试并不都指向重写整个训练框架。例如,impl Future 的系列文章介绍过 Rust 与 PyTorch 绑定的混合开发路线,先从文本预处理等局部任务入手,再探索如何把 Rust 集成进 Python 工作流。这条路线的工程风险更低:保留 PyTorch 的成熟训练栈,只把适合的部分交给 Rust 优化。DenseCore 所描述的目标更进一步,重点是复现框架级行为,让现有训练程序可以在另一个实现上运行。
这两种路线解决的问题不同。混合开发适合逐步优化已有项目, DenseCore 则在挑战“兼容 PyTorch 代码并匹配其数值结果”的边界。前者更容易落地,后者如果继续扩展并形成可重复的测试矩阵,才可能对框架设计和实验复现带来更直接的影响。现阶段,DenseCore 仍更像一个值得跟进的原型,而不是已经成熟的生产替代品。
接下来应看哪些验证
DenseCore 要证明自己不止能复现一个演示,需要公开足以独立重跑的证据。对开发者而言,最重要的不是项目介绍里的“完全一致”,而是每个结论能否映射到可执行测试:指定 PyTorch 版本、Rust 编译配置、CPU 型号或 GPU 型号,固定输入数据和随机数种子,并逐步比较张量结果。
后续验证可以重点关注以下方面:
- 扩大模型覆盖。 除 nanoGPT 外,测试包含不同归一化、卷积、注意力和嵌入算子的模型,识别兼容范围的边界。
- 延长训练过程。 从 50 步扩展到数百或数千步,并公开每一步的 loss、梯度和权重摘要,检验差异是否会在长序列中出现。
- 拆分 CPU 与 GPU 结果。 不把 CPU 上的复现结论外推到 GPU,也不把一种硬件上的结果外推到另一种硬件。
- 提供性能基准。 在相同硬件、数据和配置下比较吞吐量、单步耗时与内存占用,避免把数值兼容误读为性能提升。
- 明确接口覆盖。 列出支持的 Python API 和算子,对尚未实现或行为不一致的部分给出明确边界。
DenseCore 当前最扎实的看点,是把逐 bit 复现落实到一次完整的 nanoGPT 训练流程,而不只是声称“理论上兼容”。但它现在的证据仍然是窄范围的自测报告,距离通用、跨设备、可用于生产的 PyTorch 替代方案还有明显差距。对框架开发者来说,这个实验展示了兼容性工程中那些容易被忽略的细节;对普通训练用户来说,下一步更值得等的是公开代码、可重复的测试和性能数据。
参考来源
- Reddit:DenseCore 开发者的项目进展与 50 步测试描述。本文关于逐 bit 对齐、attention、Adam、梯度裁剪及跨环境观察的主要来源;相关结论属于发帖者自述。
- impl Future:Rust 与 PyTorch 混合开发 nanoGPT 系列。介绍以 PyTorch Rust 绑定和 Rust 文本预处理为起点的混合开发路线。