Claude追出26年曲线种子悬案
Anthropic于10月16日宣布,Claude不到30分钟追溯出五条NIST椭圆曲线的种子来源,并公开复现代码。成果补上了参数生成历史的一环,但不等于破解ECDSA,也不能据此断言所有后门疑虑已经消失。
Claude用不到30分钟,补上了一段密码学历史
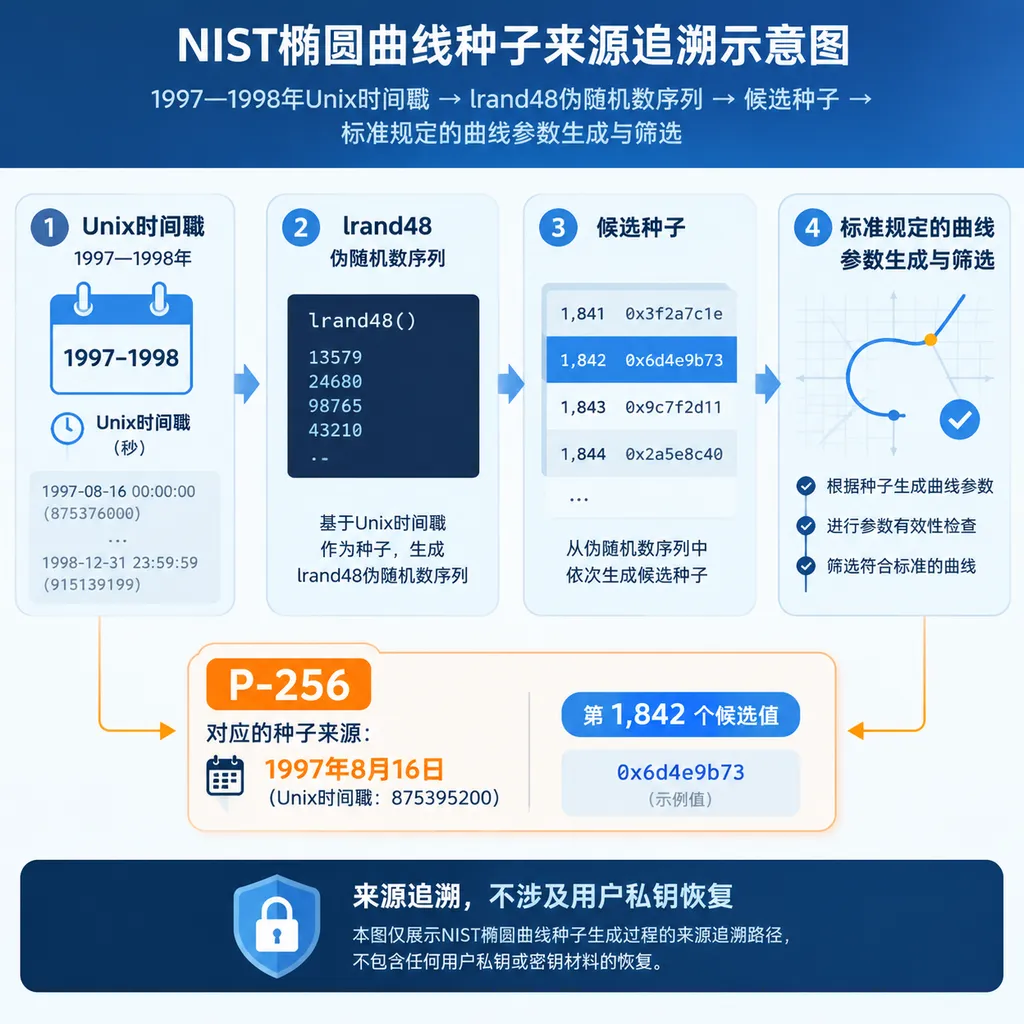
Anthropic于2026年10月16日公布了一项密码学研究:其内部研究使用的Claude模型,在不到30分钟内,追溯出五条NIST标准椭圆曲线的种子来源。据IT之家10月17日的报道,这些看起来毫无规律的数据,可以由C语言库中的伪随机数生成器lrand48产生,初始化输入则是1997年至1998年的Unix时间戳。
这项发现最值得关注的地方,是研究交付了一条可以重新运行的生成路径。按照Anthropic的介绍,团队已经公开复现代码;对于使用范围很广的P-256曲线,研究还将其标准种子追溯到1997年8月16日的一次生成过程,对应第1,842个候选值。一个长期停留在历史猜测层面的问题,因此获得了可以用程序核验的解释。
“26年悬案、半小时解开”很容易成为传播焦点,但这两个数字衡量的事情不同。26年指的是相关曲线在2000年进入美国数字签名标准后,这段来源历史长期没有得到公开解释;不到30分钟描述的是Anthropic报告的本次模型研究用时。它不能被直接换算成AI相对密码学家的研究效率,更不能说明过去26年一直有人持续投入同等资源求解。
这仍然是一项值得认真对待的成果。对于AI科研,能够拿出别人可以检查的生成过程,比给出一个听起来合理的历史故事更有价值。
悬案的核心:曲线参数能复算,起始数据却说不清
NIST是美国国家标准与技术研究院,其发布的密码标准影响着大量安全产品和软件实现。此次研究涉及的P-192、P-224、P-256、P-384和P-521,是五条定义在素数域上的标准椭圆曲线;名称中的数字对应其底层有限域素数的位数。
ECDSA是利用椭圆曲线数学结构生成和验证数字签名的算法。数字签名用于验证消息是否由相应私钥持有者签发,以及内容是否发生变化;它本身不负责把消息加密。在支持ECDSA的证书和认证系统中,标准曲线提供了签名双方共同采用的一组数学参数。
种子是按照既定规则生成曲线参数时使用的一段起始数据。它属于公开参数生成过程,不是用户创建钱包、账户或签名密钥时需要保管的秘密。拿到曲线种子,不意味着能够推算出使用这条曲线的用户私钥。
争议出在“为什么最初选了这段数据”。这些曲线的相关种子由美国国家安全局NSA提供,公开规则允许外界检查种子与相应曲线参数之间的关系,但种子自身的生成过程长期没有得到解释。外界能沿着已经公布的路线复算,却不知道路线的起点是如何选出来的。
可验证的参数推导过程,并不自动等于可解释的参数选择过程。假如设计者可以反复尝试大量种子,再只公布某个结果,审查者仍会关心:选择它的理由是什么,是否存在没有公开的筛选条件?这并不能证明设计者做了手脚,却足以构成一个持续存在的透明度问题。
此次研究推进的,正是这条信任链的上游。它尝试回答的不是“曲线能不能用于签名”,而是“当年生成这些公开常量的人,可能运行了什么程序”。
关键转向:把随机数当成旧软件留下的痕迹
Claude此次报告中的关键判断,是将调查方向转向20世纪90年代常见的软件工具。此前围绕种子来源的讨论,曾包括“对某些英语短语做哈希”等猜测;如果真正的来源是一个普通程序产生的数字序列,持续寻找有意义的原文就可能走错方向。
伪随机数生成器是通过内部状态和确定性规则,产生看起来随机的数字序列的程序。只要初始化方式、状态更新规则和输出处理方式相同,就可以重新生成同一条序列。对这类历史调查来说,输出中的规律可能成为识别软件实现的线索。
lrand48是采用48位内部状态的伪随机数生成函数,属于传统Unix及C语言开发环境中常见的一类工具。它适合说明此次发现为何可能发生:一串数字即使肉眼看不出规律,也可能保留了特定生成器的结构特征。识别这些特征,比直接枚举所有可能的种子更有针对性。
Unix时间戳是以1970年1月1日00:00:00 UTC为起点计算的时间值,常见形式以秒计数。用时间初始化伪随机数生成器,是历史软件中很常见的做法。对于今天的调查者,时间范围也构成了一项约束:如果目标数据来自某个时期,就可以围绕那段时期检验候选初始化输入。
据Anthropic介绍,Claude通过识别位模式、恢复生成器状态并进行反向推算,将五条曲线的种子生成时间定位到1997年至1998年。这里的技术价值在于,多条独立公布的标准种子能够被同一类历史软件机制解释,研究因此不必停留在单个常量的巧合匹配上。
P-256对应第1,842个候选值,是这次结果中尤其具体的证据。这个编号把模糊的“可能来自随机数程序”,变成了一个带位置的生成结果:复现者需要按照相应流程运行,才能在指定位置得到目标种子。
“第1,842个”仍然需要结合候选生成和筛选规则解读。它不能被直接翻译为“生成了1,842条可用曲线”,也不能单凭这个数字判断此前候选为何被跳过。序列位置是已经报告的结果,历史操作者的完整决策过程则是另一层问题。
五条曲线找到了共同线索,所有细节尚未闭合
此次研究覆盖的是五条素数域曲线的种子来源,不能扩展成所有NIST椭圆曲线参数都已得到解释。根据已披露的信息,结果可以整理如下:
| 曲线 | 此次报告的种子来源 | 已披露的时间信息 | 阅读结果时需要注意的边界 |
| --- | --- | --- | --- |
| P-192 | 由Unix时间戳初始化的lrand48生成过程 | 1997年至1998年范围内 | 来源得到解释,不代表适合今天的新系统选型 |
| P-224 | 由Unix时间戳初始化的lrand48生成过程 | 1997年至1998年范围内 | 仍需区分种子来源与完整参数选择历史 |
| P-256 | 由Unix时间戳初始化的lrand48生成过程 | 1997年8月16日,第1,842个候选值 | 候选位置本身不能解释全部跳过原因 |
| P-384 | 由Unix时间戳初始化的lrand48生成过程 | 1997年至1998年范围内 | 不能据此推断所有相关参数都使用相同流程 |
| P-521 | 由Unix时间戳初始化的lrand48生成过程 | 1997年至1998年范围内 | 不能据此推断所有相关参数都使用相同流程 |
B-163种子的来源仍在未解释事项之列。B-163是定义在二元域上的另一条标准曲线,与本次表格中的五条素数域曲线不同;此外,部分曲线基点的生成方式,以及为什么跳过某些可用候选曲线,也没有因这次结果而全部得到回答。
基点是椭圆曲线密码运算中预先选定、供各方共同使用的一个点。曲线方程相关参数的生成历史,与基点的选择历史彼此相关,却不是同一个问题。追出种子来源,意味着一块重要拼图被补上,不能代替对其余参数和选择过程的说明。
可复现程序能够证明某套流程确实生成了这些公开数据,但对历史的判断还需要区分不同强度的证据。“这段程序能够重现结果”可以直接通过运行验证;“当年的操作者就是这样做的”,则还要结合时间、工具环境、文档或其他历史材料评估。大量细节吻合会增强解释的可信度,但两种命题不应混写。
为什么普通随机数工具,没有让ECDSA突然失效
曲线公开参数的生成种子,与签名过程中必须保密的随机量,承担着完全不同的角色。此次发现涉及前者。一个原本就会被公布、并允许外界复算的种子,并不需要像私钥那样保密。
签名随机数的质量则直接关系到私钥安全。ECDSA每次签名使用的秘密标量通常称为nonce;如果它被重复使用、泄露,或存在某些可利用的偏差,就可能危及私钥。不能因为历史曲线参数的生成过程涉及lrand48,就把同样的判断搬到签名实现中,认为它适合产生私钥或签名nonce。
此次研究没有报告ECDSA私钥恢复方法,也没有提出针对这些曲线的新攻击。按照Anthropic的说明,用户不需要因此采取措施。对开发者而言,这条消息不构成紧急更换证书、迁移曲线或修改签名实现的理由。
新的来源解释能够降低一部分关于参数被刻意挑选的疑虑,但不能被写成“已经证明绝无后门”。从普通历史软件流程中重现标准种子,使“这些常量来自某种常见生成过程”的解释更有证据;是否存在未公开的筛选条件、其他参数如何确定,仍要分别讨论。
这也是评价密码学新闻时必须保留的分寸。来源透明度增加,是实质进展;算法安全性的全面证明,则远远超出一次历史追溯能够提供的结论。
AI科研的交付物,应该是别人能检查的结果
这项工作的启发,是Claude把假设搜索、编程验证和证据整理连接成了一个短周期。数字资料并不会因为保存下来就自动变成答案,研究者仍要决定该查哪些工具、哪些生成器值得尝试、一次失败意味着什么。模型在这里承担的是探索和验证之间的衔接工作。
不到30分钟不能代表完整研究成本。模型研究过程的用时、人工准备、计算资源、结果复核和发布整理是不同指标;现有参考材料没有给出足以计算完整成本的细项,也不足以据此比较不同商业模型的密码学研究性价比。对开发者而言,把它视作一项具体任务上的能力展示,比把它当作通用科研排行榜更有用。
可复现的密码学考古,至少需要交付四类材料:
- 明确的目标数据:具体在解释哪条曲线、哪段种子,目标值来自哪个标准版本。
- 完整的生成条件:采用什么生成器、怎样初始化,以及输出如何转换成候选数据。
- 可以核对的中间结果:时间范围、候选位置和匹配过程,让复现者能定位分歧。
- 清楚的结论边界:哪些数据已匹配,哪些筛选理由和历史细节仍然未知。
公开代码的意义,是让验证尽量摆脱对模型叙述的依赖。Claude负责提出和组织解释,其他人可以通过运行程序、比对标准常量来检查解释是否成立。研究质量因此可以围绕输入、步骤和输出展开讨论,而不必依赖“模型说得是否可信”。
这种工作方式也适用于密码学之外的旧系统调查。遗留格式里的神秘常量、缺少文档的数据处理流程、历史软件产生的异常序列,都可能需要同时理解旧工具和验证新假设。AI的实际价值,是让更多曾经因整理成本过高而搁置的问题,获得一次可执行的调查。
截至2026年10月17日,这项结果最扎实的意义,是五条NIST曲线种子的来源多了一套具体、可检验的解释。下一步真正值得关注的,是独立复现能否确认这些结果,以及尚未闭合的参数选择细节能否得到进一步说明。对于AI科研,这比再出现一个更短的完成时间更能增加可信度。
参考来源
- IT之家:Claude当起“数字考古学家”,不到30分钟追溯NIST椭圆曲线种子来源:2026年10月17日报道,转述Anthropic于10月16日公布的研究,包含五条曲线、
lrand48、P-256候选位置、复现代码公开情况及尚未解释的问题。本文对研究结果的介绍依据该报道及题目所附资料;Anthropic官方研究和Filippo Valsorda的悬赏进展文章因链接域名限制,未在此列出外链。