Llmspeed:显卡先试后买
Llmspeed 把本地大模型的预估生成速度变成可直接感受的逐字输出,帮助用户在购买显卡或 AI 主机前判断模型是否装得下、跑得动、用起来够不够快。
买硬件之前,先把模型“跑”一遍
近日上线的 Llmspeed,试图解决本地大模型玩家最容易花冤枉钱的问题:一台机器能装下模型,不等于它能以可接受的速度运行模型。用户选择目标模型和硬件配置后,Llmspeed 会把预估的 token 生成速度转化为直观的文本输出体验,让人不用先买下显卡或 AI 主机,也能大致感受模型回答时究竟是流畅输出,还是几秒才蹦出一个词。
**Llmspeed 是一个本地 LLM 推理速度预估与体验工具。**它的价值不是再做一张硬件排行榜,而是把抽象的“每秒 12 token”翻译成肉眼可以判断的交互节奏。
这款工具切中的问题很具体:硬件评测通常告诉用户显卡有多少 TFLOPS、内存带宽是多少,模型页面则告诉用户参数量和量化格式,但这些数字很难直接回答“用它写代码会不会等得烦”“跑 70B 模型能不能正常对话”。Llmspeed 把决策向最终体验推进了一步。
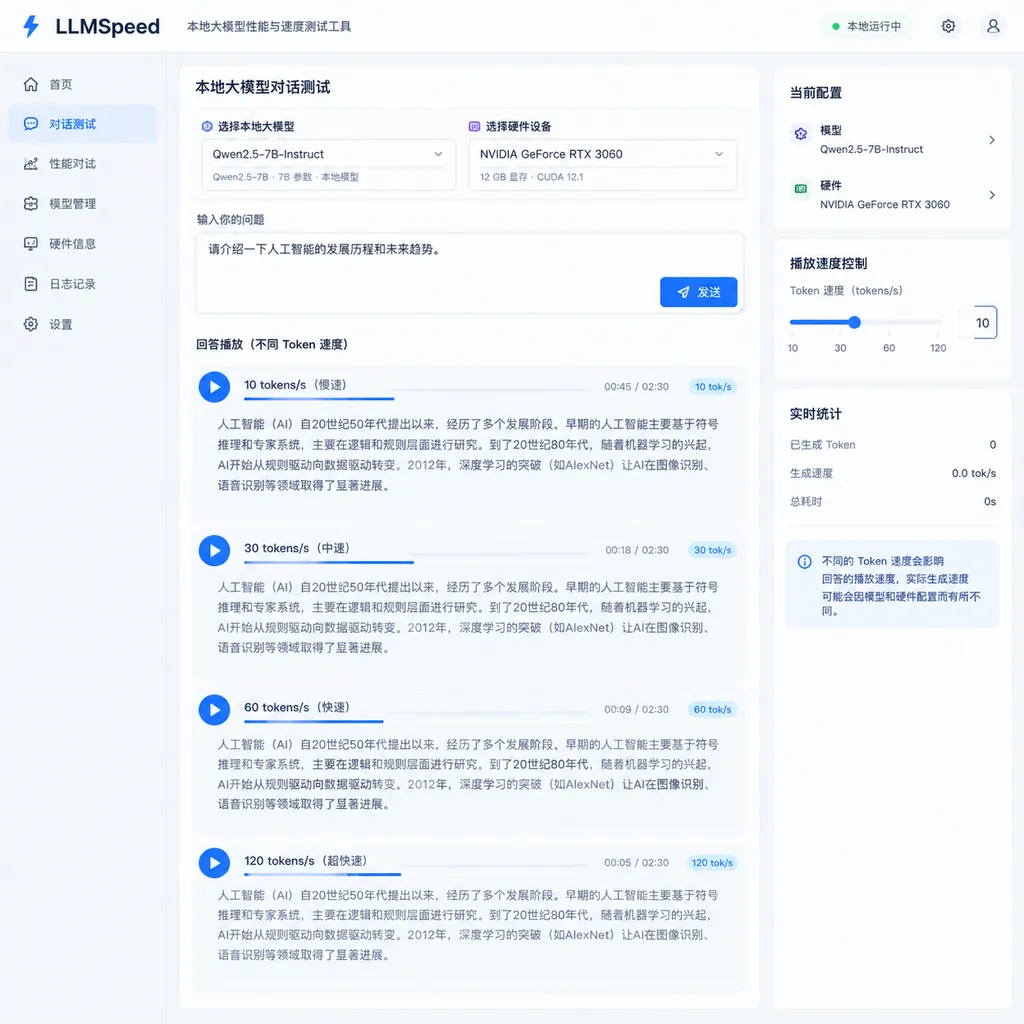
Llmspeed 目前更适合被视为购买前的筛选器,而不是严谨的实验室基准测试。它可以帮助用户迅速排除明显不合适的组合,却不能代替在目标设备上运行 llama.cpp、Ollama 或 LM Studio 得到的真实结果。推理框架版本、量化格式、上下文长度、GPU 卸载层数乃至散热状态,都可能让同一套硬件出现不同成绩。
先分清“装得下”和“跑得快”
**模型容量是指加载模型权重和运行时缓存所需的内存或显存空间。**一个 7B 模型使用 FP16 权重时,单是参数就约占 14GB;70B 模型约占 140GB,这还没有算 KV Cache、运行时缓冲区和图形界面本身的开销。
**量化是用更低数值精度保存模型权重,以换取更低内存占用和更快推理的技术。**从 FP16 降到 4 bit 后,70B 模型的纯权重理论值可从约 140GB 降至 35GB,但 GGUF 文件结构、量化分组信息和运行时缓存会继续占用空间。因此,看到一台机器有 36GB 或 40GB 内存,并不能直接得出它能稳定运行 70B Q4 模型的结论。
**内存带宽是处理器每秒能够从内存读取或写入的数据量。**本地 LLM 在逐 token 解码时需要反复读取大部分模型权重,小批量推理往往受内存带宽限制,而不是受宣传页上的峰值算力限制。
这也是 Llmspeed 值得存在的原因:消费电子市场习惯突出 TOPS、核心数和统一内存容量,但本地模型用户真正感受到的是首字等待时间和持续生成速度。容量决定模型能否启动,带宽和运行时效率才更多决定模型启动后是否好用。
以两台都可配置 128GB 统一内存的设备为例,公开规格显示,Apple M4 Max 的内存带宽最高为 546GB/s,而 NVIDIA DGX Spark 为 273GB/s。两者都可能容纳同一个量化模型,但仅从带宽看,逐 token 解码的理论上限就不会相同。当然,实际结果还会受到芯片架构、内核优化、模型格式和软件栈影响,不能只用带宽数字直接宣布胜负。
Llmspeed 应该怎么用
第一步:先固定模型版本
**模型名称不足以唯一确定本地推理负载。**同一个模型可能同时存在 FP16、Q8、Q6、Q5、Q4 乃至更激进的量化版本,其文件大小、输出质量和生成速度差异明显。
在 Llmspeed 中比较硬件前,应先确定以下条件:
- 参数规模,例如 7B、14B、32B 或 70B;
- 权重格式,例如 GGUF、MLX 或其他运行时支持的格式;
- 量化等级,例如 Q4_K_M、Q5_K_M 或 Q8_0;
- 目标上下文长度,例如 8K、32K 或更长;
- 使用场景,例如单人聊天、代码补全、文档总结或多用户服务。
模型规模选错一档,结论就可能完全失效。32B Q4 与 70B Q4 不是“慢一点”的区别,而可能是从单卡完整加载变成 CPU 与 GPU 淞合计算,生成速度随之出现断崖式变化。
第二步:检查容量余量
**可用容量余量是模型加载后留给 KV Cache、系统和其他应用的内存空间。**购买硬件时不应把模型文件大小与标称显存做一比一匹配,实际配置至少要为运行时开销留出空间。
一个实用的粗略算法是:先用参数量乘以每个参数的字节数,再额外预留 10% 至 30% 的运行空间。4 bit 权重理论上约为每参数 0.5 字节,8 bit 约为 1 字节,FP16/BF16 约为 2 字节;但这只是第一轮筛选,不能代替具体模型文件的实际大小。
KV Cache 还会随上下文长度增长。短对话能正常运行的配置,放入数万 token 的代码仓库或长文档后,可能开始占用系统内存,甚至触发交换空间。交换空间可以避免程序立即崩溃,却通常会让交互速度跌到难以使用。
第三步:用输出动画判断“够不够快”
**Token 生成速度是模型在解码阶段每秒输出的 token 数量,通常写作 tok/s。**它是本地聊天最直观的性能指标,但 token 不等于汉字,也不固定等于一个英文单词,因此不能机械换算成每秒字数。
对单人交互而言,可以用下面这组经验区间理解 Llmspeed 展示的速度:
| 持续生成速度 | 主观体验 | 更适合的场景 | |---|---|---| | 低于 5 tok/s | 等待感明显,长回答较煎熬 | 离线批处理、偶尔验证大模型能力 | | 5-10 tok/s | 可以使用,但不算流畅 | 文档总结、低频问答 | | 10-20 tok/s | 接近多数人的可接受区间 | 日常聊天、辅助写作、轻量代码任务 | | 20-40 tok/s | 输出流畅,阅读通常跟不上生成 | 高频交互、代码补全、个人助手 | | 高于 40 tok/s | 响应感很强,继续提升的边际感知下降 | 低延迟工具调用、多轮智能体 |
这些区间是交互体验判断,不是模型质量排名。一个 70B 模型以 8 tok/s 输出,可能比一个 7B 模型以 50 tok/s 输出更准确;反过来,实时补全场景往往宁可使用更小、更快的模型,因为延迟本身就是产品质量的一部分。
第四步:不要把解码速度当成全部延迟
**首 token 延迟(TTFT)是从提交请求到收到第一个输出 token 的时间。**Llmspeed 最容易让用户感知的是回答开始后的持续速度,但实际等待还包括模型加载、提示词预填充和请求调度。
预填充与解码是两种不同负载。预填充阶段可以并行处理输入 token,通常更依赖计算能力;解码阶段一次生成一个 token,较小批量下通常更依赖内存带宽。一个模型可能输出阶段达到 25 tok/s,却因为要先读取 30K token 的代码上下文,让用户等待十几秒才看到第一个字。
长上下文用户因此不能只盯着 tok/s。代码仓库问答、论文分析和本地知识库应同时关注 TTFT、预填充速度、KV Cache 占用与上下文增长后的性能变化。Llmspeed 可以回答“开始输出后有多快”,却不一定完整回答“从点击发送到拿到完整答案要多久”。
它和真实基准测试有什么区别
**预测工具给出的是购买前的参考区间,真实基准测试测量的是指定软件与硬件组合的实际结果。**两者并不互相替代,正确顺序应当是先用 Llmspeed 缩小候选范围,再寻找同配置实测,最后在可退换或可租用的设备上复测自己的工作负载。
| 方法 | 是否需要目标硬件 | 能看到什么 | 看不到什么 | 适用阶段 | |---|---:|---|---|---| | Llmspeed | 否 | 预估输出节奏、硬件与模型组合是否合理 | 本机驱动、散热、具体量化文件影响 | 购买前初筛 | | llama.cpp benchmark | 是 | 提示处理与 token 生成实测、线程及 GPU 卸载效果 | 图形界面的完整交互体验 | 硬件验证与调优 | | Ollama 实际请求 | 是 | 真实模型加载、提示处理和生成耗时 | 跨设备统一比较较麻烦 | 日常工作流复测 | | LM Studio | 是 | 图形化加载、显存分配和聊天体验 | 结果依赖其运行时版本与设置 | 桌面用户调试 | | 厂商峰值算力 | 否 | 芯片理论计算能力 | 模型能否装下、软件效率、实际 tok/s | 只能做辅助参考 |
Llmspeed 相比单纯跑分网站更贴近普通开发者的购买决策,因为它展示的是等待感,而不只是排名。不过,它也比真实基准更容易隐藏前提:同名硬件可能有不同功耗版本,同一模型可能采用不同量化,不同 llama.cpp 提交版本也可能改变性能。
三类用户最值得先用它排雷
**准备购买大显存消费级显卡的用户最适合用 Llmspeed 做第一轮筛选。**这类用户经常在 24GB 显存的高端显卡、双显卡方案和大内存 CPU 方案之间犹豫,预估工具能够先暴露“模型根本无法完整放入显存”或者“能运行但速度远低于预期”的组合。
**准备购买大内存 Mac 的用户需要同时权衡统一内存容量和带宽。**Apple Silicon 的优势是 CPU 与 GPU 共享统一内存,较大的量化模型不必被单张独立显卡的显存容量卡死;它的限制则是扩展能力弱,配置一旦购买便很难升级。先确认 32B 或 70B 模型的预估体验,比只按内存容量下单更有意义。
**准备购买紧凑型 AI 主机的用户尤其不能只看 TOPS。**NPU TOPS 常用于描述低精度矩阵运算的理论能力,但许多桌面 LLM 运行时主要使用 GPU 或 CPU,未必能充分调用 NPU。产品写着“每秒多少万亿次运算”,不代表 llama.cpp 中就会得到同等比例的 token 速度。
预估之后,还要做一次自己的测试
**可靠的购买决策必须使用接近真实工作的提示词和上下文。**公开跑分常用很短的提示和固定输出长度,这与把 20K token 项目代码交给模型分析不是同一种负载。
拿到候选设备后,可以按以下流程复测:
- 安装计划长期使用的运行时版本,不要混用不同后端的成绩。
- 下载与预估时完全一致的模型和量化文件。
- 分别测试短提示、8K 上下文和目标最大上下文。
- 记录模型加载时间、TTFT、提示处理速度、生成速度和峰值内存。
- 连续运行多个请求,观察温度、功耗与降频,而不是只记第一次成绩。
- 在后台保留日常会开启的浏览器、IDE 和容器,再测试一次内存压力。
持续生成速度还应与输出质量一起评估。更激进的量化可能减少内存并提高速度,但也可能损伤代码、数学和长上下文任务表现;为了从 18 tok/s 提升到 23 tok/s 而降低答案可靠性,未必是一笔划算的交换。
Llmspeed 的意义,是把参数表拉回体验
**Llmspeed 最有用的地方,是让本地 LLM 硬件采购从“能不能运行”转向“是否值得每天使用”。**它没有消除基准测试的复杂性,却为非实验室用户提供了一个更容易理解的入口。
这类工具也有清晰的边界。它不能预测每一次软件升级带来的变化,不能覆盖所有模型量化组合,也不能代表多用户并发下的吞吐表现;如果目标是部署生产服务,还要继续测试批处理、前缀缓存、请求队列、GPU 利用率和 p95 延迟。
对个人开发者来说,Llmspeed 已经足以拦住最常见的错误决策:为了运行某个参数规模购买昂贵硬件,最后才发现模型虽然加载成功,输出速度却无法支撑日常交互。先用它判断体验区间,再看同配置实测,最后用自己的任务验证,这比追逐一张脱离上下文的跑分榜可靠得多。
参考来源
- llama.cpp GitHub 仓库:消费级 CPU、GPU 与 Apple Silicon 上常用的本地 LLM 推理运行时,可用于实际性能复测。
- Ollama GitHub 仓库:本地模型运行与管理工具,可用于验证模型加载、提示处理和生成速度。
- Hugging Face 模型内存估算指南:说明模型权重精度、参数规模与加载内存之间的关系。
- Hugging Face Transformers 量化文档:介绍低比特量化及其对模型内存和推理的影响。
- 大语言模型推理加速:硬件视角的全面解析:从计算、内存和硬件架构角度讨论 LLM 推理瓶颈。