RFdiffusion3:AI开始逐原子设计生命
RFdiffusion3将蛋白质生成从“搭骨架”推进到全原子相互作用设计,并用DNA结合蛋白与功能性酶完成实验验证。它还不是自动造药机,却已经跨过了生成式生物设计最关键的一道门槛。
RFdiffusion3正式登上《科学》,蛋白质设计进入全原子阶段
RFdiffusion3(简称 RFD3)是一套面向全原子生物分子相互作用设计的生成式 AI 系统,它能在配体、核酸和催化位点等条件约束下,从头生成新的蛋白质三维结构。
当地时间 2026 年 10 月 16 日,由美国华盛顿大学蛋白质设计研究所、英国牛津大学、英伟达等机构参与的研究团队,在《科学》正式发表了 RFdiffusion3 的详细研究成果。团队此前已于 2025 年公开预印本,并在同年 12 月开放相关代码;此次正式论文补齐了模型方法、计算基准与湿实验结果,也让外界得以更准确地判断这套系统究竟解决了什么问题。
答案不是“蛋白质生成速度又快了一点”,而是蛋白质设计的操作对象发生了变化:过去的主流生成模型更像先搭出建筑的承重结构,RFdiffusion3 则开始同时考虑门窗、管线和接口的位置,也就是直接处理决定分子功能的原子级几何关系。
根据研究团队披露的结果,RFdiffusion3 在 41 个酶活性位点基准中的 37 项优于上一代方法,生成速度约为前代系统的 10 倍。更重要的是,部分设计已经走出计算机:研究人员在实验中验证了 DNA 结合蛋白和具有催化活性的酶,包括可水解有机磷化合物对氧磷的酶,以及可切割与转甲状腺素蛋白淀粉样变性相关肽段的蛋白酶。
从预测结构到反向设计功能
蛋白质结构预测是根据氨基酸序列推断其三维形态,而蛋白质从头设计是从目标结构或功能出发,反向创造自然界中未必存在的新结构与新序列。
这一区别决定了两类系统的难度并不相同。结构预测面对的是“给定序列,它会折叠成什么样”;生成式设计面对的则是“我需要一种能抓住特定 DNA、容纳某个小分子或催化某种反应的蛋白质,应该造出什么结构”。后者不仅要给出几何上合理的答案,还要让设计能够被编码为氨基酸序列、稳定折叠,并在真实实验环境中执行指定功能。
David Baker 团队此前开发的 RoseTTAFold 属于结构预测系统,它通过学习氨基酸序列、残基间距离和三维坐标之间的关系预测蛋白质结构。2023 年发表的第一代 RFdiffusion 则把 RoseTTAFold 的结构网络改造成扩散生成模型:训练时向蛋白质结构逐步加入噪声,推理时学习逆转这一过程,从随机状态中“去噪”出合理的新骨架。
第一代 RFdiffusion 已经能生成单体、对称组装体、蛋白质结合剂和纳米材料,但它主要在氨基酸残基及蛋白质骨架层面工作。对于只要求整体形状的任务,这种表示已经很有效;对于酶催化、小分子识别和蛋白质—核酸结合,它却不够细。
问题在于,真正发生化学作用的不是抽象的氨基酸方块,而是侧链末端的氧、氮、硫等具体原子。一个氢键的方向偏了,一组催化残基的间距多出几埃,或者结合口袋里某个侧链转向不对,外形看起来正确的蛋白质就可能完全没有活性。
RFD3的核心变化:直接生成每个原子的坐标
全原子生成是指模型显式表示蛋白质主链、侧链以及相关非蛋白质分子的原子,并直接生成或调整这些原子的三维坐标。
RFdiffusion3 借鉴了 AlphaFold 3 的原子级扩散思路,对每个氨基酸最多使用 14 个原子进行表示,不再只把一个残基压缩成少数骨架坐标。配体、DNA、RNA、金属离子或催化基团也能进入同一套空间表示,使模型可以同时推理“蛋白质长什么样”和“它应当怎样接触另一个分子”。
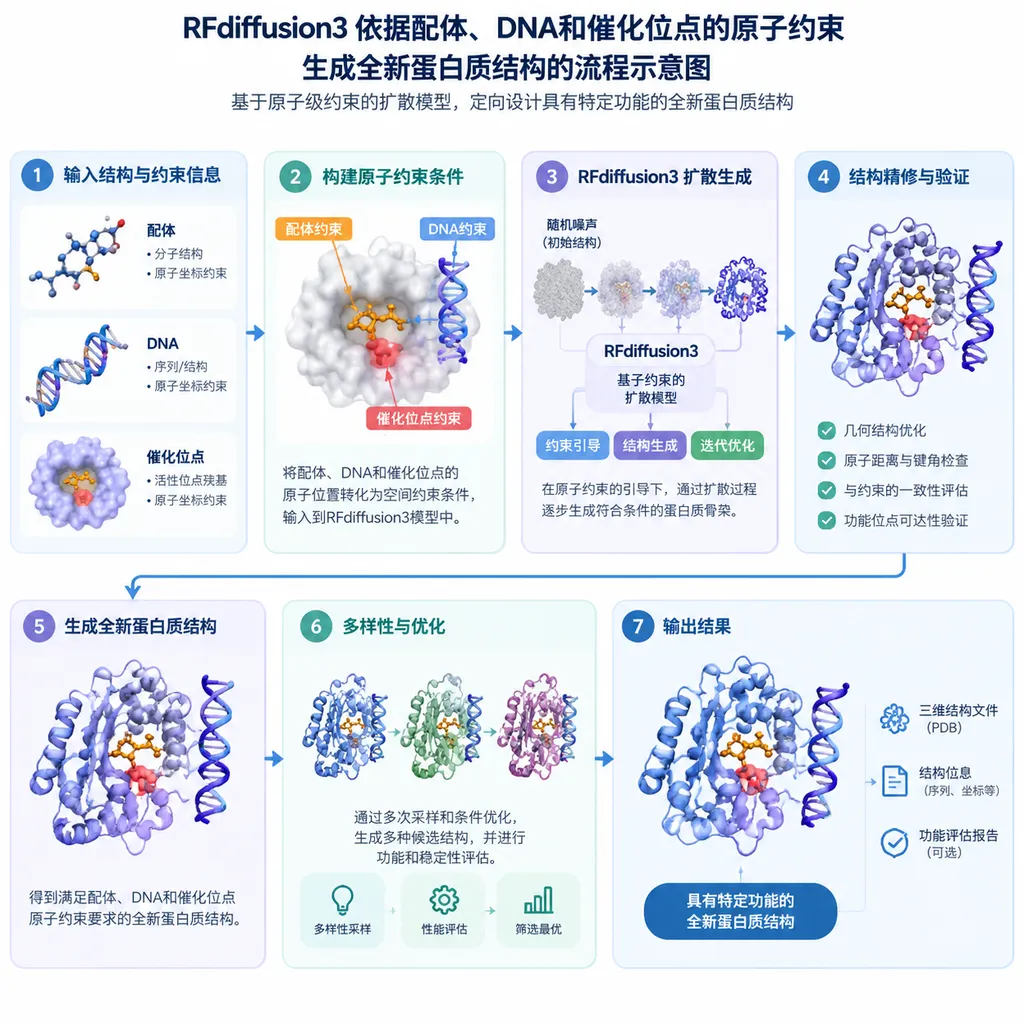
这一变化听起来像是提高分辨率,实际上改变了模型能够接收的设计条件。研究人员不只能固定若干功能原子的位置,还可以进一步指定氢键供体与受体的配对关系、作用距离、方向,以及某些原子应当暴露在溶剂中还是埋藏于蛋白质内部。模型随后围绕这些约束生成完整结构。
例如,设计一个结合 DNA 的蛋白质,不再只是要求它形成一块能贴近双螺旋的表面。研究人员可以给出 DNA 原子作为上下文,让模型安排蛋白质侧链,使带正电或可形成氢键的原子朝向特定磷酸基团或碱基。设计一个酶时,也可以先固定完成反应所需的催化原子,再让 RFD3 生成支撑这些原子的整体折叠和周边相互作用网络。
RFdiffusion3 使用 Transformer U-Net 处理这些多尺度信息。Transformer 负责让相距较远的原子与残基交换信息,U-Net 式结构则在不同分辨率之间压缩和恢复特征,以兼顾蛋白质整体拓扑与局部原子几何。团队还采用统一的原子表示来处理不同氨基酸拥有不同侧链原子数的问题,将模型规模控制在约 1.68 亿参数。
参数量并不是 RFD3 最值得强调的指标。生物分子生成的瓶颈往往不是模型能否装进显存,而是每轮设计需要采样多少候选、后续还要经过多少次序列设计、结构预测、能量筛选和实验验证。研究团队报告 RFD3 的生成速度约为前代方法的 10 倍,意味着同等计算预算下可以探索更大的候选空间,这对低成功率的湿实验筛选尤其实际。
三代RFdiffusion,差别不只是版本号
RFdiffusion2 是面向功能位点支架化的生成模型,它允许围绕少量关键侧链原子生成蛋白质骨架;RFdiffusion3 则把扩散过程本身推进到统一的全原子表示。
RFD2 已经能够接收酶活性位点的原子级条件,但生成主体仍偏向氨基酸与骨架层级。它可以把预先给定的催化残基安放进新支架,却较难在生成过程中继续创造与配体或催化残基配合的完整侧链网络。RFD3 的优势正是在这里:侧链不再只是后处理补上的细节,而是生成过程的一部分。
| 系统 | 主要表示层级 | 可处理的设计对象 | 原子级条件能力 | 公开结果中的代表进展 | |---|---|---|---|---| | RFdiffusion(RFD1) | 氨基酸残基与蛋白质骨架 | 单体、组装体、蛋白质结合剂、纳米结构 | 有限,侧重整体结构 | 将扩散模型引入通用蛋白质骨架生成 | | RFdiffusion2(RFD2) | 骨架生成加关键侧链原子条件 | 酶活性位点支架、配体相关结构 | 可固定少量功能原子,但生成主体仍非全原子 | 在 41 类活性位点任务中展示通用支架化能力 | | RFdiffusion3(RFD3) | 蛋白质与上下文分子的全原子表示 | 酶、DNA结合蛋白、配体和核酸相互作用 | 可约束位置、氢键、方向与埋藏程度 | 41 项基准中 37 项优于前代,生成约快 10 倍,并获得湿实验功能验证 | | AlphaFold 3 | 全原子结构预测 | 蛋白质、核酸、配体等复合物 | 预测给定分子的复合物结构,不以从头功能设计为主要目标 | 提升多类生物分子复合物的结构预测能力 |
RFD3 与 AlphaFold 3 也不是直接替代关系。AlphaFold 3 的核心问题是预测给定分子会形成怎样的结构与相互作用;RFD3 的核心问题是根据指定的原子环境创造一个新的蛋白质。前者像评估一把已经画好图纸的钥匙能否插入锁孔,后者则试图根据锁孔直接生成一把新钥匙。
37比4更重要,但计算基准仍不是最终答案
在 41 个酶活性位点设计任务中,RFdiffusion3 有 37 项优于 RFdiffusion2,这说明全原子建模在大多数测试条件下带来了稳定收益,而非只对个别案例有效。
这类基准通常会考察生成结构能否满足催化原子的几何约束、能否形成合理折叠,以及经过序列设计后能否被独立结构预测模型高置信度地“折回”目标构象。它们适合比较模型,但不能直接等同于 37 种酶已经在试管里工作。
计算成功与实验成功之间仍隔着多道筛选。候选蛋白质首先要能被合成和表达,其次要保持可溶与稳定,再次要真正结合底物,最后还要达到可测量的催化速度和选择性。结构预测模型认为一个设计“可折叠”,并不保证它能降低化学反应的活化能。
因此,RFD3 最硬的结果不是排行榜,而是功能性设计通过了湿实验。团队展示的 DNA 结合蛋白拥有新的结构与序列,却能够识别目标核酸;设计出的半胱氨酸水解酶则证明,模型生成的原子排列可以转化为真实催化作用。
对氧磷水解任务尤其具有代表性。对氧磷是一类有毒有机磷化合物,水解它要求催化残基、底物与水分子形成精确的空间关系。RFD3 能围绕反应所需原子构建完整蛋白质,说明它处理的不只是静态“贴合”,而是与化学反应相关的几何条件。
针对转甲状腺素蛋白淀粉样变性相关肽段的蛋白酶设计,则展示了另一类潜力:让生成蛋白识别并切割特定肽键。需要强调的是,这仍属于早期实验验证,距离药物还要经过活性优化、脱靶评估、免疫原性、药代动力学、动物实验和临床试验,不能把“在实验中切开目标肽段”直接写成“可以治疗疾病”。
为什么全原子设计会扩大可做任务的边界
蛋白质功能本质上由原子之间的物理化学作用实现,全原子模型因此更接近药物发现、生物催化和基因调控中的真实问题。
第一类直接受益任务是酶设计。工业酶和环境治理酶往往需要催化天然蛋白质从未处理过的反应,传统路线通常从已知酶出发反复做定向进化。RFD3 提供的是另一条起点:先定义过渡态或关键功能原子的几何关系,再从头生成支撑它们的蛋白质。
第二类任务是小分子结合。药物靶点周围的结合口袋高度依赖侧链方向、疏水形状和氢键网络,只生成骨架很难保证这些细节同时成立。全原子扩散可以在配体已经存在的上下文中生成蛋白质,让口袋与目标小分子共同进入设计过程。
第三类任务是核酸识别。DNA 与 RNA 表面带有规则但密集的电荷和氢键位点,识别特定序列还需要区分碱基边缘的细微差别。RFD3 已用 DNA 结合蛋白证明其基本能力,未来可能被用于构建转录调控工具、分子诊断元件和新型基因编辑组件。
第四类任务是多组分生物材料。蛋白质如果能按指定方向连接金属、配体或核酸,就可能形成传感器、催化材料和可编程组装体。RFD3 的统一原子表示使这些任务不必为每一类分子单独设计一套生成框架。
真正的限制:模型会画结构,不等于理解全部化学
RFdiffusion3 的主要局限是它仍以静态三维结构为核心,而现实中的蛋白质和底物始终处于动态、溶剂化和热涨落环境中。
酶催化并非把几个原子摆到正确位置就结束。质子转移路径、电子效应、过渡态稳定、局部柔性、水分子网络和构象变化都会影响活性。全原子表示让模型看见了更多细节,但“看见所有原子”不等于完成量子化学计算,更不等于准确预测反应速率。
训练数据也是一项约束。公开结构数据库对稳定、易结晶和研究充分的蛋白质存在偏好,短寿命中间态、膜环境与复杂细胞条件则明显不足。模型可以在已知结构规律附近组合出新设计,却未必能可靠覆盖训练分布之外的化学空间。
实验吞吐量仍然决定技术落地速度。生成 1 万个候选可能只需计算资源,但合成、表达、纯化和测试 1 万个蛋白质仍然昂贵。RFD3 将计算生成提速约 10 倍后,实验验证反而更容易成为整个流程的新瓶颈。
安全治理也不能等到模型更成熟再讨论。能够设计核酸结合蛋白和高活性酶的系统同时具有双重用途,开放代码有利于复现与药物研究,也降低了高水平分子设计的使用门槛。合理的方向不是夸大风险或封锁基础研究,而是对高风险功能设计建立数据筛查、序列审查、实验分级和可追溯机制。
判断:这不是“AI造药完成”,而是设计接口变了
RFdiffusion3 最重要的意义,是把生成式蛋白质设计的输入接口从“我要一个大致形状”升级为“我要这些原子以特定方式发生作用”。
这一变化比单纯提高结构生成跑分更接近实际科研需求。研究人员真正关心的通常不是造出一个漂亮的新折叠,而是让它结合某个分子、催化某个反应或识别一段核酸。RFD3 把这些目标转换成可输入模型的原子约束,并证明其中一部分能够穿过实验验证。
但 RFD3 目前更像高水平分子设计人员的候选生成器,而不是端到端的自动药物发明系统。它可以显著缩小搜索空间、提高进入实验环节的设计质量,却没有取消序列优化、生化测定和安全验证,也没有解决临床开发的漫长链条。
截至 2026 年 10 月 19 日,最值得关注的信号已经很清楚:生成式 AI 在生物设计中的竞争焦点,正在从“能否生成像蛋白质的结构”转向“能否生成在真实环境中完成指定功能的分子”。RFdiffusion3 给出了目前最有说服力的一批答案,而接下来的胜负将由实验成功率、催化效率、选择性和可制造性决定,不再只由模型结构或计算跑分决定。
参考来源
- IT之家:AI系统 RFdiffusion3 能从原子层面设计蛋白质,可在实验中实现预期功能:报道正式论文发表时间、参与机构、全原子设计方法及主要实验结果。
- GitHub:RFdiffusion 项目:David Baker 团队 RFdiffusion 系列的公开代码与使用说明,可用于了解该技术路线的基础实现。
- Hugging Face:RFdiffusion 相关模型与社区资源:汇集可公开检索的模型资料与社区实现,适合追踪后续权重和工具生态更新。