不微调,音乐模型也能实时合奏
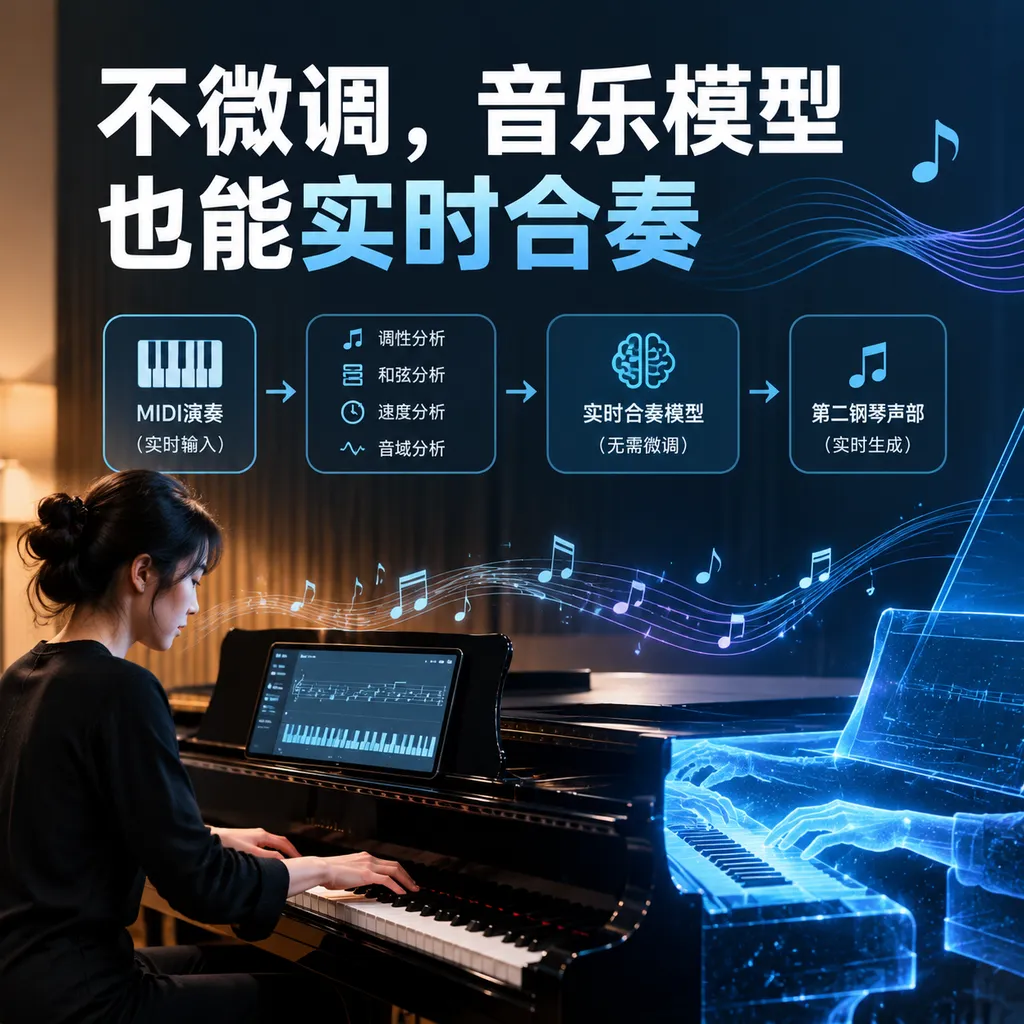
开发者让一款3.6亿参数的预训练音乐Transformer实时跟随MIDI键盘演奏,仅靠修改采样概率,不微调模型。原型已能识别调性、和弦与速度,并在Jetson Orin Nano上运行。
预训练模型第一次像乐手一样“看手势”
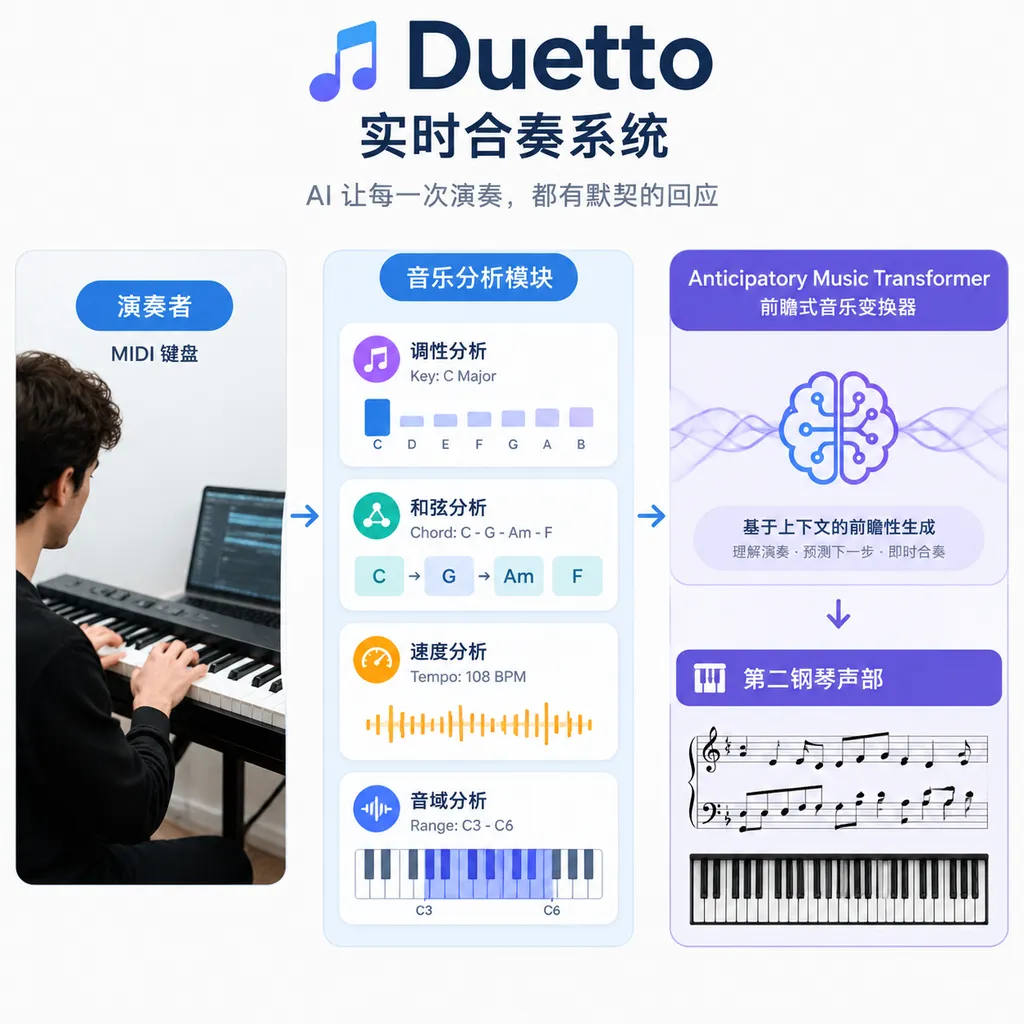
近日,一名开发者公开了名为 Duetto 的实时合奏原型:演奏者弹奏 MIDI 键盘,预训练的 Anticipatory Music Transformer 负责生成第二个钢琴声部,整个过程不需要微调模型,也没有重新训练任何参数。
Duetto 是一个通过实时修改采样概率,让预训练符号音乐模型跟随现场演奏的实验系统。它会持续追踪演奏者当前的调性、和弦、速度和手部音域,再把这些信息转换为对模型 logits 的加减分,决定下一个音符更可能或更不可能被采样。
这项实验最值得关注的地方,不是模型会“自动伴奏”——类似功能早已存在——而是开发者把实时交互问题放到了推理阶段解决。模型的权重保持冻结,现场控制则由一层足够轻量的采样策略完成,因此它可以跑在 Jetson Orin Nano 这样的边缘设备上。
根据开发者在 Reddit 技术帖 中披露的信息,系统使用的是 Thickstun 等人发布的 music-medium-800k 检查点。该模型拥有约 3.6 亿参数,在 Lakh MIDI 数据集上训练了 80 万步,原始设计目标是处理带有异步控制信息的符号音乐生成与局部重写。
它不是在听音频,而是在读取 MIDI 事件
Duetto 当前处理的是符号音乐,而不是麦克风中的原始声音。符号音乐模型是以音符、力度、时值和时间位置等离散事件为主要输入输出的生成模型;它面对的更像一份实时变化的电子乐谱,而不是连续声波。
这个边界非常重要。MIDI 键盘可以直接告诉系统哪个键被按下、何时松开以及力度是多少,因此 Duetto 不需要先完成音高检测、节拍追踪、声源分离和音频转录。换句话说,它绕开了实时音频合奏中最容易制造延迟和错误的一段链路。
系统的基本工作流可以概括为四步:
- 接收演奏者的 MIDI note-on、note-off 和时间信息;
- 根据近期音符估计调性、当前和弦、速度以及双手所在音域;
- 把这些音乐规则转换为不同 token 的 logit 偏置;
- 从调整后的分布中采样未来约 1 秒的音符,并交给第二个钢琴声部播放。
这里的“未来约 1 秒”是规划窗口,不等于系统存在 1 秒输入延迟。Duetto 会提前生成一小段即将播放的 MIDI 事件,以便保持节奏连续;当演奏者突然换和弦时,系统会丢弃尚未播放的计划并重新采样。项目目前没有公布端到端延迟、每秒生成事件数或不同 Jetson Orin Nano 配置下的性能数据,因此不能把“一秒预生成”直接理解为延迟指标。
核心不是提示词,而是直接改概率
Logit steering 是在模型采样前直接调整候选 token 分数的推理期控制方法。它不改变模型参数,而是在 softmax 之前,对某些音符加分、对另一些音符减分,从而改变最终采样概率。
如果模型原始输出为 z_t,Duetto 实际使用的分布可以抽象为:p'(x_t)=softmax(z_t+b_key+b_chord+b_register+b_phrase)。其中,模型本身负责提供音乐先验,后面的多个偏置项负责告诉模型此刻应该避开什么、靠近什么。
Duetto 目前加入了五类关键控制:
- 调性约束:调外音会被压低概率,减少明显跑调;
- 和弦约束:当前和弦音与可用 tension 音会获得正向偏置;
- 音域避让:演奏者双手附近的音符会被降权,避免两个钢琴声部挤在同一片音区;
- 旋律补位:当演奏者停下来时,生成声部会被引导至更适合旋律表达的音域;
- 乐句回应:模型会小幅提高延续演奏者上一段音程关系的概率,使输出听起来像是在回答,而不是各弹各的。
这套设计的本质,是把乐手排练时形成的默契拆成几个可计算的偏置。贝斯手会避开主奏的密集音区,伴奏者会根据和弦选择三音、七音或延伸音,独奏者停顿时另一个人会接过旋律;Duetto 没有真正理解这些社交和音乐意图,但它通过实时规则模拟了相近的结果。
为什么普通自回归模型很难直接合奏
普通自回归音乐模型擅长续写,却不天然擅长响应同时发生的外部演奏。自回归模型是根据已有事件逐个预测后续事件的模型,它可以生成风格连贯的音乐,但一旦另一名演奏者临时换和弦、改变速度或插入新乐句,先前生成的未来内容就可能立刻失效。
Anticipatory Music Transformer 是一种能够利用异步控制事件规划音乐输出的 Transformer。这里的“异步”意味着控制信号不必与生成音符一一对齐,例如一段旋律可以控制另一条时间位置不同的伴奏声部,用户也可以接受、删除或重写模型提出的局部内容。
Stanford CRFM 在 2023 年公开这款模型时,重点展示的是 infilling control,也就是在现有音乐中删除一段,再让模型根据前后文和控制声部补回内容。官方同时发布了 3.6 亿参数模型,并明确鼓励社区将其集成到 Ableton、Logic 等标准音乐制作工作流中。
Duetto 做的事情更激进一些:它把原本偏编辑式、非实时的生成能力,改造成了持续运行的现场声部。模型依旧提供从大规模 MIDI 数据中学到的乐句、节奏和声部组织能力,但实时服从关系主要来自外部采样控制器。
不微调的价值,是把控制权留在演奏现场
不微调意味着模型的参数在部署前后保持不变,开发者无需准备新的标注数据,也无需承担额外训练成本。对于实时音乐这种偏好变化频繁、控制维度高度个性化的场景,推理期控制往往比训练一个“万能伴奏模型”更实际。
几种常见控制路线的差异如下:
| 方案 | 是否需要训练 | 实时修改成本 | 控制粒度 | 主要优势 | 主要问题 | |---|---:|---:|---|---|---| | 全量微调 | 是 | 高 | 风格与整体行为 | 能深度改变模型分布 | 数据、显存和训练成本高,现场规则难快速调整 | | LoRA 或适配器 | 是 | 中 | 风格、曲风、特定任务 | 参数量小于全量微调 | 仍要准备样本,换演奏者或规则时可能重训 | | 条件输入 | 视模型而定 | 中 | 和弦、旋律、文本等 | 控制信号可被模型整体理解 | 模型必须在训练时学过对应条件格式 | | 生成后过滤 | 否 | 低 | 禁止音、音域等 | 实现简单,适合硬约束 | 删除音符容易破坏节奏和乐句连续性 | | Logit steering | 否 | 低 | 单个音符与局部规则 | 可即时调整,不破坏原模型权重 | 偏置强度依赖手工调参,规则之间可能冲突 | | Duetto 的组合方案 | 否 | 低 | 调性、和弦、音域、乐句回应 | 能在边缘设备上跟随现场 MIDI | 目前仍是原型,缺少系统性听测和延迟数据 |
Duetto 的优势在于“软控制”而不是“硬纠错”。如果系统在生成后才把所有调外音删除,节奏结构会留下空洞;如果在采样前降低这些音的概率,模型仍可从其他合理音符中选择,生成结果通常会更连续。
这种方法也保留了预训练模型的意外性。伴奏系统如果只按固定和弦模板输出分解和弦,稳定但很快会显得机械;Duetto 没有把模型限制成规则引擎,而是让规则只改变概率倾向,因此模型依然可能给出开发者没有明确写入的节奏型和旋律走向。
一秒规划窗口,是延迟与稳定性的折中
实时生成系统真正难处理的不是算力,而是不可预测的未来。窗口太短,模型只能逐音反应,乐句容易碎裂;窗口太长,生成会更连贯,但演奏者一旦改变和声或速度,更多已经规划的内容需要作废。
Duetto 选择提前采样约 1 秒,是一个偏实用的折中。对于中速钢琴演奏,1 秒通常足以包含若干音符,让模型形成短乐句;而在和弦变化时清空未播放内容,也能把错误控制在有限范围内。
重新采样机制相当于音乐版的滚动规划。系统只承诺马上要播放的部分,稍远的未来可以随现场输入不断修改,这与机器人控制和游戏 AI 中的 receding horizon 思路相似:不是一次性计划整首曲子,而是持续规划、执行一小段、再根据新状态规划。
但这个机制仍可能带来接缝问题。若旧计划已经播放到一个强烈的导向音,新计划却因和弦变化跳到完全不同的方向,听感上可能出现突然转折;若重采样过于频繁,模型也难以形成长线动机。更成熟的系统需要对已承诺音符、延音踏板状态、乐句边界和重新规划成本进行联合管理,而不只是简单清空缓冲区。
最大短板:参数全靠耳朵拧出来
Duetto 当前最明显的问题,是所有偏置值都由开发者凭听感手工调整。开发者本人也承认这种方法“有点笨”,因为调性惩罚、和弦奖励、音域避让和音程延续之间没有统一标尺。
手工偏置会产生三个现实问题:
- 不同曲风需要不同权重:古典、爵士、流行与实验音乐对调外音的容忍度完全不同;
- 规则可能互相打架:某个音既是和弦 tension,又恰好落在演奏者手部附近,系统必须决定哪个偏置优先;
- 固定参数不适应演奏者:有人希望伴奏积极对话,有人则希望模型保持克制,同一组权重很难通用。
更合理的下一步不是立刻微调整个 Transformer,而是自动学习这层控制器。开发者可以保留冻结的音乐模型,只训练一个很小的策略网络,根据当前 MIDI 状态输出 logit 偏置;也可以让演奏者对生成片段做接受、跳过或重采样操作,再用这些反馈优化权重。
贝叶斯优化、多臂老虎机和偏好学习都可能适合这个问题。它们不需要改动 3.6 亿参数的主体模型,只需搜索几十个控制参数,就有机会针对某位演奏者、某种曲风或某台设备建立单独配置。
这还不是成熟产品,但方向比“再训一个模型”更有启发
Duetto 目前仍是开发者原型,而不是经过同行评审的完整实时合奏系统。项目尚未公布主观听测人数、与固定规则伴奏的盲测结果、端到端延迟分布、连续运行稳定性以及对不同速度和曲风的成功率,因此无法仅凭演示判断它是否已经优于商业自动伴奏软件。
这项实验真正证明的是,预训练模型的能力不只存在于权重里,也存在于如何采样。行业习惯把模型行为不符合需求归因于“训练不够”,但对符号音乐这种规则明确、反馈及时的任务,推理期约束可能已经能解决相当一部分问题。
Duetto 也展示了一条更适合本地音乐工具的路线:大模型负责产生丰富先验,小型状态跟踪器负责理解现场,小型采样控制器负责把两者接起来。这样的系统无需把每一种和弦规则、音域偏好和演奏习惯重新灌进模型,也更容易在边缘设备上离线运行。
对开发者而言,最值得复用的并不是某几个具体偏置数值,而是三层解耦结构:冻结生成模型、实时提取音乐状态、在采样阶段施加可解释控制。它同样可以迁移到鼓机跟随、自动贝斯、多人 MIDI 即兴乃至游戏中的动态配乐。
Duetto 暂时还不会成为真正懂得默契的虚拟乐手,但它已经说明了一件事:要让模型学会配合人类,未必每次都要重新训练模型;有时只需要在它准备落下下一个音之前,稍微推一下概率。
参考来源
- Duetto GitHub 项目:项目代码、运行方式与实时 MIDI 合奏实现。
- Reddit:开发者公开 Duetto 实验:开发者对模型、采样偏置、约 1 秒规划窗口及 Jetson Orin Nano 部署情况的说明。