Raon-1 mini:韩语Agent新牌
KRAFTON开源30B-A4B MoE模型Raon-1 mini预览版,主打韩语、编程与Agent任务。它的优势是推理性价比,但官方跑分、长上下文和实际速度仍待独立验证。
KRAFTON开源Raon-1 mini,韩国游戏巨头开始卷Agent模型
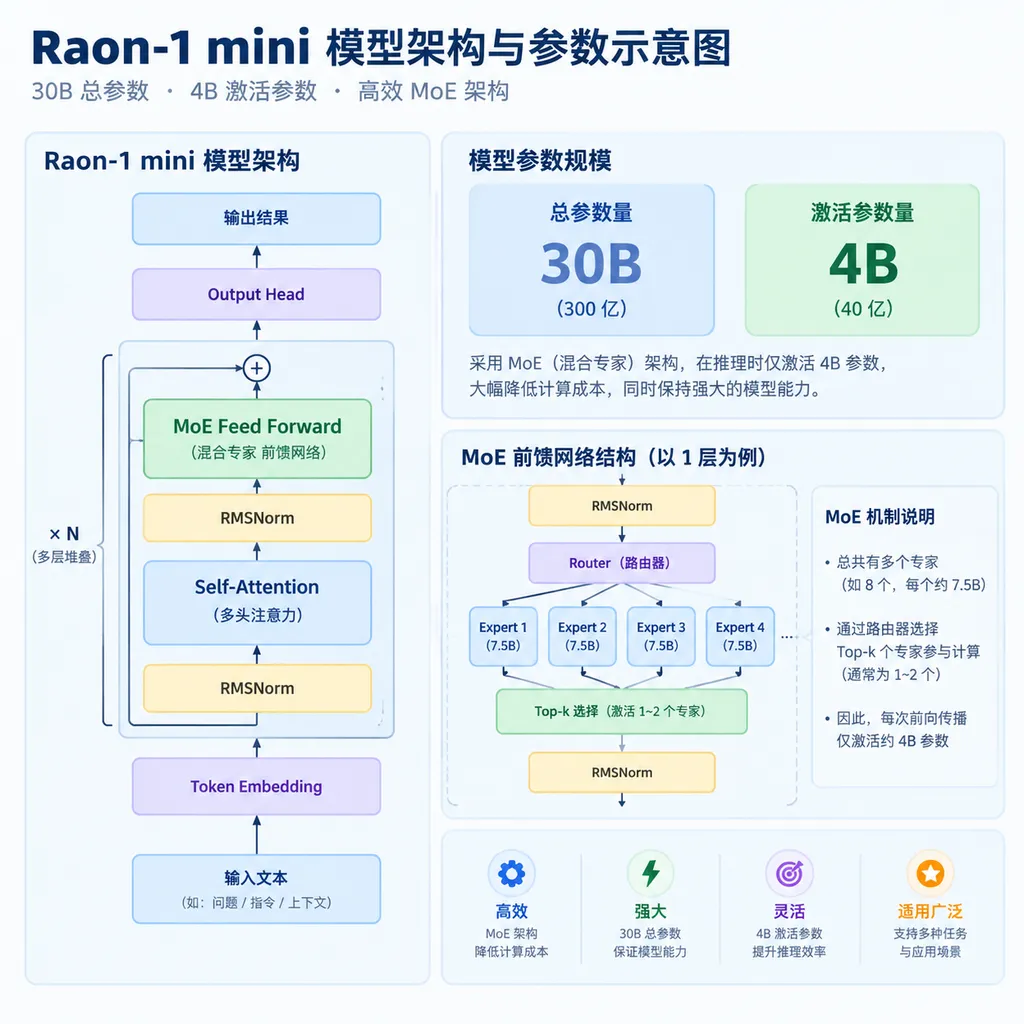
KRAFTON AI近日发布了Raon-1 mini预览版,这是一款从头训练、总参数约300亿且每个Token激活约40亿参数的混合专家语言模型。模型已经以Apache 2.0许可证开放权重,重点覆盖韩语对话、英语、编程和Agent任务,正式版以及更大规模的Raon模型将在后续推出。
这不是一次单纯的“韩国本土大模型”亮相。KRAFTON真正想验证的是:一款只激活4B左右参数的30B级MoE模型,能不能以更低推理成本,做到接近主流30B稠密模型的编程和智能体能力。
KRAFTON是《PUBG:绝地求生》背后的韩国游戏公司,而KRAFTON AI是其负责基础模型与AI应用研发的团队。游戏公司转向基础模型并不令人意外,因为游戏业务本身就是Agent技术最天然的试验场之一——NPC需要维持人格,角色需要理解复杂指令,自动化工具需要操作多步骤工作流,内容生产则需要同时处理文本、代码和结构化数据。
30B-A4B不是“小模型”,而是少算一部分参数
30B-A4B是指模型拥有约300亿总参数,但每次处理一个Token时只激活约40亿参数。这里的A代表Active Parameters,即实际参与单次前向计算的激活参数量,而不是模型在磁盘或显存中只占4B模型的空间。
混合专家模型是通过路由器为不同Token选择少量专家网络参与计算的架构。可以把它理解成一家拥有多个专业部门的公司:处理代码时调用更擅长编程的专家,处理韩语表达时选择语言专家,而不是每个问题都让所有部门同时开会。
这种设计的直接价值是降低计算量,但它不会让30B权重凭空消失。按照理论值估算,约300亿参数使用BF16存储时,仅模型权重就接近60GB;8位量化约为30GB,4位量化约为15GB,实际部署还要加上路由、缓存、运行时和量化元数据等开销。因此,Raon-1 mini更接近“一款计算成本像小模型、存储需求仍像中型模型的产品”,而不是能轻松塞进普通消费级显卡的4B模型。
Raon-1 mini还引入了KRAFTON自研的线性注意力机制。线性注意力是将传统注意力随序列长度快速增长的计算过程,改写为更接近线性复杂度的机制,目标是在长上下文场景中降低计算和内存压力。
线性注意力并不天然等于更好的长上下文质量。传统Softmax注意力可以直接比较大量Token之间的关系,而线性化通常要依赖核函数、状态压缩或混合注意力设计,因此速度、显存和远距离信息召回之间存在取舍。在详细技术报告公布前,外界还无法判断Raon-1 mini采用了怎样的注意力配比,也无法确认它在超长文档中的有效上下文究竟有多长。
Raon-1 mini同时支持推测解码,以减少逐Token生成带来的等待时间。推测解码是先由较轻量的预测过程一次提出多个候选Token,再由目标模型并行验证,从而在输出分布基本不变的情况下提高生成吞吐量。
推测解码的实际收益高度依赖接受率和部署框架。候选Token猜得越准,加速越明显;如果模型频繁拒绝候选,额外验证反而会吃掉一部分收益。KRAFTON目前强调新模型响应更快、内存效率更高,但尚未在公开预览信息中给出统一硬件下的首Token延迟、每秒Token数和并发吞吐量,因此“更快”仍是一个需要复测的结论。
官方跑分亮眼,但优势集中在推理而非知识
KRAFTON公布的评测显示,Raon-1 mini预览版在数学和科学推理任务上表现突出,但其知识基准并没有全面压过同级模型。以下数据来自官方模型卡,Dense代表稠密模型,MoE代表混合专家模型;表中数值均为官方评测结果,而非第三方复现。
| 模型 | 架构与激活规模 | MMLU Pro | GPQA Diamond | AIME 2026 | HMMT 2026年2月 | |---|---:|---:|---:|---:|---:| | Raon-1 mini preview | MoE,30B-A4B | 76.5 | 84.3 | 93.3 | 84.1 | | Qwen3.6-35B-A3B | MoE,35B-A3B | 85.9 | 83.2 | 92.9 | 84.5 | | Gemma 4 26B-A4B | MoE,26B-A4B | 82.9 | 80.7 | 87.1 | 79.9 | | Qwen3.8-27B | Dense,27B | 85.7 | 89.7 | 98.8 | 95.8 | | Muse Glimmer 30B | Dense,30B | 84.0 | 82.6 | 92.9 | 74.6 |
这组数据说明Raon-1 mini不是知识覆盖最强的30B级模型。在MMLU Pro上,它得到76.5分,低于Qwen3.6-35B-A3B的85.9分、Gemma 4 26B-A4B的82.9分和Muse Glimmer 30B的84.0分,与同组最高成绩相差9.4分。
Raon-1 mini的强项更多体现在推理任务。在GPQA Diamond上,它以84.3分超过另外两款MoE模型,并高于Muse Glimmer 30B的82.6分;在AIME 2026上,它得到93.3分,也略高于Qwen3.6-35B-A3B和Muse Glimmer 30B的92.9分。
稠密模型仍然展示了更高的性能上限。Qwen3.8-27B在GPQA Diamond、AIME 2026和HMMT 2026年2月评测中分别达到89.7、98.8和95.8分,明显高于Raon-1 mini,但稠密模型每次推理需要调用更多参数,理论计算成本也会更高。
KRAFTON把Raon-1 mini的编程和Agent能力对标Muse Glimmer 30B,而不是宣称全面击败所有30B模型。官方表示,两者在相关任务上的能力相当,但Raon-1 mini具有更快响应和更高内存效率;目前公开资料没有给出足够完整的统一速度数据,开发者不应把架构上的理论优势直接当成生产环境结论。
Agent能力比聊天跑分更值得关注
Agent模型是能够理解目标、拆分步骤、调用工具并根据执行结果继续行动的语言模型。它与普通聊天模型的差别不只是“回答更聪明”,而是能否在长流程中稳定维护状态、遵守输出格式,并在工具返回异常时修正下一步行动。
Raon-1 mini对Agent任务的投入与KRAFTON的业务背景高度一致。游戏研发涉及代码生成、Bug定位、资产管理、剧情编排和角色行为控制,一款擅长多步骤任务的模型可以同时服务内部生产工具与游戏内交互,而不是只作为一个面向消费者的聊天机器人存在。
指令遵循可能是Raon-1 mini比传统韩语模型更实用的地方。KRAFTON强调模型能够在格式限制、Persona设定和多重条件叠加时维持自然对话,这些能力对客服、企业助手和游戏NPC都比单轮问答跑分更重要。
编程与Agent评测仍需警惕测试框架带来的偏差。官方模型卡显示,SWE-Verified使用mini-SWE-agent框架评估,部分Agent评测还依赖统一的模型裁判和用户模拟器;这类结果会同时受到系统提示词、工具定义、重试策略、推理预算和裁判模型偏好的影响,不能简单理解为模型裸能力。
真正有参考价值的Agent测试应该同时公布任务成功率、平均步骤数、Token消耗、工具调用错误率和端到端成本。一款模型如果成功率只高2个百分点,却需要多一倍步骤和三倍Token,在生产环境中可能反而更贵、更慢。
韩语是Raon-1 mini最清晰的差异化入口
韩语能力是Raon-1 mini区别于国际通用模型的核心定位。通用模型通常具备韩语能力,但训练语料、文化语境、敬语体系、口语表达和本地知识的覆盖程度不一,复杂指令下还可能退回英语式表达结构。
韩语模型的价值不只体现在翻译准确率。客服系统需要区分敬语层级,游戏角色需要保持稳定语气,企业文档助手需要理解韩国本地制度与专有名词,内容产品则要求文本自然到足以直接发布,这些场景很难通过简单的多语言平均跑分衡量。
Raon-1 mini兼顾英语的策略也符合Agent产品的现实需求。代码、软件文档、工具描述和开源项目普遍以英语为主,如果一个韩语模型只能处理本地语言,它在编程和工具调用链路中很容易遇到能力断层。
不过,KRAFTON尚未公开足够细致的韩语评测拆分。开发者仍需要关注它在敬语转换、事实问答、韩国法律与文化知识、方言、韩英混合输入以及长对话人格一致性上的表现,而不能仅凭“自然韩语对话”这一官方描述作出选型决定。
Apache 2.0很友好,但预览版更准确地说是开放权重
Apache 2.0是允许修改、分发和商业使用的宽松开源许可证,同时包含明确的专利授权条款。对于企业用户,这意味着Raon-1 mini可以被用于研究、内部部署和商业产品,不必像部分限制性模型许可证那样额外核对用户规模或特定用途门槛。
Raon-1 mini当前更准确的定位是开放权重预览,而不是完全可复现的开源基础模型。KRAFTON已经发布模型权重与基础说明,但详细训练流程、数据构成、过滤策略、完整架构和最终性能报告要等正式版阶段公布;在这些材料缺失时,外部团队无法从头复现同一模型。
预览版标签也意味着它不适合未经验证就直接进入关键业务。模型后续可能调整权重、模板、上下文实现和推理配置,当前版本的提示词效果与部署参数未必能够原样迁移到正式版。
它适合谁,又不适合谁
Raon-1 mini最适合需要韩语能力、允许本地部署,同时又关心编程和工具调用的团队。尤其是韩国市场的游戏、客服、办公自动化和企业知识助手,可以把它作为国际通用模型之外的本地化候选项。
以下三类场景值得优先测试:
- 韩语Agent应用:验证多步骤任务、结构化输出、浏览器操作和企业工具调用。
- 游戏研发与NPC对话:测试Persona稳定性、剧情约束、韩语口语自然度和低延迟交互。
- 本地编程助手:评估代码补全、仓库级问题定位、测试生成以及韩英混合需求理解。
以下三类用户则不必急着迁移:
- 只看综合知识能力的用户:Raon-1 mini在MMLU Pro上没有领先同级模型。
- 显存非常有限的个人开发者:A4B降低的是计算量,不代表完整权重只按4B占用显存。
- 需要成熟生产稳定性的企业:当前仍是preview版本,详细技术报告和正式版尚未发布。
KRAFTON的机会是性价比,风险也是缺少实测
Raon-1 mini最有吸引力的地方不是某一项跑分夺冠,而是用约4B激活参数触碰30B级模型能力。如果第三方测试能够确认其韩语质量、Agent成功率和推理吞吐量,这款模型会成为韩国企业私有化部署中相当现实的选项。
Raon-1 mini当前最大的短板是关键结论主要来自官方自测。官方没有完整披露统一硬件下的首Token延迟、解码速度、并发吞吐、峰值显存和单位任务成本,线性注意力与推测解码的真实收益也需要主流推理框架复现。
Raon-1 mini因此更像一张有潜力的入场券,而不是已经坐稳第一梯队的成品。它证明KRAFTON正在从AI应用方转向基础模型供应方,但能否与成熟开源生态竞争,要看正式版能否补齐技术报告、部署支持、量化版本、推理框架适配和第三方评测。
截至2026年10月25日,开发者最合理的态度是尽早测试,但暂缓下最终结论。对韩语Agent和游戏AI团队而言,它已经值得下载;对只追求通用能力的用户而言,Raon-1 mini还需要拿出比官方榜单更硬的实际数据。
参考来源
- KRAFTON/Raon-1-mini-preview-dflash2|Hugging Face:KRAFTON发布的官方模型卡,包含许可证、模型定位、架构说明和基准测试数据。
- IT之家:KRAFTON AI预览Raon-1 mini模型:中文发布信息汇总,介绍30B-A4B架构、线性注意力、推测解码与后续发布计划。
- Reddit LocalLLaMA社区讨论:开源模型社区对Raon-1 mini预览版和Hugging Face权重的讨论。