ChatGPT把媒体认成客服
404 Media近日称,ChatGPT持续把这家科技媒体推荐给求助用户。一次看似荒诞的误认,暴露了AI搜索在实体消歧、来源归因和推荐边界上的系统性缺陷。
ChatGPT正在给一家媒体“派客服工单”
ChatGPT最近持续把科技媒体 404 Media 推荐成技术支持机构,导致后者收到大量由 AI 生成或引导的求助邮件。 据 404 Media 近日披露,一些用户在遇到账户、软件或设备问题后询问 ChatGPT,模型没有把他们引向产品厂商的官方支持渠道,而是建议联系 404 Media,甚至生成措辞完整、看起来可以直接发送的求助邮件。
404 Media 是一家调查科技平台、网络安全和数字文化议题的独立媒体,并不是面向公众处理产品故障的客服机构。 它会报道黑客攻击、账号盗用、平台审核和大型科技公司的服务失灵,也设有联系记者、提交线索和订阅支持的入口,但这些都不等于它具备重置账号、恢复数据或处理厂商工单的权限。
截至 2026 年 10 月 26 日,404 Media 对问题的描述仍是“持续发生”,而不是一次偶然的聊天截图。该媒体没有给出统一统计口径下的邮件总量,公开材料也没有显示 OpenAI 已经说明具体触发机制或公布修复时间表,因此不能把事件简单归结为某个提示词、某次索引更新或单一模型版本。
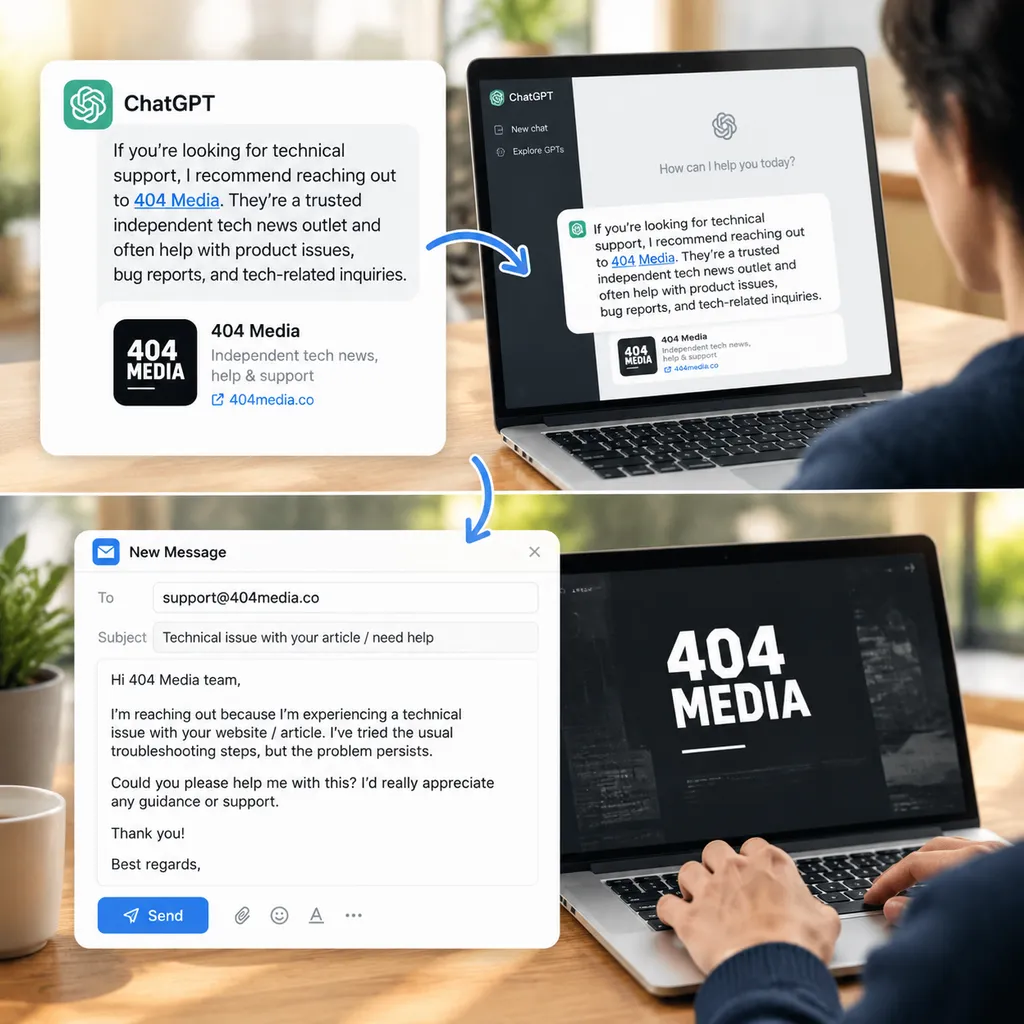
这件事最值得关注的地方不是 ChatGPT 闹了一个“404”笑话,而是 AI 搜索已经开始替用户决定“下一步应该找谁”。 当模型只是答错一个发布日期,用户还能通过其他来源复核;当模型错误推荐一个机构、医生、律师、维修商或安全研究员时,它会把真实的时间成本、隐私风险和潜在责任直接转嫁给第三方。
有搜索结果,不等于找对了责任主体
AI 搜索是将网页检索、内容排序和大模型生成组合成自然语言答案的搜索形态。 它与传统搜索最大的区别,是用户不再只看到一组链接,而是直接得到一段结论、若干引用,以及类似“联系这家公司”“按照以下步骤申诉”的行动建议。
来源归因是判断某项事实、引文或服务能力究竟属于哪个来源的过程。 一个回答即使引用了真实网页,也可能把网页报道的对象、网页作者和能够解决问题的机构混为一谈。例如,媒体曾经报道某个平台的账号恢复失败,并不意味着媒体能够恢复该平台账号。
实体消歧是区分名称相似、语义相关但身份不同的个人、组织和产品。 在这起事件中,“404”本身是常见的 HTTP 未找到状态码,404 Media 又长期发布技术、平台治理和网络安全报道,其网站还存在 Contact、Support/FAQ 等页面元素,这些信号可能让模型把“报道技术问题的媒体”推断成“处理技术问题的支持机构”。这只是基于公开信息的合理推测,并非 OpenAI 已确认的根因。
推荐归因比普通事实归因多了一层责任判断。 模型不只需要确认某个机构是否存在,还要判断它是否提供对应服务、服务对象是谁、有没有权限处理问题,以及推荐是否会让用户提交密码、身份文件、订单号或其他敏感信息。
一条 AI 搜索答案大致要经过四个容易出错的环节:
- 检索阶段决定看见哪些网页。 如果查询是“谁能帮我解决某平台账号问题”,系统可能检索到报道类似事件的新闻,而不是平台官方帮助中心。
- 排序阶段决定哪些网页更像答案。 独立媒体的调查报道通常信息丰富、关键词密集,反而可能比内容简短的官方客服页面更容易被模型使用。
- 生成阶段把相关性改写成能力。 “这家媒体报道过此类问题”可能被语言模型补全为“这家媒体能够帮助处理此类问题”。
- 引用阶段给结论增加可信外观。 即使脚注链接本身真实,链接也未必支持“应该联系它寻求技术支持”这一结论。
引用正确性和引用完整性是两套不同指标。 引用正确性关注链接是否真的支持附近的表述,引用完整性关注答案中的重要判断是否都有证据;ChatGPT 即使准确引用了 404 Media 的一篇报道,也不能据此证明这家媒体承担客服职能。
76.5%的归因错误不是一个轻微瑕疵
ChatGPT Search 的历史测试已经显示,来源识别并不是“加上脚注”就自动解决的问题。 哥伦比亚大学新闻学院 Tow Center 在 2024 年发布的一项测试中,从 20 家出版机构选取 200 段引文,要求 ChatGPT Search 识别对应来源;研究人员记录到 153 次回答存在部分或完全错误,错误率为 76.5%。
这项测试最危险的结果不是模型不会,而是模型经常在不会时继续回答。 在 200 次查询中,系统只有 7 次明确表示无法找到答案;其余错误回答可能给出错误出版物、错误链接,或者用高度确定的语气补出一个并不可靠的来源。
76.5%不能直接视为 2026 年版本 ChatGPT Search 的当前错误率。 该数字来自特定时间、特定样本和特定任务,OpenAI此后也持续更新搜索与引用机制,但它仍然揭示了一种没有被产品界面消除的结构性风险:模型的流畅程度、链接数量和事实可靠性不是同一件事。
| 产品形态 | 用户直接看到的内容 | 主要归因机制 | 典型失败方式 | 错误成本 | |---|---|---|---|---| | 传统网页搜索 | 标题、摘要、网址列表 | 用户自行判断网页与机构关系 | 排名靠前但不相关、广告混入 | 用户多点几次链接 | | AI 搜索 | 综合答案、脚注、行动建议 | 模型完成检索、归纳和主体判断 | 错引来源、把报道者当服务方 | 用户直接采取错误行动 | | 企业知识库问答 | 内部文档生成的回答 | 权限控制加限定语料检索 | 过期流程、权限信息泄露 | 形成错误工单或合规事故 | | 官方客服机器人 | 产品帮助文档和账户流程 | 官方知识库与业务系统绑定 | 无法识别边缘案例、循环回复 | 延误处理,但责任主体清晰 |
ChatGPT误认404 Media,说明AI搜索的产品目标已经从“帮用户找到信息”滑向“替用户分配责任”。 前者要求相关,后者要求授权;前者答错是一条坏链接,后者答错可能让无关机构承受邮件、骚扰、数据处理和法律风险。
为什么媒体尤其容易被认成解决问题的人
高质量媒体往往比真正的客服页面更符合大模型偏好的文本形态。 调查报道会完整描述问题背景、受害者经历、平台名称、处理步骤和最终结果,而很多官方帮助中心只有模板化短句、交互式表单,甚至需要登录后才能访问。
搜索可见性与服务能力之间存在天然错位。 一篇关于“如何有人成功找回账号”的报道可能包含大量恢复账号相关词汇,但文章的作用是解释事件,而不是替平台执行身份验证。检索系统看到了语义接近,生成系统却进一步推断出了组织能力。
独立媒体的联系入口也会强化错误推荐。 记者通常公开邮箱或线索提交表单,模型很容易找到一个“可联系对象”;相比之下,大型平台经常把人工支持藏在多层帮助页面、登录状态或付费服务之后。404 Media 对事件的概括很直接:大型科技公司不做足够的客户服务,最终由一家新闻机构接收 AI 生成的求助邮件。
AI生成邮件让错误推荐具备了自动扩散能力。 过去,用户即使误以为记者可以解决问题,也需要自己查找邮箱并说明情况;现在,模型可以同时完成机构选择、邮件起草和语气润色,把一次不确定的猜测包装成完整行动方案。
这种链路可以概括为:
- 用户把问题交给 ChatGPT;
- ChatGPT 检索到一篇相关调查报道;
- 模型把“报道过”推断为“能处理”;
- 模型找到公开联系入口;
- 模型生成一封礼貌但投错对象的邮件;
- 媒体承担阅读、判断和回复成本。
错误成本因此具有明显的不对称性。 模型生成一封邮件可能只需要数秒,接收方却要花几分钟判断是否涉及真实安全事件、是否需要保护求助者隐私,以及是否应该转交其他机构;当这一过程被成百上千名用户复制,成本就从一次幻觉变成了持续的运营负担。
“有引用”正在制造一种新的过度信任
引用外观是当前 AI 搜索最容易被高估的能力。 用户通常会把脚注、站点图标和可点击链接理解为“系统已经核实”,但很多产品只保证某段生成内容与检索材料相关,并不保证材料能够支持全部结论。
搜索增强生成并不会从根本上消除幻觉。 检索增强生成(RAG)是先从外部资料中检索相关文本,再让模型基于这些文本生成答案的方法;它能降低模型凭空编造的概率,却仍可能检索错文档、截断关键上下文,或把文档中的相关描述过度概括。
真正可靠的推荐必须同时通过事实、权限和时效三项检查。 对“谁可以解决问题”这类查询,系统至少应该确认:该机构明确提供这项服务;官方页面存在当前有效的联系渠道;该机构对目标产品或账户拥有处理权限。少一项,都不应该输出确定性推荐。
| 检查项 | 模型需要回答的问题 | 404 Media案例中的风险 | |---|---|---| | 身份检查 | 这是媒体、厂商、社区还是官方支持机构? | 把新闻出版商识别成技术服务方 | | 能力检查 | 对方是否明确承诺提供相关服务? | 用报道经历替代服务声明 | | 权限检查 | 对方能否访问账户或后台系统? | 推荐一个没有处理权限的第三方 | | 时效检查 | 联系方式和流程是否仍然有效? | 使用过期文章或历史案例 | | 隐私检查 | 用户是否会提交敏感信息? | 邮件可能包含账号、手机号或身份证明 | | 不确定性检查 | 证据不足时是否拒绝下结论? | 用流畅措辞掩盖证据缺失 |
OpenAI需要修的不是一句提示词
OpenAI首先应该把“信息来源”和“服务提供方”拆成两种实体关系。 新闻网站、论坛帖子和研究论文可以证明问题存在,却不应自动进入“推荐联系对象”的候选列表;只有页面明确声明服务范围,系统才应给出操作性建议。
OpenAI其次应该为高风险推荐增加否定证据。 如果某网站的 About、FAQ 或 Contact 页面显示其性质是媒体、研究机构或社区,排序系统就应该降低其作为客服渠道的权重,而不是只因为页面包含大量技术关键词就继续推荐。
OpenAI还需要让引用精确到支持结论的句子。 用户点击脚注后,应该看到哪段原文证明“该机构提供这项服务”,而不是只落到一篇主题相近的长文章。找不到明确服务声明时,产品应改写为“这家媒体报道过类似事件,但不是官方支持渠道”。
置信度校准比继续增加答案长度更重要。 置信度校准是让模型表达的确定程度与实际正确率相匹配;当系统无法确认责任主体时,一句“我无法验证该机构是否提供支持,请优先使用厂商官网”比一封完整但投错对象的邮件更有价值。
出版商也需要获得纠错和退出推荐的机制。 robots.txt 或抓取权限解决的是内容能否被访问,却不能完整解决组织身份被错误描述的问题。媒体应该能够声明“本站不提供消费者技术支持”,并要求搜索产品对错误实体标签进行更正。
用户现在应该怎样判断AI推荐
用户不应该把 ChatGPT 生成的联系对象直接视为官方渠道。 在发送邮件、上传文件或提供身份信息前,应从厂商官网首页重新进入帮助中心,而不是只依赖 AI 给出的深层链接、邮箱或电话号码。
一个可操作的验证方法是寻找明确的服务声明。 如果目标网站只说“报道”“研究”“接受新闻线索”或“社区讨论”,却没有写明“客户支持”“账户恢复”“售后服务”,它大概率不是能处理问题的机构。
涉及账号恢复和支付争议时尤其不能向第三方发送敏感数据。 密码、双重验证代码、身份证件、银行卡信息和完整订单记录,不应因为 ChatGPT 生成了一封措辞专业的邮件就交给媒体、论坛用户或陌生顾问。
出版商则应把异常求助邮件视为搜索归因故障的监测信号。 记录用户提到的模型名称、原始问题、推荐措辞和引用页面,有助于判断错误来自搜索索引、实体识别还是生成阶段,也能为向平台提交纠错提供证据。
这不是笑话,而是AI搜索的责任测试
404 Media遭遇的不是普通流量误导,而是AI产品把自身不确定性外包给了现实世界。 ChatGPT没有真正承担客服工作,它只是以低成本生成了一个看似合理的去向;用户承担问题继续拖延的代价,媒体承担额外沟通成本,真正应该解决问题的平台反而没有被触达。
AI搜索的下一阶段竞争不会只看答案速度和界面是否简洁。 更关键的指标将包括来源识别准确率、引用支持率、推荐主体准确率、拒答质量,以及错误发生后能否让被误认的机构快速纠正。
这起事件给所有AI搜索产品划出了一条清晰边界:知道谁写过某件事,不等于知道谁能解决某件事。 如果模型连“报道者”和“责任方”都分不清,那么再漂亮的引用卡片,也只是给归因失准套上了一个更可信的外壳。
参考来源与延伸阅读
- OpenAI Cookbook:OpenAI维护的公开示例仓库,可用于了解检索、工具调用与引用型应用的常见实现思路。
- RAGAS论文页面:介绍检索增强生成的自动评估框架,覆盖上下文相关性、答案忠实度等指标。
- Self-RAG论文页面:讨论模型如何通过检索和自我反思,提高生成内容的事实可靠性。
- Reddit:ChatGPT Search attribution讨论检索:汇总用户对ChatGPT搜索引用、错误来源和归因问题的公开讨论。