OpenAI称推翻ETH,三项证明待审
OpenAI公布数学、计算机科学与物理学三项AI研究成果,其中两项已完成Lean形式化,杨–米尔斯相关证明仍在专家复核。真正的突破不只取决于机器验算,还要经过独立复现、同行评议与原创性审查。
OpenAI一次抛出三项科学发现,但现在还不能写进教科书
OpenAI于2026年10月27日公布三项由内部AI模型生成的科学成果,分别涉及全维局部光滑猜想、指数时间假设,以及量子色动力学与杨–米尔斯理论的严格数学基础。前两项已经转写为Lean形式化证明并公开材料,第三项则进入由外部专家参与的学术复核流程。
这次发布最值得关注的不是“AI又做对了几道难题”,而是OpenAI正在尝试建立一条新的科研生产线:模型提出论证,形式化系统检查逻辑,领域专家审查数学含义与原创性,最后交给学术共同体复现。与传统大模型只给出一段看起来像证明的自然语言不同,这套流程开始触及科学成果真正的验收环节。
不过,“OpenAI宣布突破”和“学术界确认突破”仍然是两件事。Lean可以检查形式系统中的推导是否成立,却不能自动证明问题定义没有被偷换、形式化版本完全对应原命题、文献优先权不存在争议,更不能替代期刊或会议的同行评议。
三项成果分别到了哪一步
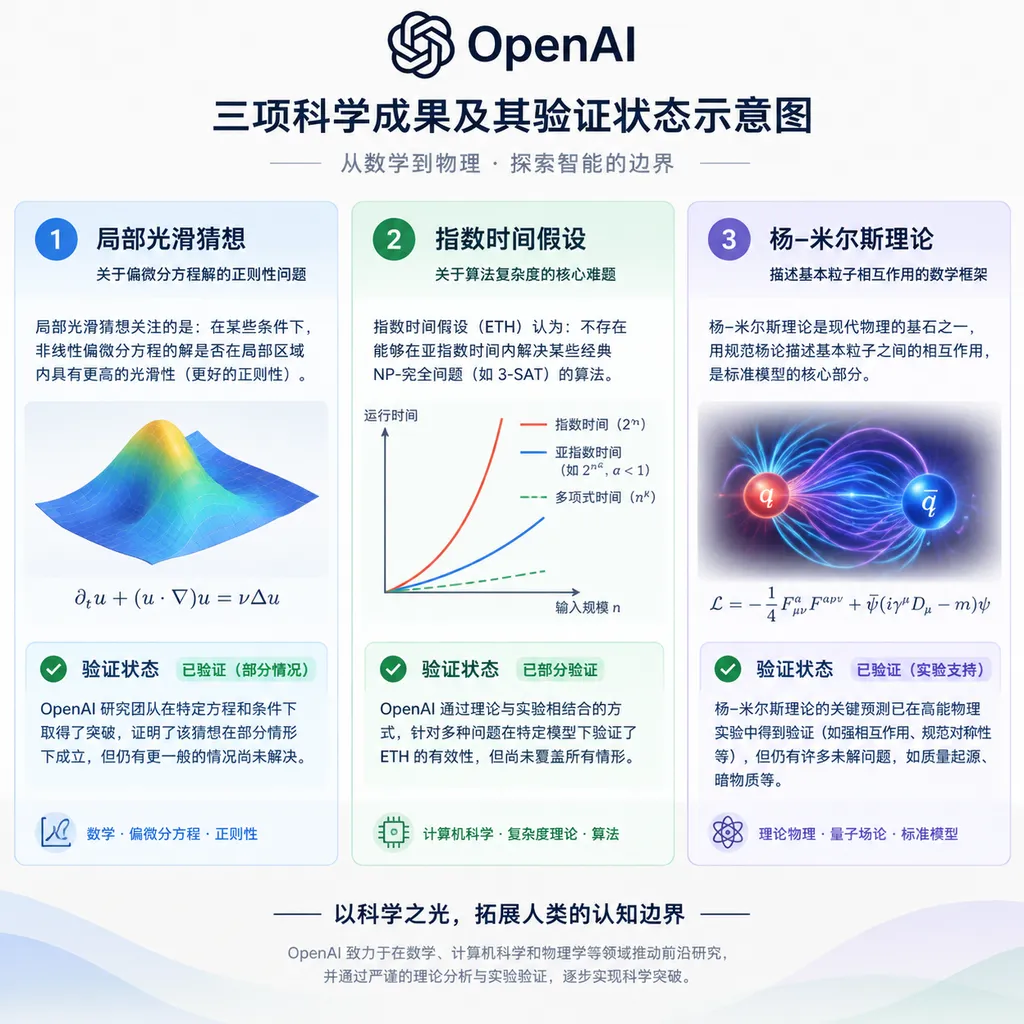
OpenAI此次公布的三项成果处在不同的可信度阶段,不能简单打包成“三个已经解决的世纪难题”。数学成果拥有自然语言证明和Lean版本,计算机科学成果也给出了可检查的论文与形式化材料;物理学成果目前主要依赖专家审查,结论的不确定性明显更高。
| 研究方向 | OpenAI声称取得的结果 | 当前验证方式 | 若成立的意义 | 目前最关键的风险 | |---|---|---|---|---| | 调和分析 | 证明所有维度下的局部光滑猜想,并推出挂谷猜想与斯坦因限制猜想的相关结论 | 自然语言证明、Lean形式化、公开材料 | 统一推进波传播、傅里叶分析与几何测度论中的核心问题 | 形式化命题是否与原始猜想完全等价,证明依赖是否完整 | | 计算复杂性 | 给出反驳指数时间假设的算法与证明 | 论文、Lean形式化、公开仓库 | 若3-SAT获得次指数时间算法,将改写细粒度复杂性理论的一批条件下界 | 算法模型、参数定义、最坏情况界和隐含假设是否准确 | | 数学物理 | 提出量子色动力学及杨–米尔斯理论的严格存在性证明 | 外部专家与物理学家复核,尚未完成全面形式化 | 可能触及杨–米尔斯存在性与质量间隙这一千禧年难题 | 物理假设、正则化极限、质量间隙和公理化框架能否全部闭合 |
这张表也说明了一个容易被标题掩盖的事实:三项成果的证据等级并不相同。数学和计算机科学结果至少进入了机器可检验阶段,物理学结果则仍更接近一份高度重要、但尚待拆解的候选证明。
第一项:全维局部光滑猜想获得Lean证明
局部光滑猜想是调和分析中描述波方程解在时空平均后能获得多少额外正则性的猜想。直观地说,波可以在某个瞬间高度聚焦,但这种极端聚焦通常不能长时间维持;把观察窗口从单个时刻扩展到一段时间后,整体行为会比最坏瞬间平滑。
这项猜想由数学家Christopher Sogge在1991年提出,其困难不在于某个具体方程能否算出,而在于要同时控制频率、空间尺度、传播方向和不同维度下的几何结构。它连接波方程、傅里叶限制理论和挂谷型问题,是调和分析中的枢纽命题之一。
OpenAI声称,内部模型给出了适用于所有维度的局部光滑证明,并通过构造一个新的辅助偏微分方程完成关键论证。按照官方披露的时间线,模型在2026年10月18日生成证明,团队于10月19日完成Lean形式化,前后只相隔一天。
这一时间差甚至比结论本身更能体现AI科研工作流的变化。传统数学研究中,从手写证明到完整形式化往往需要数周、数月甚至更久,因为研究者必须把“显然”“类似可得”等跳步全部展开,并把每个对象映射到证明助手能够识别的定义与引理;OpenAI如果确实在一天内完成了主要形式化,意味着模型已经不只是猜证明,还能承担大量证明工程工作。
局部光滑结果的影响范围也超过单一猜想。OpenAI表示,该证明可以进一步解决所有维度下的挂谷猜想和斯坦因限制猜想相关问题;这类“一个枢纽定理带动多个结论”的结构,正是该成果被称为重大突破的原因,而不是因为论文篇幅或推理链单纯更长。
历史进度为这次宣称提供了参照。2019年,Larry Guth、王虹和张睿翔完成二维局部光滑问题的重要证明;2025年,王虹与Joshua Zahl又推进并解决三维挂谷猜想。OpenAI现在声称把结论推进到所有维度,跨度显著,但也因此更需要领域专家逐项核对它与既有方法之间的关系。
第二项:ETH被推翻,不等于P等于NP
指数时间假设是计算复杂性理论中关于3-SAT不存在次指数时间算法的假设。常见表述是:对于含有n个变量的3-SAT问题,不存在运行时间为2的o(n)次方乘以多项式因子的通用算法;它比P不等于NP更强,也是大量细粒度复杂性下界的基础。
OpenAI公开论文的标题直接写作《The Exponential Time Hypothesis Is False》,即“指数时间假设是错误的”。如果论文中的算法、复杂度分析和适用模型均经得起独立检查,这将意味着3-SAT至少可以在次指数时间内求解,并迫使理论计算机科学重新检查大量以ETH为条件的下界结论。
ETH被推翻并不自动意味着P等于NP。次指数时间算法仍然可能远慢于多项式时间,例如运行时间可能是2的平方根n次方;它在渐近意义上优于2的cn次方,但面对大规模输入时依旧可能不可实用。因此,“SAT从此可以快速求解”是过度解读,“一批条件下界的地基需要重验”才是更准确的说法。
ETH结果的审查重点也不同于纯数学定理。审稿人不仅要检查逻辑推导,还要核对输入规模如何定义、稀疏化引理如何使用、随机性是否被隐藏、算法是否仅在特殊分布或非均匀模型中成立,以及复杂度常数是否依赖实例本身。复杂性理论中,一个量词、一个参数或一种计算模型的变化,就可能把“推翻ETH”降格为“解决某个受限版本”。
OpenAI已经把相关论文放入公开GitHub仓库,这使独立研究者可以直接检查证明与版本记录。公开材料的价值不只是透明,还在于它允许社区构造反例、运行形式化文件、追踪依赖项,并判断论文结论究竟推翻了标准ETH、随机ETH,还是某个参数化变体。
第三项:杨–米尔斯结果最重,也最需要降温
杨–米尔斯存在性与质量间隙问题是克雷数学研究所列出的七个千禧年难题之一。它要求在四维量子杨–米尔斯理论中建立严格的数学存在性,并证明理论具有正的质量间隙,奖金为100万美元,但奖金从来不是这道题真正的难点。
OpenAI此次声称提出量子色动力学及杨–米尔斯理论的严格数学存在性证明,并邀请包括诺贝尔物理学奖得主在内的外部专家参与审查。与前两项不同,这项工作尚未被描述为已经完成Lean形式化,因此当前更适合称为“候选证明”或“待复核成果”。
数学物理证明难以仅靠局部推导过关。一个完整结果通常要明确构造何种量子场、采用怎样的公理体系、如何处理重整化、怎样控制连续极限,以及正质量间隙是否对目标理论成立;只证明某个格点模型存在,或只在额外假设下得到能隙,都不等于解决完整的千禧年问题。
外部专家在这里承担的是“牧羊人”角色,而不是为OpenAI提前背书。专家需要帮助拆分论证、识别关键引理、寻找适合验证的同行,并判断结果究竟是完整证明、条件性定理,还是一条有价值但尚未封闭的研究路线。
这项成果因此最可能出现两种结局。理想情况下,专家确认其核心结构成立,再由数学物理社区补齐形式化和论文表达;谨慎情况下,证明中的某一步无法闭合,但模型提出的新构造仍可能成为可发表的方法。对于前沿科研而言,“完整证明失败但产生新工具”依然有价值,只是不能再用“解决千禧年难题”概括。
Lean通过了,为什么还要同行评议
Lean是一种支持机器检查数学证明的交互式定理证明器。研究者把定义、假设、引理和结论写成形式化代码后,Lean内核会检查每一步是否能从给定公理和已验证规则推出,从而显著减少漏步、符号误用与隐蔽逻辑跳跃。
Lean的优势是逻辑可信度高,而不是自动理解现实含义。只要形式化代码通过内核检查,就可以较有把握地说“这个形式系统中的这个定理成立”;但要说“原始论文中的科学命题已经解决”,还需要回答至少四个问题:
- 形式化定理与公众理解的原始猜想是否完全一致;
- 证明是否使用了额外公理、未证明占位符或过强前提;
- 依赖库中的定义是否准确表达研究对象;
- 结果是否已被既有论文证明,或依赖未正确引用的工作。
同行评议是专家对问题意义、方法正确性、原创性和文献关系进行综合审查的过程。它和Lean不是替代关系:Lean更像逐行通过的编译器与类型检查器,同行评议则要判断程序是不是实现了真正想实现的需求,以及这个需求是否已经被别人完成。
形式化证明还需要可复现的构建环境。外部研究者应当固定Lean版本、mathlib版本和依赖提交,重新编译全部文件,检查是否含有未关闭目标、非标准公理或跳过验证的机制,并把形式化定理逐句映射回论文表述;只有完成这些步骤,“机器验证”才不只是发布方的自我声明。
OpenAI正在修正10月初的“论文洪水”策略
OpenAI在2026年10月6日曾集中公开722篇AI生成数学手稿,并按官方口径整理为372个成果族。那次发布迅速暴露出规模化AI科研的治理难题:数学家来不及审阅,部分手稿缺少完整形式化,引用与优先权也需要持续修正,海量产出反而可能把验证成本转嫁给学术共同体。
此次发布明显改变了组织方式。OpenAI没有只把三份结果扔进仓库,而是针对计算机科学和物理学成果引入外部专家协调审查;对于局部光滑证明,则根据专家建议同时公开自然语言与Lean材料,让社区自行复现并形成独立解释。
这种调整是必要的,但还不够。AI可以把生成论文的边际成本压得很低,专家审查的时间却没有同步增加;如果每家实验室都批量输出数百个候选定理,科学界最稀缺的资源将不再是“提出答案”,而是能够承担声誉责任的复核者。
真正可持续的发布机制应该给每项成果附上结构化状态。至少应包括生成日期、模型版本、计算资源、形式化覆盖率、依赖公理、独立编译记录、专家审阅范围、已知缺陷、修订历史和引用清单,而不是只展示一个醒目的“已解决”标签。
这次突破真正改变的是科研接口
OpenAI三项成果最重要的信号,是前沿模型开始从“科研聊天助手”转向“候选知识生产者”。模型不再只总结论文、生成代码或求解竞赛题,而是主动搜索证明路径、构造辅助对象、写出长链论证,并尝试把结果交给形式化系统验收。
这一能力若被独立确认,将首先改变数学与理论计算机科学的工作分工。研究者可以让模型并行探索大量引理和反例,再把最有希望的路线送入Lean;人类则把精力放在问题选择、概念创新、解释、文献判断和最终责任上。科研不会因此完全自动化,但实验与验证周期可能被显著压缩。
这次发布也说明,跑分已经不足以评价科学型模型。一个模型在数学竞赛中拿满分,只能证明它擅长已知答案的问题;能否提出新定理、给出可形式化证明、正确处理文献归属,并在外部专家攻击下存活,才是更高一级的能力测试。
截至2026年10月27日,最稳妥的结论仍是:OpenAI已经公开三项具有重大潜力的候选科学成果,其中两项进入Lean机器验证阶段,一项进入高规格专家复核阶段。它们有可能重写调和分析、复杂性理论与数学物理,也有可能在独立审查中被限定、修订甚至否定。
判断AI是否真的推进了人类知识,最终不看发布会用了多少次“突破”,而看三件事:外部团队能否复现,专家能否找不到致命缺口,结论能否在数月乃至数年的公开检验后继续成立。OpenAI这次交出的不是终局答案,而是一组已经进入严格验收流程的科学声明。
参考来源
- IT之家:OpenAI宣布三项科学突破:汇总三项成果、Lean验证状态、局部光滑猜想时间线及物理学专家审查安排。
- GitHub:The Exponential Time Hypothesis Is False论文:OpenAI公开的ETH论文PDF,可用于核对算法、定理表述与复杂度证明。
- GitHub:OpenAI数学成果仓库:收录OpenAI公开的数学手稿、形式化证明及后续版本修订记录。