NoveltyBench拷问AI评审
Ai2 发布 NoveltyBench,专门检验 LLM 能否基于既有文献判断研究创意的新颖性。结论并非简单的能或不能:模型适合辅助检索和初筛,但还不足以独立裁决创新。
近日,艾伦人工智能研究所(Ai2)发布 NoveltyBench,把一个日益现实的问题摆到台面上:当大模型开始生成论文选题、实验方案和研究假设,我们能否再让另一个大模型判断这些创意是否真的新颖?截至 2026 年 10 月 27 日,官方给出的答案更接近“有条件可用”,而不是“可以放心交给 AI 评审”。
NoveltyBench 是一个评估大语言模型能否可靠判断研究创意新颖性的基准。 它关注的不是模型能否写出一段“看起来很创新”的文字,而是模型能否结合此前公开的研究,识别某个核心想法是否已经出现、与既有工作的差异是否成立,以及支撑判断的证据是否充分。
这项基准的真正价值,不是再给模型排行榜增加一列分数,而是把“新颖性判断”从语言风格问题拉回到证据问题。一个模型可以非常流畅地解释某项工作“首次实现了什么”,却可能没有找到最相关的前序论文;它也可能找到了措辞相近的文章,却没有看懂两者在假设、方法或实验设置上的关键差异。
新颖性不是“听起来没见过”
研究新颖性是某个创意相对于特定时间点之前的公开知识,是否包含实质性且此前未出现的贡献。 这一定义包含三个经常被通用聊天模型忽略的限制:新颖性必须有时间边界,必须有比较对象,还必须落到可验证的技术差异上。
时间边界尤其重要。一个研究想法在 2022 年可能尚未公开,到 2026 年已经成为常规方案;如果模型使用了更晚出现的论文或训练记忆来回看早期工作,就会产生“事后诸葛亮”式判断。反过来,如果模型的知识截止时间太早,它也可能把已经发表两年的方法误判为新创意。
比较对象同样不能只依赖关键词。两篇论文都提到“检索增强生成”,不代表它们解决的是同一个问题;两项工作使用完全不同的术语,也可能采用了相同的技术机制。真正的判断需要拆解研究对象、核心假设、方法结构、训练信号、实验条件与结论,而不是计算标题和摘要有多相似。
语义相似度衡量的是两段文本表达得像不像,新颖性判断衡量的是后来的想法是否已经被早期工作实质性覆盖。 这是 NoveltyBench 与传统文本匹配任务之间最关键的区别,也是大模型最容易“自信地答错”的地方。
举个例子,一篇论文声称首次通过多个代理相互辩论来提高答案可靠性,而此前工作已经使用多个模型进行独立推理和投票。两者表面上都属于多代理推理,但“辩论过程是否允许动态交换论据”“最终答案如何聚合”“训练阶段是否显式优化争论策略”,都可能决定新工作是简单改名、工程扩展,还是具有实质贡献。
NoveltyBench测的不是单一能力
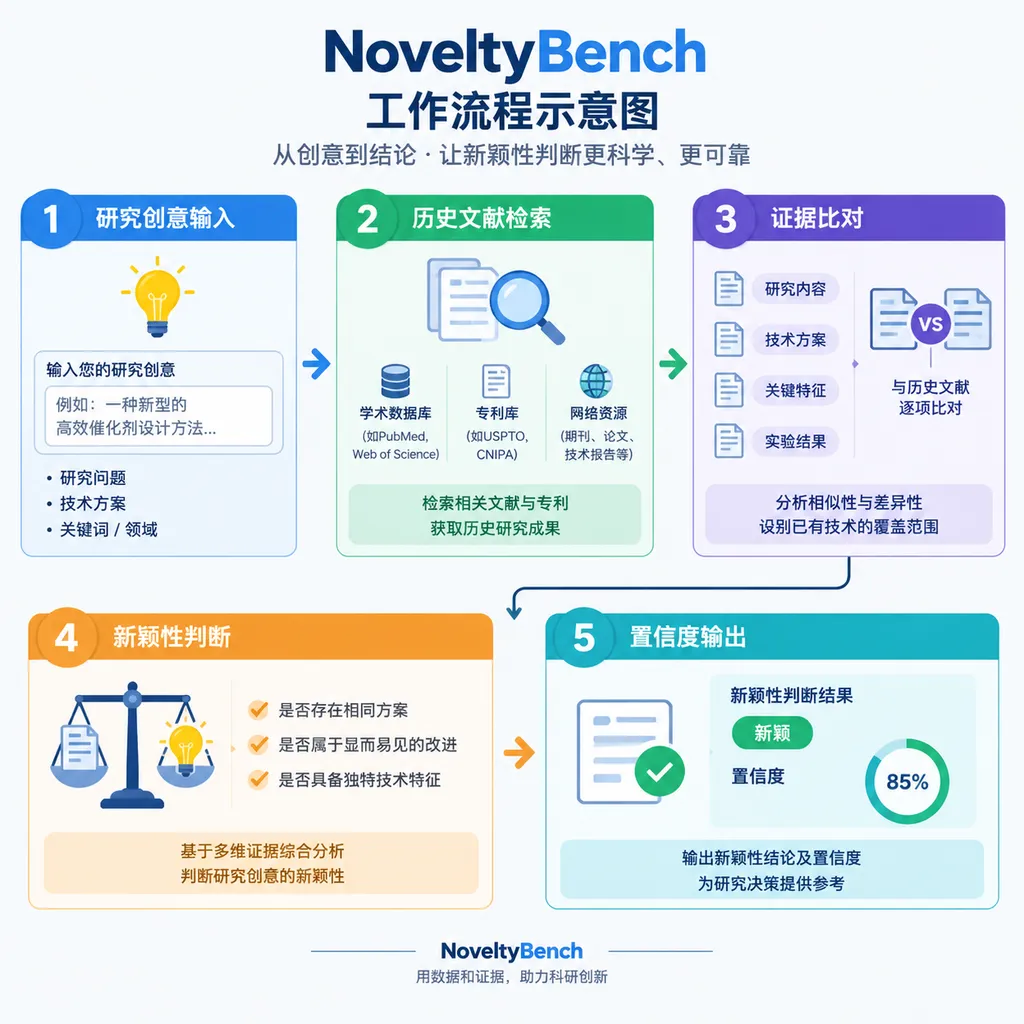
可靠的新颖性判断至少包含文献检索、技术比较、时间约束、证据引用和置信度校准五项能力。 任何一项缺失,都可能让最终的“新颖”或“不新颖”结论失去可信度。
第一项是 prior-art retrieval,也就是既有工作检索。模型需要找到真正可能构成先例的论文,而不只是返回主题相关的热门文章。对于长尾方向,最关键的前序工作可能引用量很低、标题措辞不同,甚至来自另一个学科。
第二项是 contribution matching,即贡献点比对。模型必须回答“此前论文究竟覆盖了新想法的哪一部分”,而不是看到几个共同术语就宣布重复。高质量判断通常要区分问题新颖性、方法新颖性、数据新颖性、实验新颖性和结论新颖性。
第三项是时间一致性。判断某个 2024 年提出的想法时,系统原则上只能使用当时已经公开的材料。若检索结果混入 2025 年论文,模型即使给出正确结论,也属于使用未来信息作弊。
第四项是证据可追溯性。一个模型说“类似工作早已存在”没有太大价值,它必须指出对应论文、具体段落或核心机制,并解释这些证据为何足以推翻新颖性主张。
第五项是校准与弃权。研究边界往往存在灰区,可靠系统应当在证据不足时输出“不确定”,而不是被迫生成一个二元结论。对编辑、审稿人和研究团队来说,知道模型什么时候不可信,往往比平均准确率再高几个百分点更重要。
这不是另一个同名的多样性基准
此次 Ai2 讨论的 NoveltyBench 不应与此前用于评估语言模型输出多样性的同名项目混淆。 后者研究的是一个模型面对同一提示能否连续产生多个有意义且不重复的答案,而此次发布聚焦的是研究创意及其既有文献证据。
公开资料中的同名多样性基准包含 1,100 条提示,其中 NB-Curated 有 100 条人工设计提示,覆盖随机性、事实知识、创意写作和主观问题;NB-WildChat 则包含 1,000 条来自真实用户交互的提示。它使用 distinct10 和 utility10 等指标,观察十次生成中有多少答案真正不同,以及有多少答案同时满足“有用”和“对读者来说是新的”。
两个项目都在讨论 novelty,但问题并不相同:前者问“模型能否产生不重复的好答案”,此次 Ai2 的工作问“模型能否判断一个研究创意此前是否已经存在”。如果只搜索 NoveltyBench 这个名字,很容易把两套数据、指标和结论混为一谈。
| 项目 | 核心问题 | 主要评估对象 | 已公开规模或特征 | 不能回答的问题 | |---|---|---|---|---| | Ai2 此次 NoveltyBench | LLM 能否判断研究创意是否新颖 | 创意、既有论文与判断证据 | 强调文献依据、时间边界与可靠性 | 不能直接证明模型会生成更好的研究创意 | | 同名多样性 NoveltyBench | 模型能否连续产生高质量且不同的回答 | 同一提示下的多次生成 | 1,100 条提示,含 100 条人工提示和 1,000 条真实交互提示 | 不能判断学术贡献是否已有先例 | | SchNovel | LLM 能否区分论文的新颖程度 | arXiv 论文对 | 15,000 对论文,以较新论文作为更“新颖”的近似标签 | 发表时间更晚不等于贡献一定更新 | | 传统语义相似度评测 | 两段文本是否表达相近内容 | 标题、摘要或句子对 | 通常使用相似度或匹配准确率 | 文本相似不等于技术贡献相同 |
这里值得特别关注 SchNovel 的标签设计。它将论文按时间组成 15,000 个配对,并假设后发表的论文更具新颖性,这种方法便于大规模构造数据,却只能提供弱监督信号。更晚发表的论文可能只是复现、扩展实验或重新包装已有技术,较早论文也可能包含后来才被广泛认识的突破。
NoveltyBench 所代表的方向,是从时间代理标签转向更细粒度的证据判断。 这比简单比较论文日期更接近真实评审,但也显著提高了标注、检索和验证成本。
LLM最容易犯的四类错误
大模型判断研究新颖性时,最大的风险不是完全不懂,而是给出结构完整、论证流畅却证据错误的结论。 这种错误比普通问答幻觉更危险,因为它很容易被包装成审稿意见或研究决策。
1. 把术语差异误认为方法差异
术语漂移会让模型漏掉实质相同的前序工作。 不同研究社区经常使用不同名字描述相近机制,例如 memory、external state、retrieval cache 和 episodic context 可能在特定论文中承担类似作用。只按关键词检索,会把同一想法误判为首次提出。
2. 把主题相似误认为贡献重复
主题重合并不能证明创新点已经存在。 两篇论文都研究长上下文,不代表它们在注意力机制、位置编码、缓存压缩或训练目标上没有实质区别。模型如果只读摘要中的高层描述,通常会高估重复程度。
3. 使用未来文献污染判断
未来信息泄漏会制造虚假的高准确率。 当模型凭训练记忆认出后来广为人知的方法,再回头判断早期想法时,它可能无法区分哪些知识在目标日期已经公开。对于训练语料和具体记忆边界不透明的闭源模型,这一问题尤其难审计。
4. 将“没有找到”写成“从未出现”
检索失败不能被等同于不存在先例。 文献数据库覆盖不全、论文尚未正式出版、术语跨学科变化以及非英文材料缺失,都会导致漏检。可靠系统应该说“在当前检索范围内未找到”,而不是断言“这是首个此类研究”。
单看模型名字没有意义
判断一套系统是否可靠,不能只看它使用了哪个基础模型。 同一个 LLM 在闭卷回答、给定候选论文、接入学术搜索和加入证据验证器时,表现可能完全不同。
| 系统形态 | 能做什么 | 主要优势 | 主要风险 | 适合场景 | |---|---|---|---|---| | 闭卷 LLM | 依赖参数记忆直接判断 | 快、成本低 | 知识过时、来源不可核验、时间污染 | 头脑风暴后的粗筛 | | 搜索增强 LLM | 先检索论文再比较 | 能覆盖较新的公开工作 | 检索结果可能漏召回或排序偏置 | 选题初查、相关工作整理 | | 检索加证据验证 | 对候选论文逐项核对贡献 | 结论更可追踪 | 流程更慢,仍依赖文献覆盖 | 投稿前内部审查 | | 人类专家加 LLM | AI 检索归纳,专家最终判断 | 兼顾效率与领域知识 | 成本较高,专家也可能存在偏见 | 正式同行评审、资助评估 |
这也是 NoveltyBench 最值得行业重视的一点:它评估的不是“模型记住了多少论文”,而是模型能否完成一条可验证的判断链。对于实际产品,检索覆盖率、文献时间过滤、引用定位和弃权策略,可能比基础模型在通用榜单上的名次更重要。
它有用,但还不是AI审稿人许可证
NoveltyBench 适合成为研究辅助系统的压力测试,却不应被视为让 LLM 独立审稿的许可证。 新颖性本身也只是论文价值的一部分,研究还要考虑技术正确性、实验充分性、结论重要性、可复现性和伦理风险。
对研究人员而言,这类系统最现实的用途是投稿前的“反向尽调”。团队可以把论文的核心贡献拆成若干可检验主张,让模型分别搜索可能的先例、列出最相近工作,并要求它说明重合点和差异点。最终决定仍应由作者和领域专家完成,但 AI 可以显著扩大初步检索范围。
对会议和期刊而言,更合理的定位是审稿辅助。模型可以标记需要重点核查的 novelty claim,帮助审稿人发现跨领域相关工作,但不应直接生成决定性分数。尤其在小众方向,审稿人的隐性知识、实验经验和对社区历史的理解仍难以被公开文献完全替代。
对科研创意产品而言,NoveltyBench 还提出了一个更尖锐的问题:如果产品既负责生成创意,又使用相似模型给创意打分,就可能形成自我偏好闭环。模型容易偏爱符合自身表达习惯、训练分布和推理模板的方案,把“自己不常生成的内容”误认为新颖,把“自己熟悉的表述”误认为可靠。
生成器与评审器的相关性偏差,是 AI 科研系统下一阶段必须解决的问题。 可行办法包括使用不同模型交叉评审、引入独立检索器、隐藏作者与模型来源、加入反例搜索,以及保留人类专家对高价值创意的最终裁决权。
真正该看的不是总分,而是失败分布
NoveltyBench 后续最有价值的数据,将是模型在哪些学科、哪些年份和哪些证据条件下失效。 一个平均分不错的模型,可能在机器学习热门方向表现很好,却在计算生物学、材料科学或跨学科主题上频繁漏掉先例。
评估报告至少应该同时披露以下信息:
- 按研究领域拆分的检索召回率与判断准确率;
- 严格时间截断下的表现,而不是允许使用所有已知论文;
- 有证据与无证据条件之间的差距;
- 对改写、术语替换和无关论文干扰的鲁棒性;
- 置信度与实际正确率是否匹配;
- 模型选择弃权时,是否真的集中在困难样本上;
- 引用的论文是否真实存在,是否真正支撑结论;
- 面对部分新颖、增量创新和跨领域迁移时的细粒度表现。
如果一个系统只能输出二元标签和总准确率,它对真实科研流程的帮助仍然有限。研究人员真正需要的是:哪一部分不新、最接近的先例是什么、差异是否足以构成贡献,以及当前判断还缺哪些证据。
OpenAI Hub观点
NoveltyBench 的方向是对的,因为它开始评测 AI 科研工具最容易被忽视的“否证能力”。 生成一个听起来新颖的想法并不难,困难的是主动搜索反例、承认已有工作、识别证据不足,并在不确定时拒绝下结论。
现阶段,把 LLM 当作“文献检索员加质疑者”是合理的,把它当作“创新性法官”则过于激进。模型可以降低查找相关工作的时间成本,也能帮助作者发现措辞过度的首次性声明,但它尚不能稳定处理隐性技术等价、跨领域先例和时间污染。
对开发者来说,NoveltyBench 最重要的信号不是某个模型赢了,而是新颖性评估必须被设计成一套可审计系统。 检索结果、时间范围、证据片段、比较维度和不确定性都应被显式记录。没有这些环节,再强的 LLM 也只是在给一个主观印象配上专业语气。
参考来源
- Ai2:Can we trust LLMs to judge whether a research idea is novel? — NoveltyBench 官方介绍,讨论大语言模型评估研究创意新颖性的能力、基准思路与可靠性边界。