安卓编程榜:Argon掉队
谷歌更新 Android Bench,补充推理等级和调用成本。Claude Sonnet 5.5 通过率第一,GPT-6.1 Sol 性价比突出,Gemini 4 Argon 仅列第五。
谷歌把自家旗舰放上榜,结果只排第五
谷歌在 10 月 26 日更新了 Android Bench 安卓编程模型榜单,新增模型推理等级与平均调用成本,并首次公布 GPT-6 Sol、GPT-6.1 Sol、Claude Sonnet 5、Claude Sonnet 5.5 和 Gemini 4 Argon 等模型的测试结果。
Android Bench 是谷歌面向 Android 开发场景建立的 AI 编程能力基准,重点测试模型能否按照 Android 平台规范与最佳实践完成真实开发任务。它不只是检查代码能不能编译,还会涉及项目结构、界面实现、状态管理、平台 API 使用和任务交付完整度,因此比通用代码问答榜单更接近 Android 开发者日常面对的工程问题。
这次更新最醒目的结果不是 Claude 再次领先,而是谷歌自家的 Gemini 4 Argon 只排在第五位。Argon 的通过率为 21.3%,完成率为 81.8%,榜单所列平均调用成本达到 267.70 美元,明显落后于 Claude Sonnet 5.5 和 GPT-6.1 Sol,甚至没有超过定位更低的 Claude Fable 5.1。
这是一份对谷歌并不体面的榜单,但也因此更有参考价值。厂商愿意在自己的专项基准里公开自家旗舰模型的失利,至少说明 Android Bench 暂时没有被包装成一张只服务发布会叙事的成绩单。
Claude 拿下最高通过率,GPT-6.1 Sol 赢在成本
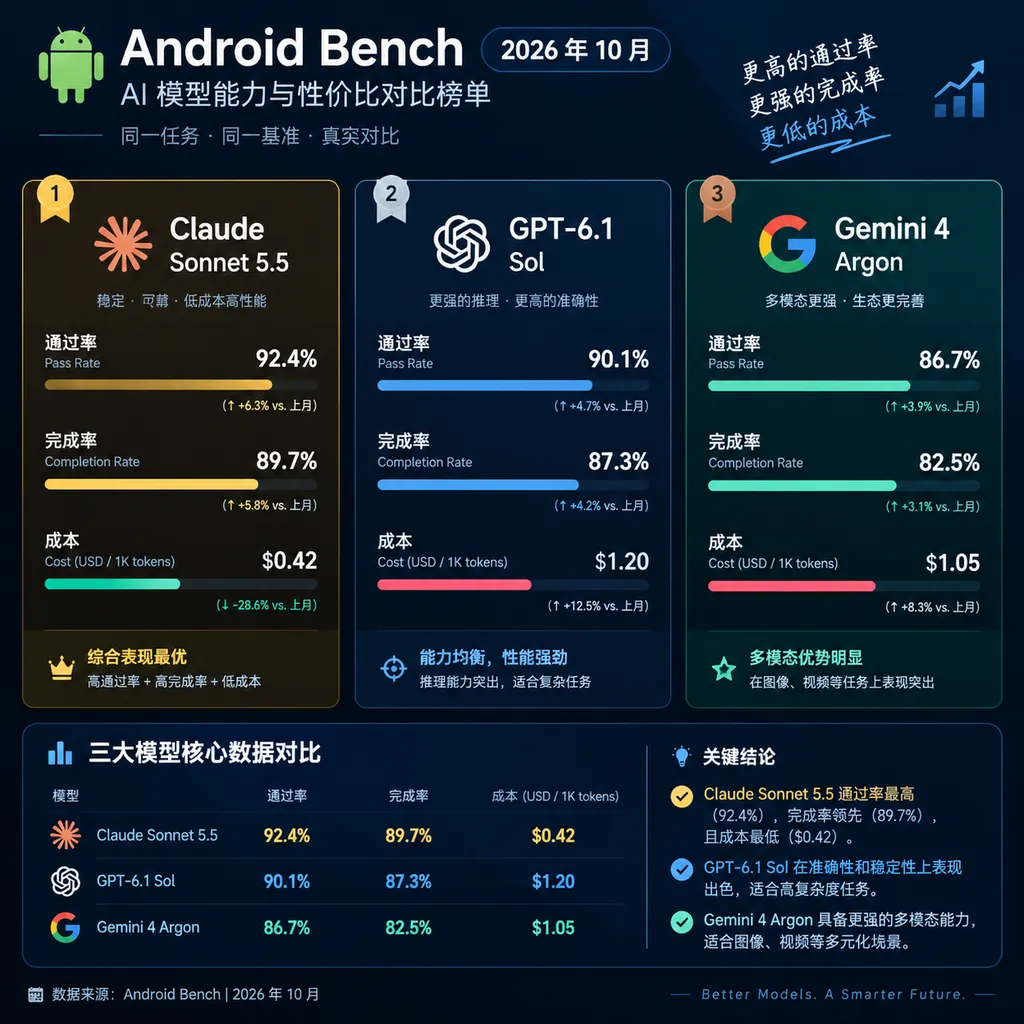
Claude Sonnet 5.5 是本轮 Android Bench 的第一名,通过率达到 40%,完成率为 80.9%。10 月初进入榜单的 Claude Opus 5.5 位居第二,Anthropic 因而占据了榜单前两席。
通过率是指模型提交的解决方案最终满足测试要求并通过验证的比例,它反映的是任务有没有真正做对。完成率是指模型是否走完任务流程并给出可交付结果的比例,它更接近模型是否愿意并能够把工作做完,但完成并不等于正确。
两项数据放在一起看,信息量远高于只看一个总分。Claude Sonnet 5.5 的完成率为 80.9%,并不是新增模型中最高的,但其通过率达到 40%,说明它交出的结果更容易被测试系统接受;GPT-6.1 Sol 的完成率达到 82.8%,比 Claude Sonnet 5.5 高 1.9 个百分点,但通过率只有 29.3%,低了 10.7 个百分点。
这组差异可以简单理解为:GPT-6.1 Sol 更经常把任务跑到终点,Claude Sonnet 5.5 则更经常把终点跑对。对于自动化编程代理来说,前者意味着较少中断,后者意味着较少返工,二者对应的是不同的工程成本。
| 模型 | Android Bench 排名/位置 | 通过率 | 完成率 | 榜单平均调用成本 | 主要判断 | |---|---:|---:|---:|---:|---| | Claude Sonnet 5.5 | 第 1 | 40.0% | 80.9% | 1,574.90 美元 | 正确率最高,但成本极高 | | Claude Opus 5.5 | 第 2 | 参考资料未披露 | 参考资料未披露 | 参考资料未披露 | 仍处第一梯队 | | GPT-6.1 Sol | 前列 | 29.3% | 82.8% | 99.50 美元 | 本轮性价比最突出 | | Claude Fable 5.1 | 高于 Argon | 参考资料未披露 | 参考资料未披露 | 参考资料未披露 | 定位较低但仍压过 Argon | | Gemini 4 Argon | 第 5 | 21.3% | 81.8% | 267.70 美元 | 完成率尚可,通过率偏低 |
GPT-6.1 Sol 是这次更新里最值得开发团队关注的模型,因为它把通过率、完成率和成本放在了相对平衡的位置。其榜单平均调用成本为 99.50 美元,仅相当于 Claude Sonnet 5.5 的约 6.3%,后者成本是它的 15.8 倍。
Gemini 4 Argon 的成本也没有形成优势。Argon 的 267.70 美元约为 GPT-6.1 Sol 的 2.69 倍,但通过率低了 8 个百分点;Claude Sonnet 5.5 的成本虽然又是 Argon 的约 5.88 倍,却换来了 18.7 个百分点的通过率提升。
如果粗略用“每个通过率百分点对应的榜单成本”观察,GPT-6.1 Sol 约为 3.40 美元,Gemini 4 Argon 约为 12.57 美元,Claude Sonnet 5.5 则约为 39.37 美元。这不是严格的采购指标,因为通过率与成本并非线性关系,但它足以说明:Claude 在追求上限,GPT-6.1 Sol 在守住经济性,Argon 暂时卡在一个尴尬的中间位置。
推理等级终于被写进榜单
推理等级是运行模型时分配给内部思考过程的计算强度档位,它通常会同时影响正确率、响应时间、Token 消耗和最终账单。同一个模型在低推理与高推理配置下,表现可能像两个不同版本,因此不注明推理等级的排行榜很容易产生误导。
Android Bench 这次补充推理等级,是比新增几款模型更重要的改动。过去只列模型名称,会让读者误以为比较的是模型本身;实际上,基准测试比较的往往是“模型、推理预算、工具环境、提示词与代理脚手架”的组合。
高推理等级并不是免费的性能开关。它通常意味着模型会生成更多内部推理 Token、发起更多工具调用,或者在失败后进行更多轮修正,因此可能把一次原本几分钟、几美元的任务拉长到数十分钟乃至更高成本。
平均调用成本是完成整套测试或标准化任务时统计出的模型使用费用,用于衡量获得某一成绩需要付出多少推理资源。它比厂商标注的每百万 Token 单价更接近真实工程支出,因为编程代理会反复读取代码、执行构建、分析错误并修改文件,账单取决于整条任务轨迹,而不是一次对话的报价。
不过,Android Bench 的成本数字仍不能直接等同于企业落地成本。缓存命中率、上下文长度、失败重试、构建环境、并行任务数量和代理框架都会改变最终支出,榜单更适合做横向筛选,而不是直接拿来编制预算。
Argon 为什么在综合榜很强,却在 Android 上掉队
Gemini 4 Argon 是谷歌面向长周期软件工程、企业知识工作和网络安全任务推出的旗舰模型,其核心卖点是更长的任务轨迹、更大的输出空间和复杂工具协作能力。它在 DeepSWE v1.1 上取得过 77.9%的成绩,在 CWE-bench v1 漏洞修复测试中达到 68%,并在部分企业自动化与长视频理解测试上领先竞争对手。
Android Bench 的第五名并不能证明 Argon 编程能力差,却证明它的能力分布很不均匀。一个模型擅长跨文件重构、长程规划和漏洞分析,不代表它能稳定处理 Android 生命周期、Gradle 配置、Jetpack Compose 状态、权限模型和平台兼容性等高度具体的问题。
专项基准与综合基准之间出现明显落差,通常有三个原因:
- 任务知识不同。 DeepSWE 更强调长周期代码修改,Android Bench 更强调平台规范和移动端最佳实践。
- 工具链不同。 Android 项目依赖 Gradle、模拟器、SDK 版本与构建日志,代理是否能正确使用这些工具,会直接影响结果。
- 失败标准不同。 综合基准可能按部分完成度给分,Android Bench 的通过判定更可能要求应用构建、运行和行为同时正确。
Argon 的 81.8%完成率进一步说明,它并不是无法执行任务,而是“做完了但没完全做对”的比例偏高。其完成率只比 GPT-6.1 Sol 低 1 个百分点,却在通过率上低了 8 个百分点,这更像是最后一公里的可靠性问题,而不是基础执行能力崩溃。
最后一公里恰恰是生产环境最昂贵的部分。一个模型可以生成数千行看似完整的代码,但只要导航状态丢失、后台任务违反系统限制,或者依赖版本无法解析,开发者就必须接手排错;这类返工不会完整体现在模型报价里,却会吞掉工程师时间。
“通过率 40%”也说明所有模型都还不够稳
Android Bench 第一名只有 40%的通过率,意味着当前最强模型面对这套任务时,仍有约六成任务无法一次满足测试要求。排行榜上的第一名并不等于可以无监督接管 Android 项目,更合理的定位仍是具备工具操作能力的高级编程助手。
完成率普遍超过八成、通过率却远低于五成,是当前编程代理的典型状态。模型已经很会规划、写代码和解释修改,也很少直接拒绝任务,但它们仍会在依赖、边界条件、平台约束和验证环节出错。
开发团队不应只按最高分选择模型。对于代码评审严格、错误代价高的核心应用,Claude Sonnet 5.5 的高通过率可能值得额外成本;对于大量原型、内部工具和可自动重试的任务,GPT-6.1 Sol 更合理;对于长上下文分析、安全审查或跨仓库任务,Argon 依然值得单独测试,但不应因为综合跑分领先就默认它最适合 Android。
更现实的做法是建立团队自己的小型回归集。开发者可以从历史缺陷、常见需求和构建失败案例中抽取 20 至 50 个任务,分别记录一次通过率、人工修改时间、总耗时和实际费用,再决定默认模型与升级策略。
谷歌这次更新,真正改变的是选型方法
Android Bench 把推理等级和成本放到同一张榜单后,模型竞争开始从“谁的分最高”转向“谁能以合理成本稳定完成任务”。这是编程模型进入生产环境后必然发生的变化,因为企业最终购买的不是跑分,而是可预测的交付结果。
Claude Sonnet 5.5 证明高预算仍能换来更好的任务正确率,但 1,574.90 美元的榜单成本决定了它更像高价值任务的强力选项,而不是所有工作负载的默认答案。GPT-6.1 Sol 则用 99.50 美元拿到 29.3%通过率与 82.8%完成率,表现出更强的规模化部署潜力。
Gemini 4 Argon 的问题不是完全不能用,而是暂时缺少一个足够有说服力的 Android 场景定位。它比 GPT-6.1 Sol 更贵、通过率更低,又没有像 Claude Sonnet 5.5 那样用明显更高的正确率证明高成本合理,这种上下都够不到的状态,比单纯排名第五更值得谷歌警惕。
谷歌仍有机会通过专门训练、改进 Android 工具调用和调整代理脚手架追回差距。Android 是谷歌自己的平台,官方文档、代码样本、构建工具和测试环境都在其生态内,如果 Argon 长期无法在这一专项上进入第一梯队,问题就很难再归因于数据不足。
截至 2026 年 10 月 28 日,这份榜单给开发者的最直接结论是:追求最高一次通过率可优先测试 Claude Sonnet 5.5,追求成本与完成能力的平衡应重点关注 GPT-6.1 Sol,而 Gemini 4 Argon 需要用真实 Android 项目证明自己,而不是继续依靠综合基准背书。
参考来源
- IT之家:谷歌更新 Android Bench 榜单,自家 Gemini 4 Argon 编程能力落后于 Claude 与 GPT —— 汇总 10 月 26 日榜单更新、模型通过率、完成率与平均调用成本数据。