AI报税,先过这50道真题
Surge AI 发布 Dayjob: Tax,用50项真实专业税务任务评测AI Agent。它不考税法背诵,而是检查Agent能否在杂乱材料、复杂规则和严格交付标准下完成整项工作。
Surge AI 把 AI Agent 拉进了真实税务工作流
Surge AI 于 2026 年 10 月 28 日发布 Dayjob: Tax,以 50 项专业税务任务评测 AI Agent 能否完成真实工作,而不是只回答几道税法问题。
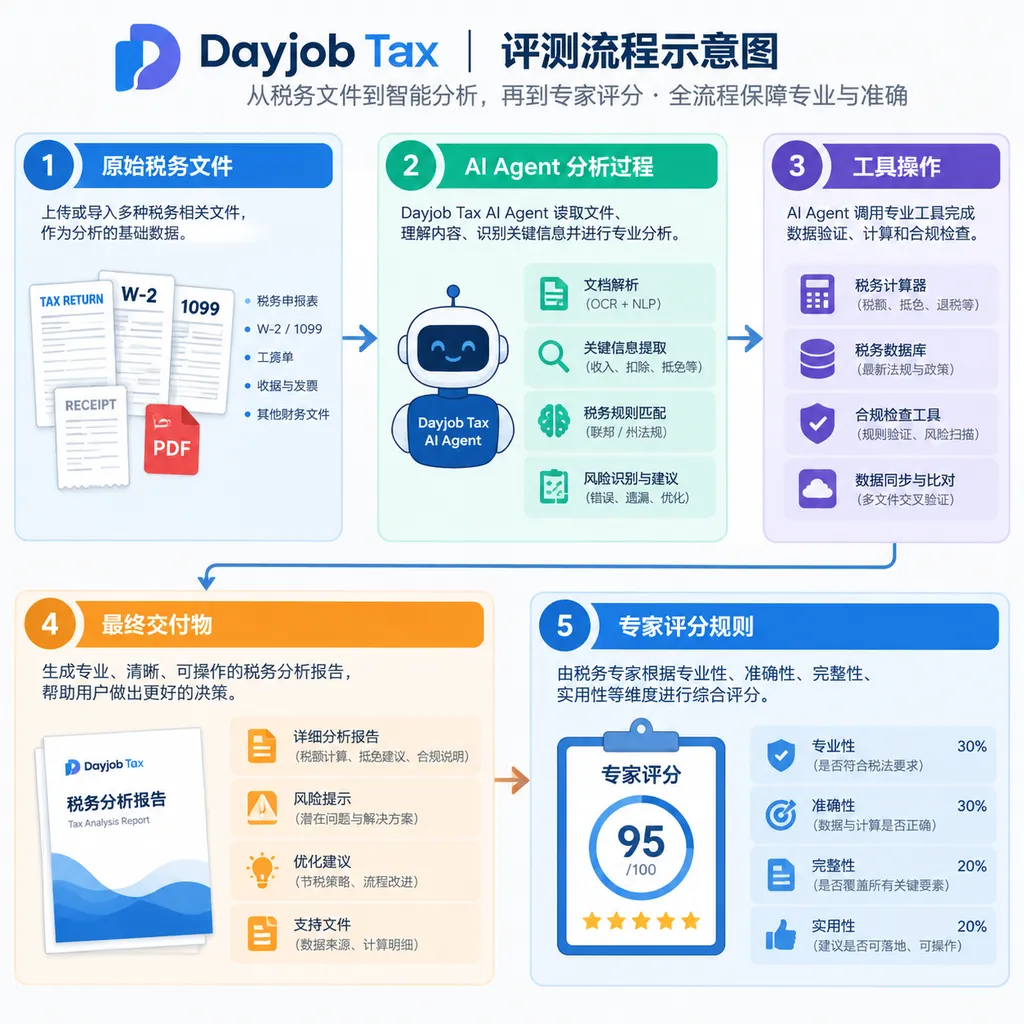
Dayjob: Tax 是一套面向税务职业场景的 AI Agent 评测基准,核心目标是衡量模型处理完整税务任务的能力,包括阅读材料、识别适用规则、执行计算、形成判断并交付可审查的结果。
这套基准值得关注,不是因为税务又多了一个模型跑分,而是它把问题从“模型懂不懂税法”改成了“模型能不能像税务从业者一样把事情做完”。前者可以靠记忆法规和单轮推理拿分,后者则要求 Agent 在长时间、多文件、多约束的环境里持续保持一致,而且任何一个小错误都可能让最终成果不可用。
Dayjob: Tax 的 50 项任务更接近事务所内部真正会下发的 assignment,而不是考试中的标准化选择题。
按照 Surge AI 对 DAYJOB 系列的设计思路,任务由具有一线经验的专业人士编写,材料、判断过程和交付物都来自实际工作。每项任务还要经过正确性、完整性和可解性审查,避免出现“专家自己也说不清标准答案”的伪真实题目。
它考的不是税法背诵,而是工作闭环
真实税务工作的难点通常不在某一条法规,而在于能否把分散事实、适用期间、主体身份和申报要求拼成一个闭环。
一项税务任务可能同时包含客户邮件、历史申报表、工资记录、银行流水、资产明细、实体结构文件和补充说明。Agent 不仅要抽取数字,还要判断哪些文件属于当前纳税年度、哪些信息已经被后续材料覆盖,以及不同来源之间是否存在冲突。
税务任务中的“检索正确”并不等于“结论正确”。
模型可能准确找到一条税务规则,却把它应用在错误的纳税主体、错误的司法辖区或错误的会计期间;也可能算对单个数字,却遗漏数字之间的勾稽关系。对于一般问答,这类错误可能只会让回答扣几分;对于正式税务交付,它可能导致整份工作底稿无法进入复核流程。
Dayjob: Tax 真正测量的是 Agent 从输入材料到最终交付状态的端到端可靠性。
一个完整任务通常可以拆成五层能力:
- 材料定位:从多份文件中找出相关凭证、数字与背景事实;
- 事实归并:识别同一实体、同一交易或同一资产在不同材料中的表述;
- 规则适用:判断税法条款、门槛、期限和例外条件是否适用;
- 计算与核验:完成税额、抵扣、折旧或调整项目计算,并检查前后勾稽;
- 成果交付:按照指定格式生成工作底稿、说明、表格或可供复核的结论。
这五层能力必须同时成立。只会搜索法规的模型会卡在事实归并,只会操作表格的模型会卡在规则适用,而擅长生成文字但不做核验的模型,往往会交付一份“看起来很专业、实际上不能签字”的文件。
50项任务,比50道税法题难得多
专业任务数量只有 50 项,并不意味着 Dayjob: Tax 是一个小型评测。
传统知识测试通常把一道题压缩成几百字上下文和一个明确问题,而职业任务的输入可能由数十份文件构成,任务周期也可能相当于专业人士数小时甚至数天的工作。决定评测难度的不是题目数量,而是每项任务内部包含多少事实、决策节点、工具操作和验收条件。
DAYJOB 系列此前公开的数据说明了这种任务密度。
在更早发布的 DAYJOB: Finance 与 DAYJOB: Healthcare 中,金融任务平均包含 25.7 个输入文件,医疗任务平均包含 19.8 个输入文件;作为对照,GDPval 平均只有 1.2 个输入文件。DAYJOB 金融任务的评分规则中位数为 57.5 项,医疗任务为 47.5 项。
| 评测 | 主要对象 | 输入环境 | 评分方式 | 主要考察点 | |---|---|---|---|---| | Dayjob: Tax | 税务工作 Agent | 多文件、专业规则、完整交付物 | 按任务专属标准逐项核验 | 税务判断、计算、证据链与交付完整性 | | DAYJOB: Finance | 金融职业 Agent | 平均 25.7 个输入文件 | 中位数 57.5 项标准 | 多文档分析与金融工作成果 | | DAYJOB: Healthcare | 医疗职业 Agent | 平均 19.8 个输入文件 | 中位数 47.5 项标准 | 医疗材料分析与专业交付 | | GDPval | 通用高经济价值职业任务 | 平均 1.2 个输入文件 | 专家比较与任务评分 | 模型完成职业任务的总体价值 | | 常见税务问答集 | 单轮语言模型 | 短文本、明确问题 | 答案是否匹配 | 税法知识和局部推理 |
Dayjob: Tax 相比普通税务问答最大的进步,是把“交付物能否使用”放到了“回答是否像样”之前。
税务行业并不缺能够解释概念的聊天机器人,真正稀缺的是能把原始材料转成可靠工作成果的系统。事务所需要的不是一段关于折旧规则的流畅说明,而是一份数字正确、期间正确、引用依据明确、异常项已标记并且能由复核人追溯的工作底稿。
严格评分会让Agent的成功率看起来很低
DAYJOB 的评分逻辑接近现实中的验收清单:任务只有满足全部关键条件,才可能被视为完整通过。
这种评分方式比平均得分更残酷,但也更符合税务工作的风险结构。如果一项任务包含 50 个相互独立的验收条件,而 Agent 在每个条件上的正确率都是 97%,整项任务全部正确的理论概率只有约 21.8%,计算方式是 0.97 的 50 次方。
单点准确率达到 97%,并不代表 Agent 已经可以无人监督地接管完整税务流程。
这个反直觉结果解释了为什么 Agent 在局部测试中显得非常聪明,进入真实工作环境后却频繁失败。长流程会放大错误:一次实体识别错误可能污染后续计算,一次期间判断错误可能让所有引用失效,一个遗漏附件也可能使交付物无法复核。
DAYJOB 此前的公开结果已经展示了这一落差:Healthcare 中最强模型的任务成功率为 24.7%,Finance 中最强模型为 23.9%。这些成绩不能直接当作 Dayjob: Tax 的最终榜单,但它们为理解新税务评测提供了基线——当前一线模型可以完成相当多局部步骤,却仍然难以稳定完成整项专业工作。
Dayjob: Tax 的价值不在于制造一个更难看的排行榜,而在于定位 Agent 究竟在哪里失手。
如果模型总是在材料筛选阶段出错,问题可能是上下文管理和文档检索;如果计算正确但说明不完整,问题可能是交付模板与自检机制;如果模型能找到规则却频繁用错期间,问题则是任务状态和时间信息没有被结构化保存。只有把失败拆到具体环节,开发团队才知道应该改模型、改工具还是改工作流。
税务是检验Agent可靠性的高压场景
税务是 AI Agent 最有商业价值、也最不适合盲目追求全自动化的行业之一。
税务工作具有明显季节性,基础数据整理、表格填充和一致性检查又占据大量人力,因此自动化收益很直接。行业实践中,税务 AI 工具常被用于读取文档、验证字段、整理申报材料,并与 CCH Axcess、UltraTax、Lacerte、Drake 等既有税务软件衔接。
税务 Agent 的商业收益主要来自压缩准备时间,而不是替代最终责任人。
部分早期产品给出的行业数据称,常规任务时间可以减少 75% 至 90%,复核周期可缩短 30% 至 50%。这些数字来自具体产品和客户案例,不能直接外推到所有事务所,但它们说明了一个现实方向:Agent 即使无法独立签字,只要能可靠完成材料整理、初步计算和异常标记,就已经能够释放大量专业工时。
税务 Agent 的风险也比普通办公自动化更集中。
错误税额、遗漏抵扣、错误实体归类或不恰当的规则引用,都可能带来罚款、客户损失和职业责任。与此同时,税务材料通常包含身份证明、收入、银行账户和企业交易等高敏感数据,这要求产品同时解决权限控制、数据驻留、操作日志、版本追踪和人工审批问题。
因此,Dayjob: Tax 不应该被理解成“AI 会不会报税”的单一测试。它更像一次压力测试:当任务变长、文件变多、规则变细、错误成本变高时,Agent 的推理能力、工具能力和工程可靠性还能剩下多少。
Benchmark 也有边界,不能把分数当生产结论
Dayjob: Tax 的分数不能直接等价为某个产品在事务所里的自动化率。
基准测试通常拥有固定环境、明确任务起点和预先设计的验收标准,而现实工作还包含客户追问、材料缺失、法规更新、地区差异、内部政策和责任分工。一个模型在 50 项任务中表现领先,只能证明它更擅长完成这组受控任务,不能证明它可以脱离专业人员运行。
任务专属评分规则也可能奖励“完成清单”,却低估专业判断中的不确定性表达。
优秀税务人员不仅要给出结论,还要知道什么时候不能下结论。Agent 若在证据不足时主动升级给人工,生产价值可能高于一个强行生成完整答案的模型;但如果评测只检查最终字段是否填满,谨慎行为反而可能吃亏。因此,未来榜单最好同时报告任务完成率、关键错误率、升级决策准确率和证据可追溯性。
不同版本来源中的统计口径也需要开发者谨慎核对。
关于早期 DAYJOB 任务所需的人类工时,论文版本与官方介绍曾出现不同平均值:相关分析引用的论文数字为医疗 13.6 小时、金融 16.6 小时,而官方介绍使用过医疗 19.6 小时、金融 21.6 小时。口径差异不影响任务复杂这一结论,但比较模型效率时必须注明采用哪个版本。
对Agent团队来说,最该抄的是评测方法
Dayjob: Tax 对开发团队最大的启发,是不要再用一次回答的观感评估专业 Agent。
一个可进入生产环境的税务 Agent,至少需要四类评测:
- 结果评测:最终数字、表格和说明是否正确;
- 过程评测:是否使用了正确材料、规则和计算路径;
- 安全评测:是否越权访问数据,是否在证据不足时编造结论;
- 稳定性评测:同一任务重复运行时,结果能否保持一致。
企业部署 Agent 时也应该把完整任务拆成可验证的短链路。
让模型一次性处理全部客户材料、计算税额并生成最终申报,是最容易出现复合错误的做法。更现实的路径是让 Agent 先完成文件分类、字段提取和一致性检查,再处理规则匹配与计算,最后由独立检查器和人工复核交付物。
当前最合适的产品形态仍然是“Agent 准备、专业人员复核”,而不是无人值守的全自动税务代理。
Dayjob: Tax 很可能会加速模型厂商宣传口径的变化。过去厂商喜欢展示模型能回答多少专业问题,接下来更有价值的指标会是:完整任务通过率是多少、关键错误率是多少、平均需要多少次人工介入、每次任务成本和耗时是多少。
AI会做题,与AI能工作之间仍有距离
Dayjob: Tax 给出的核心判断很明确:专业知识只是职业 Agent 的入场券,可靠交付才是终点。
在税务场景里,Agent 需要面对的不是干净数据和唯一答案,而是互相矛盾的材料、不断变化的事实、严格的时间边界以及必须承担后果的最终成果。模型可以在每一个局部步骤上都表现优秀,却因为一个遗漏让整项任务失败。
这套基准短期内不会证明 AI 已经可以取代税务专业人员,但会更准确地告诉行业哪些工作可以交给 AI。
材料归档、字段提取、基础计算和异常检测已经适合被 Agent 承担;涉及模糊事实、复杂实体结构、重大金额和解释空间的判断,仍然需要专业人员负责。真正成熟的税务 AI 产品,不是把人从流程中删掉,而是把人的注意力从机械处理转向例外判断与最终责任。
Dayjob: Tax 因而不只是一个税务排行榜。它代表了 Agent 评测正在从“模型能说什么”转向“系统能交付什么”,也提醒所有开发者:在真实工作里,97% 的局部正确率可能仍然只对应约两成的完整任务成功率。
参考来源
- 知乎:AI Agent Benchmark & Evaluation:整理真实职业任务、多步规划、工具调用和高可靠性等 Agent 评测方向,可用于理解 DAYJOB 在现有基准体系中的位置。
本文核心任务信息与 DAYJOB 系列统计来自 Surge AI 于 2026 年 10 月发布的官方介绍及其公开论文说明;受文末来源域名限制,未附非指定域名链接。