Qwen3.5里跑起一颗CPU
独立开发者用 Qwen3.5 实现了可重复执行的 RISC-V CPU 状态机。它更像一次可验证计算实验,而不是能替代芯片的语言模型处理器。
Qwen3.5 里跑起一颗 CPU,但别急着扔掉模拟器
**近日,独立开发者披露了 Qwenputer:一个借助 Qwen3.5 执行 RISC-V 指令、并追求确定性输出的实验性 CPU。**它不是阿里云或 Qwen 团队发布的新产品,也不是把 Qwen3.5 交叉编译到 RISC-V 硬件上,而是反过来让语言模型承担处理器的状态转换工作。
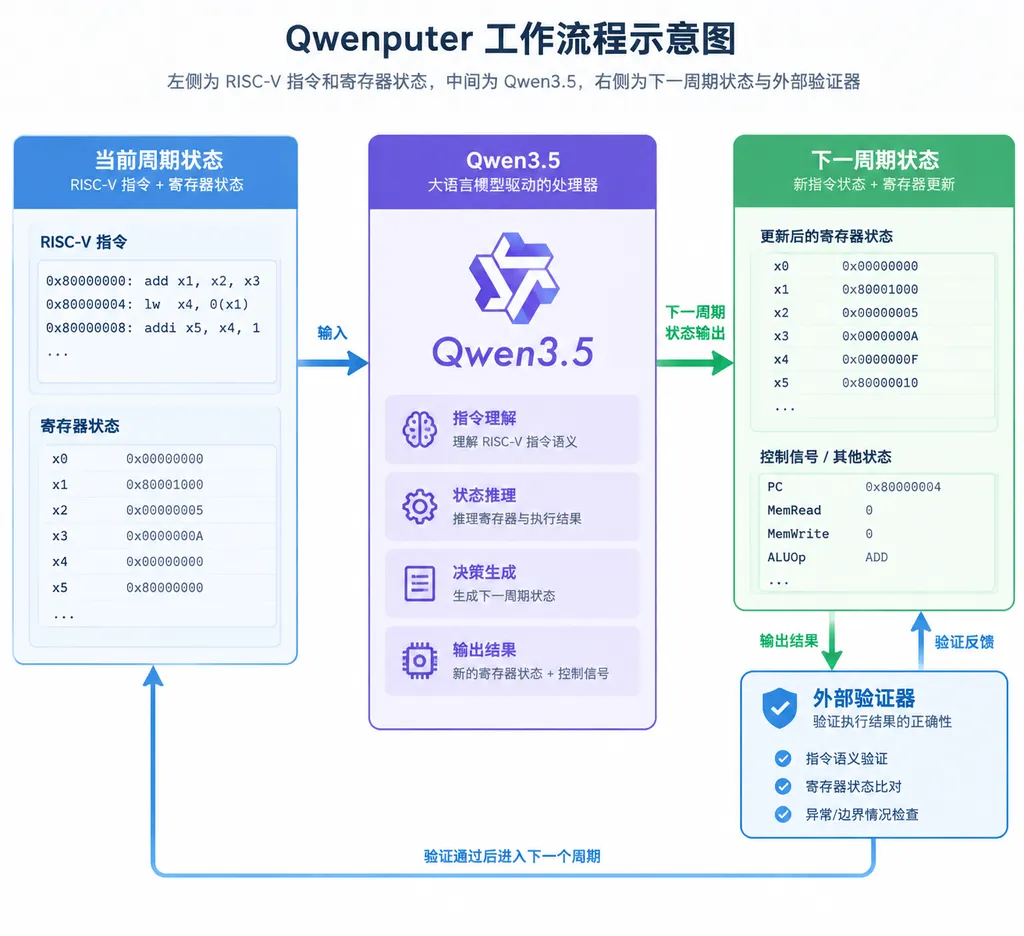
**Qwenputer 是一个把 RISC-V 机器状态交给 Qwen3.5、再由模型推导下一步状态的实验性计算系统。**按照作者的描述,这套系统能够读取指令、更新寄存器与内存状态,并让同一段程序按照预期路径运行;所谓“CPU 在 Qwen3.5 里面”,指的是模型参与了指令语义执行,而不是模型权重中真的出现了一块硅片。
这件事听上去像技术玩笑,但它触及了一个比“模型会不会写汇编”更重要的问题:语言模型能否从概率式文本生成器,变成一个输出可复现、过程可检查、错误可定位的计算部件?
答案目前是:能做出演示,也有研究价值,但离可验证计算机还很远。
这不是“在 RISC-V 上运行 Qwen3.5”
**Qwenputer 与“把 Qwen3.5 部署到 RISC-V 平台”是两个方向完全相反的问题。**前者让模型模拟 CPU,后者则让真实 CPU 执行模型推理;近期出现的 Qwen3.5-2B 交叉编译讨论属于后者,关注的是推理引擎、算子适配、内存占用和指令集优化,与本次实验没有直接关系。
**RISC-V 是一套开放指令集架构,而不是某一款具体处理器。**它定义加法、跳转、加载、存储等指令应当怎样改变寄存器和内存,却不强制厂商采用特定流水线、缓存或芯片设计。正因为基础整数指令的语义相对清楚,RISC-V 很适合拿来测试模型是否能稳定执行离散状态转换。
一颗最简化的处理器,可以抽象为下面几个部分:
- 程序计数器 PC:指出下一条要执行的指令;
- 通用寄存器:保存整数、地址和中间结果;
- 内存:保存程序与数据;
- 指令译码:判断当前指令是加法、跳转还是访存;
- 状态转换逻辑:根据指令产生新的 PC、寄存器和内存状态。
**Qwenputer 的关键思路,是把一次 CPU 执行拆成模型可以处理的结构化状态转换。**模型接收当前机器状态与指令,给出执行后的状态;系统再把新状态作为下一步输入,循环推进程序。只要每一步都遵守 RISC-V 语义,连续状态就构成了一次程序执行轨迹。
这和直接问模型“这段程序的结果是什么”有本质区别。后者允许模型跳步、猜答案甚至用自然语言圆回来;前者要求模型逐条更新寄存器、地址和控制流,一次错误就可能让后续所有状态偏离。
“确定性”是这次实验真正值得看的部分
**确定性计算是指相同初始状态和相同输入,按照固定规则执行后必须得到相同结果。**传统 CPU 的整数加法不会因为重复运行而随机变成另一个数,但语言模型的生成过程天然包含概率分布、采样参数和推理后端差异,因此“模型充当 CPU”首先要解决的不是速度,而是结果能否重复。
**把 temperature 设为 0,并不等于获得了数学意义上的确定性。**贪心解码通常会选择概率最高的下一个 token,但浮点精度、量化方式、并行归约顺序、推理框架、算子实现乃至模型版本,都可能改变两个接近候选项的排序。只要某一步输出变化,后续 CPU 状态就可能完全不同。
因此,Qwenputer 所展示的“deterministic”更适合被理解为:**在作者固定的模型、提示模板、解码方式和运行环境中,机器状态能够稳定复现。**这是一种工程上的可重复性,还不是硬件设计或形式化方法所要求的绝对确定性。
一个真正可复现实验,至少应固定以下内容:
- Qwen3.5 的具体模型名称、权重版本与文件哈希;
- tokenizer 版本及聊天模板;
- 完整 system prompt 和状态序列化格式;
- temperature、top-p、top-k 等解码参数;
- 推理引擎、量化格式与精度;
- GPU、CPU 及底层计算库版本;
- 每一步状态的外部校验规则。
**目前公开说明尚未给出足够完整的性能与覆盖率数据。**原始实验没有形成传统处理器评测所需的主频、每周期指令数、每秒指令数、功耗或完整合规测试结果,也没有用数字说明究竟覆盖了多少条 RISC-V 指令、执行了多少个测试程序、重复多少次后仍能保持一致。
这意味着外界现在能够确认的是“系统跑通了”,而不是“系统已被充分证明正确”。两者差别很大。
它和模拟器、代码解释器有什么区别
**传统 RISC-V 模拟器是用确定性程序实现指令语义,Qwenputer 则尝试让模型从上下文中完成相同的状态变换。**两者表面上都能执行指令,但工程属性几乎相反。
| 执行方式 | 核心机制 | 默认确定性 | 验证难度 | 执行效率 | 更适合的场景 | |---|---|---:|---:|---:|---| | 真实 RISC-V CPU | 晶体管电路执行指令 | 高 | 芯片级验证复杂 | 极高 | 生产计算、嵌入式设备 | | 软件模拟器 | 手写代码实现指令语义 | 高 | 可做单元测试与差分测试 | 中等 | 系统开发、调试、教学 | | 符号执行器 | 用逻辑表达式探索程序路径 | 高 | 可连接 SMT 求解器 | 较低 | 漏洞分析、形式化验证 | | 普通 LLM 推理 | 概率生成下一 token | 低 | 难覆盖全部行为 | 与 token 数相关 | 问答、代码生成、规划 | | Qwenputer 式系统 | LLM 推导下一机器状态 | 受环境约束 | 必须逐步外部校验 | 很低 | 研究、教学、验证实验 |
**Qwenputer 暂时没有性能优势。**真实 CPU 执行一条整数指令通常只需要若干纳秒,成熟模拟器也能每秒处理大量指令;语言模型却要把寄存器、内存和指令编码成 token,再完成一次或多次前向推理。即使模型推理只花几十毫秒,它与硬件之间也可能相差数百万倍。
**Qwenputer 也没有实现复杂指令语义的成本优势。**传统模拟器一旦正确实现一条 ADD 指令,之后每次执行都沿用同一段逻辑;语言模型则需要在每一步重新进行概率推断。程序越长、状态越大,上下文成本和错误累积就越明显。
它真正不同的地方在于泛化能力。传统模拟器只能执行开发者明确实现的语义,而模型可能同时理解汇编、自然语言约束、调试信息和程序意图。换句话说,它不是更好的 CPU,却可能成为更灵活的“执行解释层”。
会算对,不等于已经可验证
**可验证计算是指计算者能够提供证据,使验证者以更低成本确认结果正确。**这个概念比“模型回答对了”严格得多,因为验证者不能只看最终答案,还要排除模型碰巧猜中、跳过步骤或隐藏错误的可能。
假设一段程序执行 1000 条指令,模型在每一步出错的概率只有 0.1%,那么整段执行完全无错的理想概率约为 0.999^1000,结果只有约 36.8%。这个估算假设各步错误相互独立,现实中的错误往往还会传播,因此长程序对逐步可靠性的要求极高。
**CPU 状态轨迹天然适合作为一种执行见证。**模型不只输出最终寄存器值,而是输出每一步的 PC、寄存器变化、内存读写地址和分支结果;外部验证器再按照 RISC-V 规范检查每一步是否合法。这样一来,模型负责提出状态,传统程序负责裁决状态。
这套组合比“完全相信模型”靠谱得多,但也暴露出一个现实问题:如果外部验证器已经完整实现了 RISC-V 语义,那么真正保证正确性的仍然是验证器,而不是语言模型。模型更像昂贵的候选答案生成器,验证器才是确定性的根。
**Qwenputer 因而更接近 proof-carrying execution,而不是一颗独立可信的 CPU。**前者要求每一步计算都附带可检查的证据;后者则要求执行单元本身在完整输入空间中满足规范。一次成功演示只能证明某些轨迹正确,无法证明所有指令组合都正确。
要成为“可验证计算机”,还缺四层东西
**第一层缺口是指令集覆盖率。**RISC-V 并不只有基础整数加减法,还包括乘除法、原子操作、压缩指令、浮点、向量、特权级、中断与异常等扩展。只跑通一个小程序,与通过完整架构测试套件不是同一量级。
**第二层缺口是状态规模。**少量寄存器和一小段内存可以完整放进上下文,但真实程序会访问大量地址,并依赖操作系统、设备、中断和虚拟内存。把完整机器状态反复序列化成 token,不仅昂贵,也会让上下文迅速膨胀。
**第三层缺口是边界条件。**处理器验证最难的部分通常不是普通加法,而是溢出、未对齐访问、非法指令、页故障、权限切换和并发竞争。语言模型在常见路径上表现正常,并不能说明它在稀有边界上遵守规范。
**第四层缺口是形式化保证。**形式化验证要求把规范写成逻辑性质,并证明实现对全部允许输入都成立;Qwenputer 当前展示的是有限样例上的运行轨迹,本质上仍属于测试。测试能发现错误,但不能证明错误不存在。
更现实的路线是“模型生成,确定性系统验收”
**语言模型最适合承担不确定但有创造性的工作,传统程序最适合承担规则明确且必须正确的工作。**如果把两者职责反过来,让模型执行每一条确定性指令、再让程序收拾残局,通常既慢又贵;如果让模型生成程序、约束或证明草稿,再交给编译器、模拟器和求解器检查,价值会更直接。
Qwenputer 可以继续沿着以下方向发展:
- **结构化输出:**把寄存器、内存变化和异常信息限制在固定语法内,避免自然语言污染机器状态;
- **逐步验证:**每执行一条指令,就由独立解释器检查状态转换,错误时立即回滚;
- **差分测试:**让 Qwenputer 与 Spike、QEMU 等成熟实现运行同一程序,逐条比较轨迹;
- **属性测试:**自动生成边界输入,重点覆盖溢出、跳转、异常和非法状态;
- **可追溯环境:**记录模型哈希、运行参数和推理后端,避免把偶然复现误认为绝对确定;
- **证明对象生成:**让模型输出可由 SMT 求解器或证明助手检查的约束,而不只是给出结果。
**最值得期待的应用不是拿 Qwenputer 替代芯片,而是用它辅助验证芯片和软件。**例如,模型可以阅读自然语言版 RISC-V 规范,生成测试用例,解释模拟器之间的状态差异,并把失败轨迹翻译成开发者容易理解的调试报告。
这种模式也适用于智能体。一个智能体可以自由规划操作步骤,但每个文件修改、数据库事务和系统调用都由确定性策略引擎检查;模型负责“想办法”,验证器负责“守底线”。Qwenputer 只是把这套分工缩小到了一条条机器指令上。
Qwen3.5 为什么适合做这类实验
**Qwen3.5 是面向推理、编程、多模态与智能体任务设计的模型系列。**其代码理解和长上下文能力,使它能够同时读取指令、寄存器、内存状态与执行约束;相比普通聊天模型,这类能力更适合处理严格的状态跟踪任务。
**Qwen3.5 的高效率架构降低了实验门槛,但没有消除语言模型执行离散逻辑的根本成本。**公开资料显示,Qwen3.5 系列包含不同参数规模与稀疏激活配置,其中大型版本采用混合专家架构,并强调长上下文吞吐与智能体工作流。不过,模型解码再快,也无法与专门的 CPU 电路或软件模拟器竞争逐条指令性能。
这里还需要避免一个误区:更强的模型不必然更确定。参数量和推理能力可以降低语义错误,却不会自动解决浮点非确定性、输出格式漂移和长链错误累积。要把语言模型放进计算系统,外部约束往往比继续扩大模型更重要。
这次实验的意义,不在于造出了一颗好 CPU
**Qwenputer 的产品价值目前接近于零,但研究价值明显高于一般的提示词玩具。**它把“语言模型能不能按规则计算”变成了一个可以逐步观察、逐步对照的问题,也迫使开发者区分三个常被混用的概念:结果正确、运行可重复,以及实现经过证明。
**截至 2026 年 10 月 29 日,公开信息还不足以把 Qwenputer 称为经过验证的 RISC-V 实现。**缺少完整指令覆盖率、重复运行统计、标准测试套件结果和跨推理环境复现数据,意味着它仍是一项概念验证,而不是可以承载生产工作负载的计算平台。
但这项实验提出的问题是成立的:当模型输出可以被约束成机器状态,当每一步都能由外部规则检查,当错误可以定位到具体状态转换时,语言模型就不再只是一个聊天界面,而可能成为计算系统里的提案者、解释器和证明生成器。
**真正可靠的未来,不会是“相信模型就是计算机”,而是“模型提出计算,确定性系统验证计算”。**Qwenputer 距离一颗可信 CPU 还有很远,但它已经把这条路线用最直观的方式跑了一遍。
参考来源
- RISC-V Instruction Set Manual(GitHub):RISC-V 官方指令集规范仓库,可用于核对基础整数、特权级及扩展指令语义。
- Qwen 官方模型主页(Hugging Face):Qwen 系列权重、模型卡与版本信息的官方发布页面。
- LLM 大模型推理成绩实测(知乎):包含 Qwen3.5 不同规模模型及本地推理环境的社区测试记录。