Clover开源,扩散模型正面挑战自回归
DiffuSpace 开源 35B MoE 扩散语言模型 Clover,激活参数仅 3B,官方称生成速度可达 680 tokens/s,并在多项 Agent 基准上超过同尺寸自回归模型。
35B 扩散语言模型,开始挑战自回归主场
扩散智能 DiffuSpace 于 10 月 28 日发布并开源 Clover-35B-A3B-Preview,这是 Clover 模型家族的首个成员,也是一款总参数 350 亿、单次激活参数 30 亿的 MoE 扩散语言模型。模型采用 Apache 许可开放,DiffuSpace 将它定位为能够兼顾智能水平与生成速度的新一代基础模型。
扩散语言模型(Diffusion Language Model,dLLM)是一类通过多轮去噪和迭代修正生成文本,而不是严格从左到右逐词续写的语言模型。 如果说 GPT、Claude、Qwen 等自回归模型是在一张白纸上从第一个字写到最后一个字,那么扩散语言模型更像先铺出一版包含大量空缺或噪声的草稿,再同时修改多个位置,逐轮把答案变清晰。
这次发布真正值得关注的地方,不只是 DiffuSpace 又做了一个扩散模型,而是 Clover 第一次把这条路线推到了 35B MoE 规模,并试图在 Agent 编程、工具调用和端到端执行速度上正面挑战成熟的自回归模型。
35B 总参数、3B 激活,MoE 解决的是计算账单
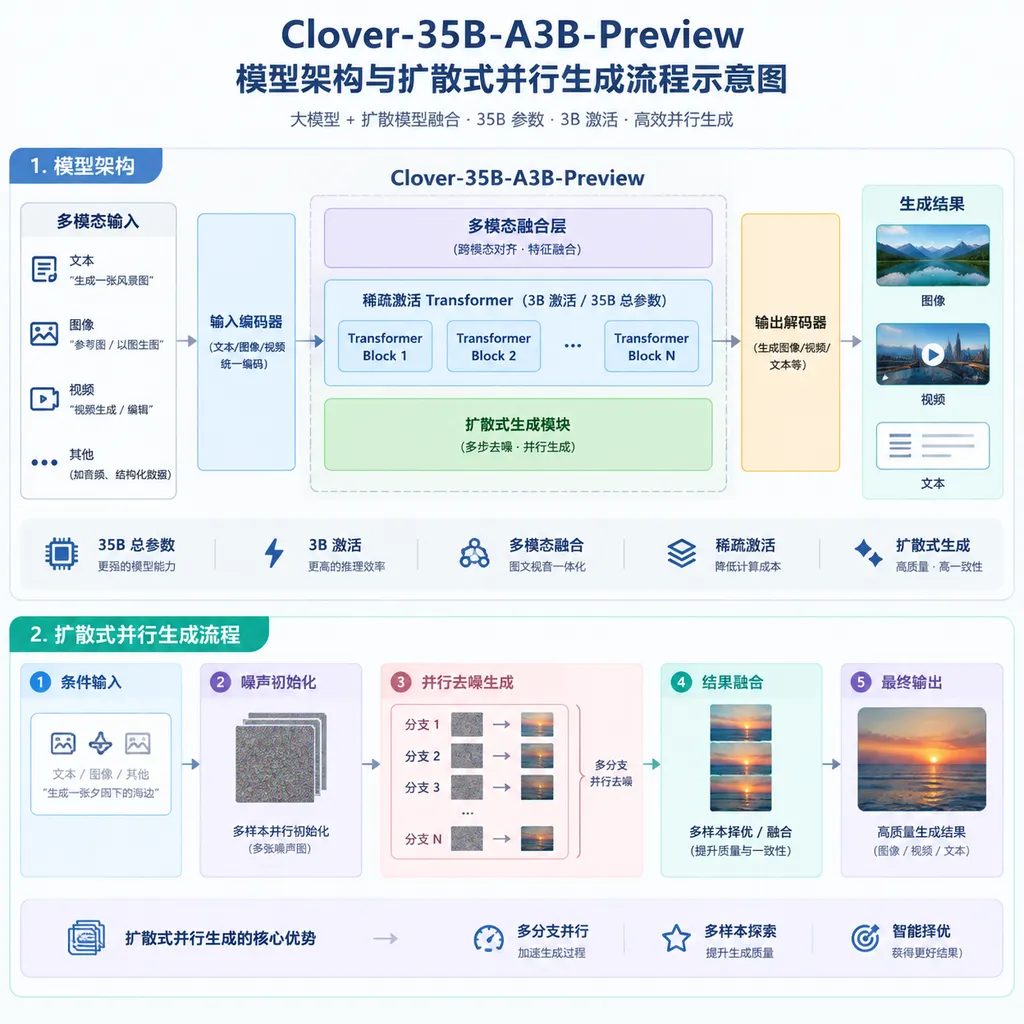
MoE(Mixture of Experts,混合专家)是一种每次推理只激活部分专家网络、以较低计算量承载更大总参数规模的模型架构。 Clover-35B-A3B-Preview 的名称已经写明核心规格:总参数约 35B,即 350 亿;每个 token 对应的激活参数约 3B,即 30 亿。
这一配置意味着 Clover 并不是每次生成都让全部 350 亿参数参与计算,而是由路由机制选择少数专家处理当前信息。它获得了更大的知识与能力容量,但单步计算成本更接近一个小得多的稠密模型。
MoE 与扩散解码结合后,目标很明确:前者降低每轮迭代的计算负担,后者减少必须串行执行的生成步骤。自回归模型即使单个 token 算得很快,下一个 token 仍然要等待上一个 token 落定;扩散模型则可以在一次迭代中同时更新多个位置,更容易吃满 GPU 的并行计算能力。
Clover 的主要参数与官方公布结果如下:
| 项目 | Clover-35B-A3B-Preview | |---|---:| | 模型类型 | 扩散语言模型(dLLM) | | 架构 | MoE 混合专家 | | 总参数 | 35B,约 350 亿 | | 激活参数 | 3B,约 30 亿 | | 官方整体生成速度 | 最高约 680 tokens/s | | SWE-bench Verified | 73.6 | | Terminal-Bench 2.1 | 51.7 | | τ³ Overall | 65.3 | | 开放方式 | Apache 许可开源 | | 当前版本状态 | Preview 预览版 |
DiffuSpace 称,Clover 相比团队上一代模型将参数规模扩大了约 5 倍,同时维持了相近的生成速度。对扩散语言模型来说,这个结果比单次跑分更重要,因为它回应了一个长期疑问:扩散解码在小模型上很快,但扩大参数后,反复迭代是否会把速度优势全部吃掉?Clover 给出的阶段性答案是,没有。
680 tokens/s 很快,但不能只看一个吞吐数字
Clover-35B-A3B-Preview 在 DiffuSpace 内部测试中的整体生成速度达到 680 tokens/s,部分场景下被称为同尺寸自回归模型的 5 至 10 倍。这个数字足够亮眼,但扩散模型与自回归模型的 token/s 并不总能直接横向比较。
整体生成速度是从任务开始到完整结果生成所计算的平均吞吐,而不是用户看到第一个 token 的时间。 自回归模型天然适合流式输出,模型生成几个词后,用户就能开始阅读;扩散模型可能先对一整段候选序列进行若干轮修正,再交付更完整的结果。因此,评估扩散模型更应该同时观察首个可用结果延迟、完整任务耗时、输出长度和硬件配置。
DiffuSpace 展示的空管信息处理 Demo 比单纯的 tokens/s 更有参考价值。模型需要从 20 条空管报文中提取地点与半径,并在三维地图上设置对应的无人机禁飞区域;Clover 完成任务耗时 7.32 秒,对照模型 Qwen3.5 耗时 62.3 秒,前者耗时减少约 54.98 秒,端到端速度约为后者的 8.5 倍。
这个场景恰好能放大扩散模型的长处。任务不是写一篇需要边读边看的文章,而是解析一批结构相似的信息、生成结构化结果,再统一执行工具操作。用户关心的是整批任务多久完成,不是第一个字多久出现在屏幕上。对于代码修改、批量信息抽取和 Agent 工具调用,完整结果时间往往比流式打字效果更重要。
第三方 WindTunnel 测评也给出了类似信号。Clover 在 49 项任务中的中位执行时间为 1.52 秒,Jev 与 Mercury 2.5 组合的中位执行时间为 3.21 秒;按公开结果计算,Clover 耗时减少约 52.6%,对照组合用时约为 Clover 的 2.11 倍。
需要强调的是,不同测试可能采用不同硬件、上下文长度、输出长度、采样策略和扩散迭代步数。680 tokens/s、7.32 秒以及 1.52 秒分别描述不同维度,不能拼成一个统一结论。Clover 的速度优势已经值得认真对待,但要判断它在本地部署和生产环境中的真实成本,仍需等待更完整的推理配置、显存占用和并发测试。
Agent 编程可能是扩散模型最先打穿的场景
Clover 在六项 Agent 评测中取得了 DiffuSpace 所列对比模型中的最高分,其中 SWE-bench Verified 为 73.6、Terminal-Bench 2.1 为 51.7、τ³ Overall 为 65.3。官方称这些结果超过扩散模型 Mercury 2.5,也超过同尺寸自回归模型 Qwen3.6-35B-A3B。
SWE-bench Verified 是通过真实 GitHub 软件问题检验模型能否理解代码仓库并提交有效修复的基准。 这类任务要求模型阅读多个文件、定位依赖关系、修改代码并通过测试,不是靠记忆一道算法题就能拿分。
Terminal-Bench 2.1 是评估模型在终端环境中执行多步骤任务能力的基准。 模型需要规划命令、读取执行反馈、纠正错误并推进任务,因此更接近真实的开发运维 Agent。
τ³ Overall 是面向工具使用与交互式任务的综合指标。 这类评测关注模型能否在一系列相关决策中保持目标一致,并正确选择和调用工具。
三项成绩放在一起看,Clover 的优势并不只是“写字快”,而是较快地产出一组相互关联的决策。Agent 任务经常需要同时考虑仓库结构、测试结果、命令状态和工具返回值;传统自回归模型按顺序生成下一步动作,早期一步出错后,后续动作可能沿错误路径继续展开。扩散模型允许在多轮迭代中修改前面和后面的内容,理论上更适合做全局规划。
不过,“全局思维”更适合作为一种生成机制的通俗描述,而不是已经被证明的认知能力。双向修正可以改善全局一致性,却不会自动消除幻觉、错误工具参数或无效代码补丁。扩散模型依然需要可靠的训练数据、强化学习、工具反馈和验证环境。
Clover 与自回归、扩散竞品怎么比
Clover 当前最直接的对手不是顶级闭源模型,而是同参数区间的开源 MoE 模型和已经进入产品化阶段的扩散模型。现有公开信息可以概括如下:
| 模型或方案 | 生成范式 | 参数信息 | 公开速度信息 | 主要定位 | 开放情况 | |---|---|---|---|---|---| | Clover-35B-A3B-Preview | 扩散式 | 35B 总参数、3B 激活 | 官方最高约 680 tokens/s;部分场景为同尺寸自回归模型的 5—10 倍 | Agent 编程、工具使用、通用任务 | Apache 许可开源 | | Qwen3.6-35B-A3B | 自回归式 | 35B 总参数、3B 激活 | Clover 官方对比中较慢 | 通用推理与 Agent | 同尺寸参照模型 | | Mercury 2.5 | 扩散式 | 官方对比资料未列明 | 以低延迟见长 | 高速生成与 Agent | Clover 的扩散路线竞品 | | Jev + Mercury 2.5 | 决策模型与扩散模型组合 | 组合方案 | WindTunnel 中位耗时 3.21 秒 | 快速决策与任务执行 | 组合式方案 |
这张表最重要的信息是,Clover 不再只和自回归模型比较速度,也开始和 Mercury 这样的扩散竞品比较任务质量。扩散语言模型过去常被当作“输出很快但能力一般”的实验路线;如果 Clover 的 Agent 成绩能够被独立复现,竞争维度就会从“谁打字更快”变成“谁能更快完成整个任务”。
Clover 的 35B-A3B 配置也相对务实。35B 总容量足以覆盖复杂代码和工具知识,3B 激活规模则把每次前向计算控制在较低水平。它没有用数百亿激活参数硬堆效果,而是在模型容量、并行生成和部署成本之间寻找平衡。
开源很关键,但 Preview 仍有三笔账没算清
Apache 许可让 Clover 比只提供在线服务的扩散模型更有研究和部署价值。开发者可以围绕它验证扩散步数、并行解码、Agent 工作流和推理优化,而不必只依赖厂商展示的 Demo。
第一笔账是显存和硬件成本。MoE 模型每次只激活 3B 参数,不代表部署时只需要装载 3B 参数;350 亿总参数通常仍需驻留在显存或内存中。仅按未量化的 BF16 权重粗略计算,35B 参数本身约需 70GB 存储空间,还未计入 KV Cache、激活值、路由和运行时开销。量化可以降低门槛,但是否影响扩散迭代质量,需要实测。
第二笔账是延迟与质量的交换。扩散语言模型可以通过减少去噪步数提高速度,也可能因此降低答案稳定性;增加迭代步数则可能提升质量,却会削弱吞吐优势。开发者真正需要的是一条完整曲线:在不同迭代步数下,SWE-bench 成绩、完整任务耗时和显存消耗分别是多少。
第三笔账是生态兼容性。现有推理框架、量化工具、结构化输出约束和 Agent 运行时,大多围绕自回归解码构建。扩散模型即使权重开放,也不等于能无缝替换现有模型。Preview 版本能否进入常用推理栈,以及是否支持稳定批处理、约束解码和多轮工具调用,将直接决定它能否从评测模型变成生产模型。
扩散模型不会立刻取代 GPT,但已经不是论文玩具
Clover-35B-A3B-Preview 证明的并不是“自回归模型马上过时”,而是扩散语言模型已经能够扩展到 35B MoE 规模,并在部分 Agent 任务上同时交付有竞争力的质量与速度。
自回归范式仍然拥有最成熟的训练方法、推理基础设施、流式交互体验和开发生态。对于开放式写作、长对话以及需要边生成边展示的产品,自回归模型依旧自然且高效。扩散模型的优势则更可能率先出现在批量代码修改、结构化抽取、多文件分析和工具规划等“结果完成得越快越好”的任务中。
DiffuSpace 的策略也很清楚:不先争论扩散模型能否全面替代 GPT,而是进入 Agent 这个对速度、全局规划和反复修正都高度敏感的场景。只要模型能把一次软件修复从几十秒压到几秒,并保持补丁可用,开发者就有迁移动力。
截至 2026 年 10 月 29 日,Clover 仍是一个带有 Preview 后缀的首发版本,现有核心数据主要来自团队公布和有限的外部测评。它已经足以让行业重新评估扩散语言模型,但还不足以给自回归范式判死刑。接下来真正有说服力的证据,不是另一张官方榜单,而是社区能否在相同硬件和统一推理设置下复现 680 tokens/s,以及它能否在真实代码仓库、长上下文和高并发服务中保持质量。
如果这些问题得到肯定答案,Clover 的意义就不只是一款新的开源模型。它可能意味着大语言模型的生成方式,终于从“只能从左往右写”走向第二条可规模化的工程路线。
参考来源
- IT之家:DiffuSpace 推出 Clover-35B-A3B-Preview 扩散语言模型——介绍模型发布时间、MoE 架构、开源许可及其与同尺寸自回归模型的对比结果。