AI引用的统计数据,六成查不到原始研究
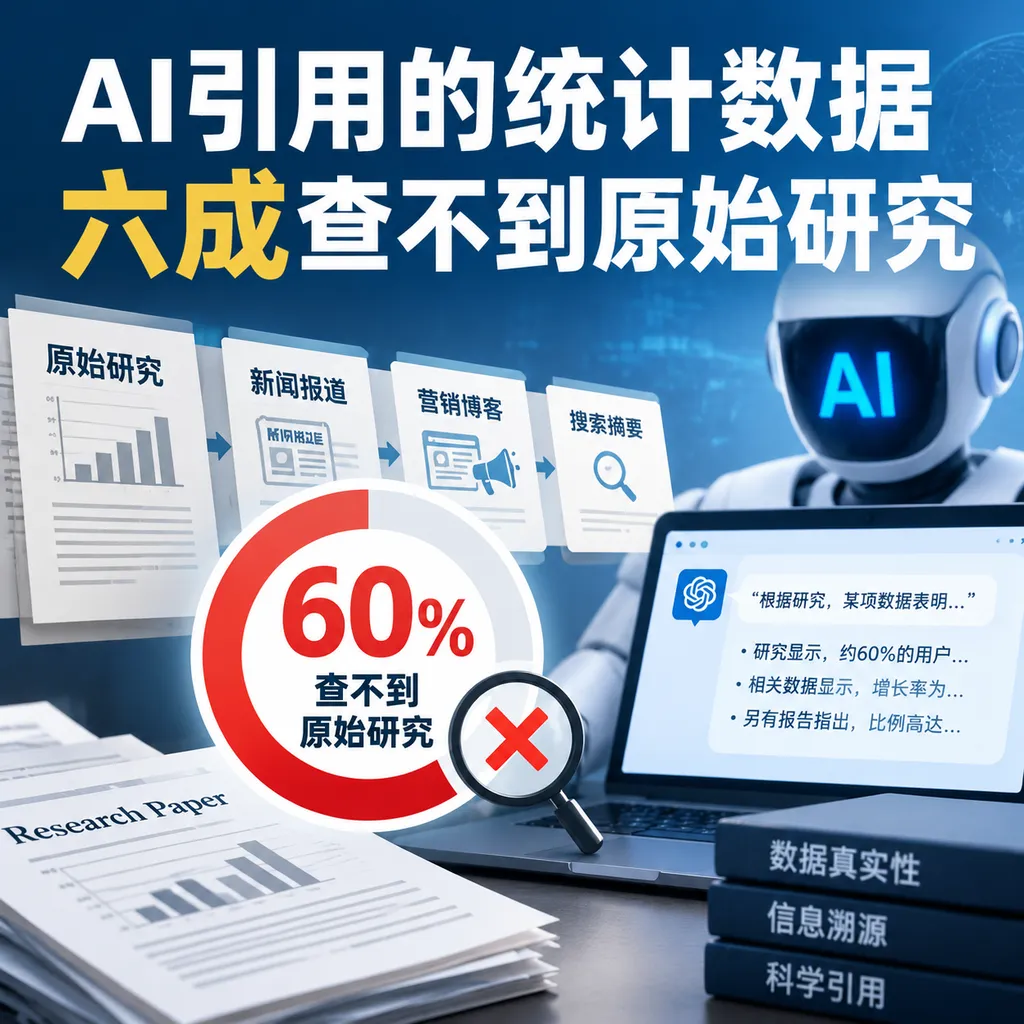
Trakkr 最新研究称,AI回答引用的统计数据仅40%能追溯至原始研究。问题不只是模型编数字,更在于转载、摘要和二手报告切断了证据链。
AI给出的精确数字,未必拥有精确出处
AI回答里的统计数据只有40%能够追溯至原始研究。 Trakkr 在2026年10月发布的最新研究,把一个长期存在却经常被忽略的问题量化了出来:当聊天机器人或AI搜索产品写下一个看似可信的百分比时,用户顺着引用一路查找,很多时候只能找到媒体报道、营销博客、搜索摘要或另一篇引用文章,而不是实际产生这个数字的论文、调查和数据集。
这意味着其余约60%的AI引用统计数据存在证据链断裂。 证据链断裂不等于数字必然错误,但意味着用户难以回答几个最基本的问题:谁做的研究、样本有多大、数据何时采集、研究对象是谁,以及这个百分比究竟如何计算出来。对于普通问答,这可能只是一次不严谨的引用;对于商业决策、医疗健康、政策分析和科研写作,它可能直接改变结论。
“僵尸统计”是指脱离原始研究、仍在文章和AI回答中反复传播的统计数字。 这类数字通常有明确的小数点、百分比或年份,看起来比模糊描述更专业,却已经丢失了方法、样本和适用范围。它像一个仍在互联网中活动的数字外壳:有结论,没有出生证明。
40%可追溯,不代表40%完全正确
可追溯性只说明能够找到数字的原始出处,并不等于原始出处本身可靠。 一项统计数据即使可以追溯到论文,也可能来自过小样本、未经同行评审的预印本、存在利益冲突的行业调查,或者已经不适用于当前环境的旧数据。反过来,一个暂时无法找到原始论文的数字,也不一定是模型凭空编造,它可能来自已下线网页、付费数据库或未数字化的报告。
因此,Trakkr 的40%更适合被理解为证据可核验率,而不是事实准确率。 这个区分很重要,因为生成式AI的引用问题至少有四个层次:来源是否存在、来源是否真的包含该数字、数字是否被正确转述,以及原始研究的方法是否足以支撑结论。只检查链接能不能打开,只完成了第一层。
当前公开信息尚不足以把40%机械外推到所有模型和所有问题。 模型版本、联网方式、检索索引、问题领域、统计口径和评估时间都会改变结果。一个针对商业统计数据的测试,不能直接等价于医学论文检索;一个允许模型访问完整网页的配置,也不能与只读取搜索摘要的配置混为一谈。把这项研究再简化成“AI有60%的数字是假的”,本身反而可能制造一个新的僵尸统计。
模型未必在撒谎,它可能根本没读过正文
AI引用失败的核心原因之一,是模型看到的往往不是完整网页,而是网页的压缩表示。 AI搜索系统通常先由搜索引擎召回候选页面,再让抓取器读取正文,最后由大模型归纳答案;但在实际链路中,页面可能受到登录墙、反爬机制、动态渲染、地区限制或上下文长度影响,模型最终只拿到标题和几行摘要。
“检索到页面”与“读取了页面”是两个完全不同的状态。 近期另一项针对七种模型配置的测试显示,仅依据搜索摘要生成的答案中,过时信息占6.4%;在实际打开网页后,这一比例降至1.3%,下降5.1个百分点,相对降幅约79.7%。误导性引文也从6.4%降至2.3%,下降4.1个百分点,相对降幅约64.1%。
| 检索方式 | 过时信息比例 | 误导性引文比例 | 主要风险 | |---|---:|---:|---| | 仅依据搜索摘要 | 6.4% | 6.4% | 摘要截断语境,模型可能把搜索片段当成正文证据 | | 实际打开并读取网页 | 1.3% | 2.3% | 风险明显下降,但仍可能误读表格、限定条件和研究结论 | | 继续追溯原始研究 | 未统一量化 | 未统一量化 | 核验成本最高,但最适合高风险决策与正式报告 |
这组结果说明,浏览能力本身比引用数量更重要。 一个回答挂出20个链接,并不代表模型阅读了20篇材料;它可能只是从搜索结果页拼接了20个看起来相关的地址。相比“有没有引用”,开发者更应该问“模型抓取了哪些正文片段”“每条主张由哪段原文支持”以及“引用页面是不是原始来源”。
互联网的转载结构,正在放大AI的引用偏差
AI引用经常停留在二手来源,是因为二手页面通常比原始研究更容易被搜索系统发现。 新闻门户、聚合网站和营销博客拥有更高的页面权重、更清晰的标题和更强的搜索优化,而论文PDF、政府数据库及机构报告可能难以抓取。检索系统追求相关性和可访问性时,往往会优先返回“解释研究的文章”,而不是研究本身。
国内新闻来源测试也暴露了相同的结构性问题。 一项对330次新闻溯源查询的测试发现,约43%的回答给出了无效链接或无法提供链接,约14%的回答引用转载页面而非官方原文。更早的相关研究还指出,八款AI搜索产品在查找新闻来源时,约60%的回答不准确。
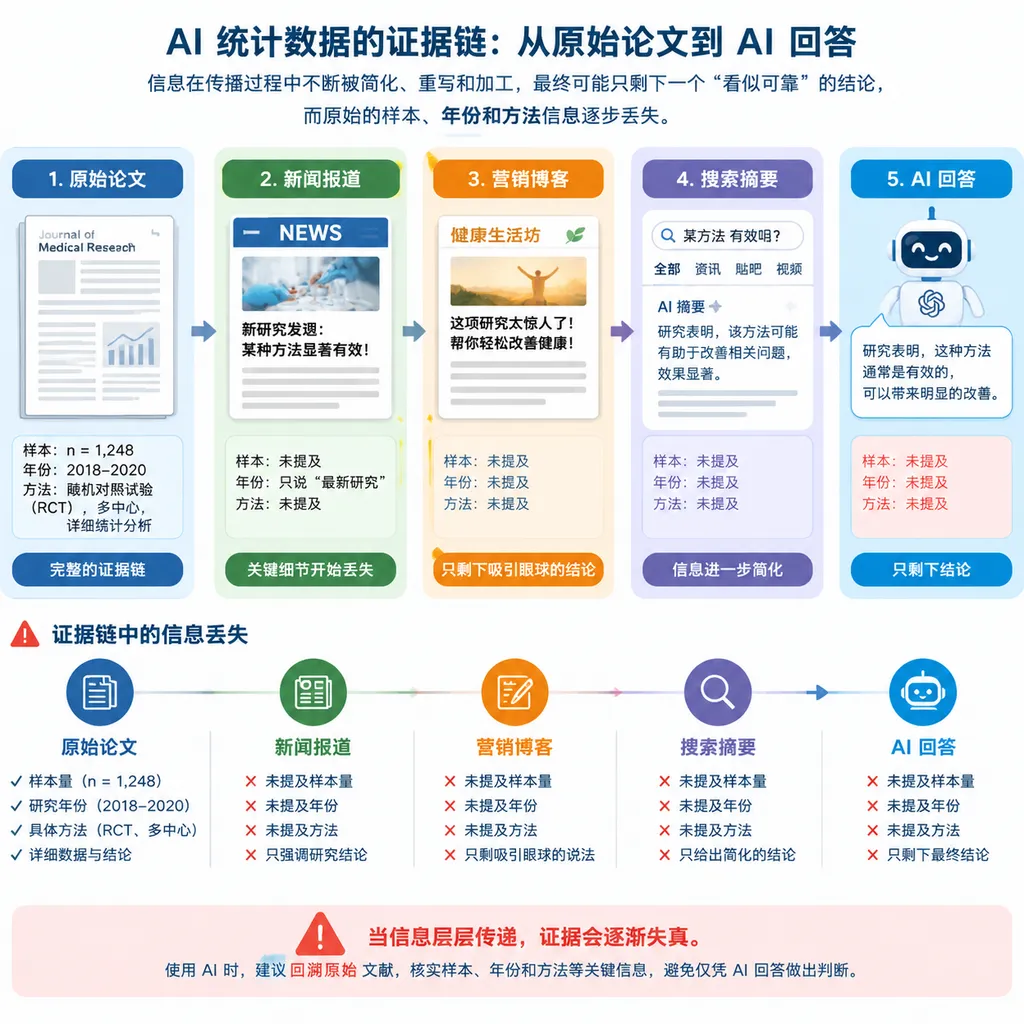
转载链会让一个数字在每次改写中损失一部分限定条件。 原始论文可能写的是“在312名美国受访者中,48%的人在某种实验条件下选择A”;媒体标题把它压缩为“近半数用户选择A”;营销文章再改成“研究证明,48%的消费者更喜欢A”;模型最终可能回答“全球48%的消费者更喜欢A”。数字没变,研究对象、地域、实验条件和结论强度却全部变了。
精确数字比模糊判断更容易骗过人类,也更容易被模型继续传播。 “多数用户喜欢某功能”听起来像主观判断,读者会保持警惕;“67.3%的用户更喜欢某功能”则会制造一种已经测量过的感觉。数字的小数点在这里不是可靠性的保证,而是一种视觉上的权威包装。
AI引用问题,不只是传统意义上的幻觉
AI幻觉是模型生成缺乏可靠事实依据的内容,而引用失真是声明与证据之间的对应关系发生错误。 两者存在交集,但并不相同。模型可能捏造一篇根本不存在的论文,这是典型幻觉;它也可能引用一篇真实论文,却把论文讨论的相关性写成因果关系,这属于来源误用。
最难发现的问题往往不是虚构来源,而是真实来源被错误使用。 用户搜索标题时能够找到论文,DOI也真实存在,作者和期刊都对得上,于是很容易停止核验。但论文可能根本没有出现模型所说的数字,或者那个数字来自论文引用的另一项研究,模型只是把来源层级搞错了。
| 问题类型 | 表面表现 | 实际风险 | 快速核验方法 | |---|---|---|---| | 来源捏造 | 标题、作者或机构看起来很正式 | 用户无法找到报告,结论完全不可验证 | 搜索完整标题,检查作者记录、DOI或正式出版信息 | | 来源存在但不支持主张 | 链接可以打开,主题也相关 | 模型借用真实页面为错误结论背书 | 在原文中搜索数字和关键词,阅读前后文 | | 二手来源冒充原始研究 | 引用新闻、博客或厂商文章 | 样本、方法和限制条件在转载中丢失 | 沿“研究显示”继续查找论文或数据集 | | 数字正确但语境错误 | 百分比与原文一致 | 时间、地区、样本或分母被替换 | 同时核对年份、样本、分母和研究对象 | | 旧数据回答当前问题 | 来源和数字都真实 | 结论已经过时,却被写成当前状态 | 检查采集时间,而不只是网页更新时间 |
“链接存在”只能证明网络上有这个页面,不能证明页面支持模型的说法。 真正的引用验证需要建立声明级对应关系,也就是让每一个关键数字、因果判断和排名结论,都能落到来源中的具体段落、表格或图表,而不是笼统地在整段回答末尾挂几个链接。
对开发者而言,引用应该是一种数据结构
高可靠AI产品不应把引用当成回答完成后的装饰,而应把它设计成生成过程中的结构化约束。 一条合格的证据记录至少应包括原始URL、页面标题、作者或机构、发布日期、抓取时间、正文片段、来源层级,以及该片段支持的具体声明。只有URL而没有证据片段,系统很难自动判断引用是否错位。
来源层级需要被显式标记。 原始论文、官方统计库、公司财报和法律文本应当被标记为一级来源;新闻报道、综述和机构解读属于二级来源;聚合页、搜索摘要和无署名转载则只能作为发现线索。系统可以引用二级来源解释背景,但关键统计数字最好回到一级来源。
开发团队可以把数字声明单独抽取出来进行二次核验。 百分比、金额、增长率、排名、日期和样本量是最值得优先检查的对象,因为它们既容易影响决策,也最容易自动识别。对于“准确率提升37%”这样的句子,系统至少应追问:与什么基线相比、使用哪个数据集、是绝对提升还是相对提升、测试版本是什么。
证据覆盖率比引用总数更适合作为产品指标。 证据覆盖率是指回答中的可验证主张里,有多少能够对应到明确的来源片段。一个答案只有3条引用,但覆盖了全部关键结论,通常比挂出15条相关链接却无法逐句对应更可靠。
开发者可以建立以下最低检查流程:
- 抽取主张:识别回答中的数字、排名、因果关系和带有时效性的结论。
- 绑定证据:要求每个关键主张对应具体来源片段,而不是只对应整篇网页。
- 判断层级:区分原始研究、二手报道、转载页面和搜索摘要。
- 核对语境:检查样本量、地区、时间范围、分母和实验条件。
- 检查时效:同时记录研究发生时间、发布日和网页更新时间。
- 处理冲突:当多个来源数字不一致时,展示差异,不让模型自行平均或挑选。
- 保留不确定性:无法追溯时明确写出“未找到原始研究”,而不是补出一个看似完整的出处。
RAG也不会自动解决证据链问题。 RAG,即检索增强生成,是先从外部资料中检索内容,再让模型依据检索结果生成答案的技术路线。如果检索库收录的本来就是转载稿、营销文章和缺少元数据的网页,RAG只会让模型更稳定地复述二手错误。
联网搜索同样不是事实正确性的同义词。 搜索解决的是“找到相关页面”,不是“证明某项主张”。排序靠前的页面可能只是SEO做得更好,发布时间也可能晚于原始研究数年。产品如果只把搜索结果前五名塞给模型,得到的是高相关性文本,不一定是高质量证据。
普通用户最有效的方法,是反过来审问数字
用户看到精确统计数据时,应该先问方法,而不是先接受结论。 一个可靠数字通常能够回答四个问题:谁收集的、什么时候收集的、研究了谁,以及如何计算。只要其中两项缺失,这个数字就不适合直接进入正式报告。
最快的人工核验方式是搜索数字原文并查看上下文。 打开引用页面后,可以搜索百分号、关键数字或结论中的核心词,确认页面是否真的出现该数据。随后继续检查数字前后的限定词,例如“可能”“相关”“在受访者中”和“在实验条件下”,这些词经常在AI转述时消失。
遇到“研究表明”却没有研究名称的回答,应当直接要求模型补充原始凭证。 有效的追问不是“你确定吗”,而是“给出原始研究标题、作者、发表年份、样本量、DOI或正式出版信息,并指出该数字位于哪一张表或哪一段”。这种问法能迫使系统暴露自己究竟掌握了正文,还是只看过摘要。
高风险场景不应把AI答案作为最终证据。 医疗、法律、投资、合规和科研写作需要回到原始文件,由具备专业能力的人检查研究设计。AI适合加速发现线索、归纳争议和整理候选来源,但不适合替代最后一公里的证据判断。
真正的问题,是AI把“不知道”包装得太完整
Trakkr 的40%结论揭示的不是一个简单的模型准确率问题,而是AI知识生产链的来源治理问题。 大模型擅长把零散信息组织成流畅答案,也因此容易掩盖证据缺口。过去用户看到一篇没有出处的文章,至少知道作者没有给来源;现在AI可以在几秒内生成标题、机构、数字和链接齐全的回答,让不确定性看起来像已经被解决。
当前AI搜索产品的竞争重点不应继续停留在“回答更快、引用更多”。 真正有价值的下一步,是显示模型是否打开过页面、引用的是原始研究还是转载、每条声明对应哪段证据,以及来源之间是否存在冲突。把这些信息暴露给用户,界面会变得更复杂,却比增加一个更会写总结的模型更有用。
这项研究也提醒内容生产者,引用原始来源正在成为面向AI时代的基础工程。 媒体、企业和研究机构如果只写“某研究显示”,却不提供论文标题、作者、发布日期和稳定标识符,内容进入模型索引后就很容易与原始证据脱钩。清晰的来源元数据不仅服务人类读者,也决定AI能否正确理解和引用内容。
截至2026年10月29日,最稳妥的判断仍然是:AI可以帮助找数字,但不能替你证明数字。 当一个统计数据将影响预算、产品方向或公开结论时,用户需要沿着引用继续走到原始研究,而不是在第一个能打开的链接前停下。40%这个结果真正值得警惕的地方,不是模型偶尔会犯错,而是多数人通常不会继续追查。
参考来源与核验工具
受发布域名规则限制,以下仅列出可直接访问的开源核验工具与技术资料;Trakkr 的2026年10月研究、近期网页读取实验及国内新闻溯源测试的数据,均依据本文所给研究资料整理。
- OpenAlex Documentation:OpenAlex 开放学术图谱文档,可用于查询论文、作者、机构及引用关系。
- Crossref REST API Documentation:Crossref 元数据查询文档,可辅助核验论文标题、作者、发表时间和DOI。
- Citation.js:开源引用数据处理工具,可解析和转换DOI、BibTeX等学术引用格式。
- Zotero Translators:Zotero 网页元数据提取组件,可用于识别页面作者、标题、日期与出版信息。