Epoch:开放权重模型放大补丁时间差
Epoch AI 最新研究警告,开放权重模型可从安全补丁中逆推出漏洞利用方法,并在企业完成更新前批量复制攻击。真正被压缩的不是漏洞发现时间,而是防守方的响应窗口。
补丁刚发布,攻击自动化已经开始
Epoch AI 在 10 月下旬发布的最新研究提出了一个更现实、也更棘手的 AI 安全风险:开放权重模型正在帮助攻击者利用“补丁时间差”,从公开的代码修改中复现漏洞,并把原本需要人工完成的定向攻击扩展为批量作业。
**补丁时间差(patch gap)是安全修复已经公开、但大量实际系统尚未完成升级的时间窗口。**在这段时间里,修复提交、版本差异、漏洞说明和测试用例会逐步暴露问题所在,而互联网中仍有一批可以被攻击的旧版本实例。
这不是一个全新的安全问题,但模型让攻防双方的时间尺度发生了变化。过去,攻击者需要阅读补丁、理解代码、定位触发条件,再编写和调试概念验证;现在,代码能力较强的模型可以并行完成其中相当一部分工作,并通过工具调用反复试错。
截至 2026 年 10 月 30 日,Epoch AI 这项研究最值得关注的判断不是“模型突然会发现所有零日漏洞”,而是已公开补丁正在变成机器可读的攻击说明书。安全团队原本按天计算的修复窗口,可能被攻击者按小时消耗。
研究指向的是 N-day 攻击,而不是“AI 凭空挖零日”
**N-day 漏洞是已经被披露或修复、但仍有未升级系统暴露在外的已知漏洞。**这里的“N”可以是补丁发布后的第 1 天、第 7 天,也可能是几个月以后;只要旧版本仍在运行,攻击面就没有消失。
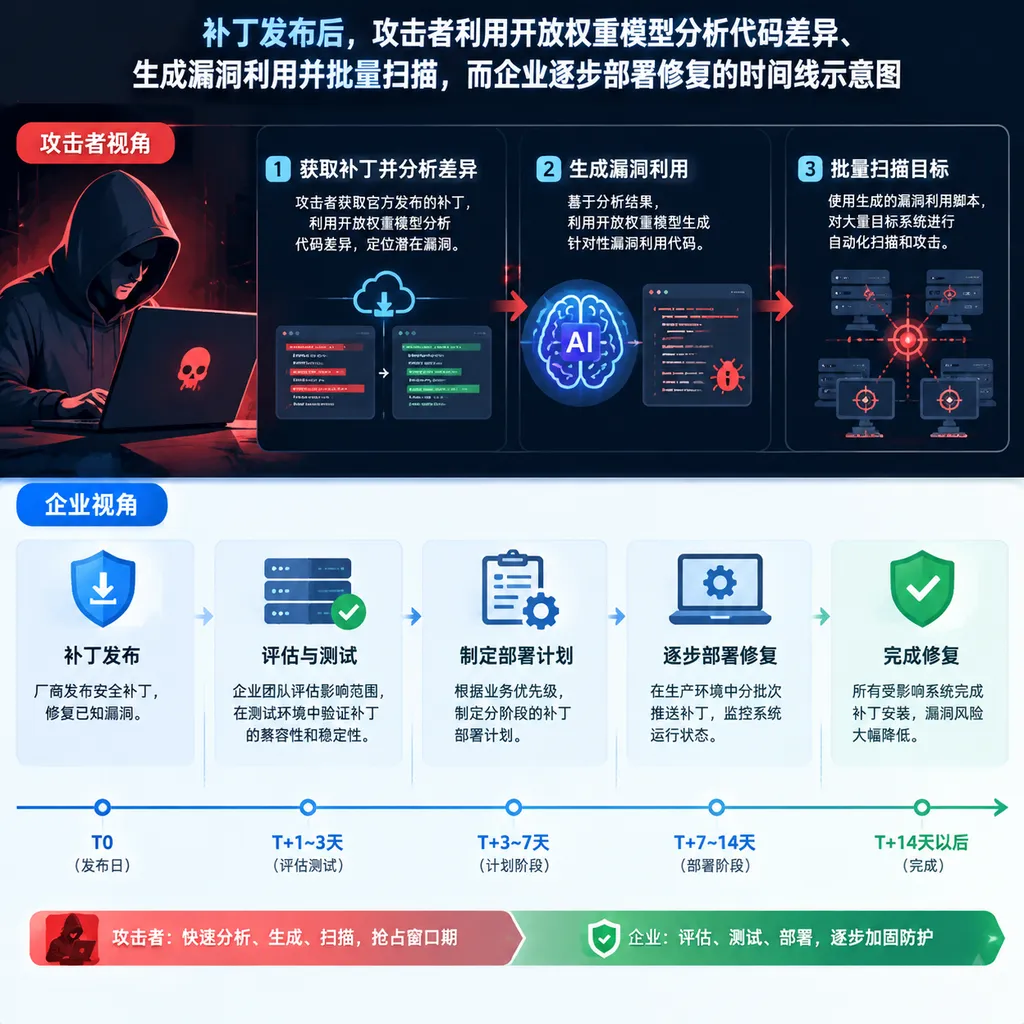
Epoch AI 讨论的核心链路大致可以拆成五步:
- 收集新版本与旧版本之间的代码差异;
- 判断哪些改动属于安全修复,而不是普通功能更新;
- 根据被修改的函数、边界检查或权限逻辑推断漏洞成因;
- 生成能够触发缺陷的输入、测试程序或概念验证;
- 将利用方法接入扫描、验证和任务编排工具,寻找仍未升级的目标。
这条链路最危险的部分不是其中某一步达到 100% 成功率,而是多次尝试的成本显著下降。模型第一次生成的利用程序可能无法运行,但攻击者可以让它读取编译错误、崩溃日志和调试输出,然后继续修改。只要单次尝试足够便宜,并行代理就能把过去由一名研究员串行完成的工作拆成数十个任务。
**补丁差异之所以具有高价值,是因为它大幅缩小了模型的搜索空间。**让模型从数百万行代码中独立发现漏洞很难,但告诉它“旧版本和新版本只有这 20 行不同,其中新增了一次长度检查”,问题就从开放式漏洞研究变成了目标明确的逆向推理。
这与考试时直接给出“答案改动位置”类似。模型仍需理解为什么要这样改,以及如何构造触发条件,但它不再需要先找到考点。
开放权重真正改变的是可控性和攻击经济学
**开放权重模型是允许用户下载模型参数并在本地或自有基础设施上运行、修改和继续训练的模型。**开放权重不等同于完整开源:训练数据、训练代码和数据处理流程未必公开,许可证也可能附带使用限制。
Epoch AI 把重点放在开放权重上,是因为攻击者能够获得比普通聊天产品更彻底的控制权。模型可以被长时间运行,可以接入编译器、模糊测试器、调试器和扫描工具,也可以针对漏洞分析数据继续训练;平台侧的内容审核、账户封禁和调用速率限制则很难在本地部署场景中生效。
| 对比维度 | 开放权重模型 | 闭源托管模型 | |---|---|---| | 模型运行位置 | 可在本地或自有集群运行 | 通常由厂商控制基础设施 | | 安全策略约束 | 权重下载后可修改或移除外围限制 | 厂商可更新规则、监测异常使用 | | 工具接入 | 可深度接入编译、调试、扫描与代理框架 | 取决于产品开放范围和平台政策 | | 并行扩展 | 主要受本地算力与工程能力限制 | 同时受费用、配额和风控限制 | | 针对性训练 | 可围绕补丁、漏洞样本继续训练 | 普通用户通常无法修改模型权重 | | 事后处置 | 已发布权重难以统一撤回 | 厂商可以更新模型或关闭相关能力 | | 可审计性 | 本地运行可能完全脱离外部日志 | 平台通常保留一定的使用记录 |
开放权重并不自动等于危险,闭源模型也不自动等于安全。代码理解能力、长上下文、工具使用和推理稳定性才是完成任务的基础;权重开放带来的额外风险,在于能力一旦发布,就很难再通过统一更新收回。
**模型发布具有不可逆性,而托管服务具有一定的可修补性。**如果研究机构发现某个闭源产品正在被用于批量复现漏洞,服务商可以调整安全策略、限制相关工具链或升级模型;如果相同能力已经固化在可下载权重中,原始发布者无法强制所有副本同步更新。
“复现”之后,真正的增量来自规模化
**攻击规模化是把一次成功的漏洞利用转化为可重复、可并行执行的扫描与验证流程。**这一步往往比“模型是否能写出一个利用程序”更重要,因为网络攻击的实际收益取决于可触达目标数量、成功率和单位成本。
假设某个补丁发布后,人工分析需要 2 天,企业平均需要 7 天完成关键系统更新,攻击者实际拥有约 5 天窗口。如果模型辅助把分析压缩到 6 小时,窗口就会扩大到约 6.75 天。这里的数字只是用于解释机制,并非 Epoch AI 报告给出的统一行业均值,但它展示了时间差为何会迅速转化为攻击优势。
模型还能承担大量此前不值得投入人工的边缘工作,包括:
- 为不同操作系统、依赖版本和编译选项改写触发方式;
- 根据错误日志修复无法运行的概念验证;
- 从版本信息和响应特征判断目标是否仍然脆弱;
- 生成批量验证脚本并整理成功与失败样本;
- 将新的测试结果反馈给其他代理继续迭代;
- 为小众软件和低价值目标生成定制化利用路径。
**自动化首先会覆盖“长尾漏洞”,而不只是最高危漏洞。**顶级漏洞本来就会吸引成熟攻击团队,AI 对这类目标的边际提升未必最大;真正明显的变化,可能发生在过去因为软件冷门、环境复杂或单个目标价值较低而无人投入的漏洞上。
当分析成本下降后,小型开源组件、行业专用软件、企业内部系统和多年未维护的插件都会重新进入攻击者的收益计算。单个目标价值不高并不意味着安全,只要目标数量足够多,批量攻击仍可能成立。
这项研究不意味着模型已经具备全自动入侵能力
**Epoch AI 的结论不能被简化为“开放模型已经可以自主攻破任意系统”。**从补丁差异到稳定利用之间,仍存在环境复现、依赖配置、内存布局、身份验证和网络可达性等多重障碍。
第一,补丁不一定暴露完整漏洞逻辑。维护者可能同时重构多个模块,也可能将关键修复放在不可见的服务端组件中;模型看到的差异越嘈杂,判断难度越高。
第二,概念验证能够触发崩溃,不代表它能实现远程代码执行。稳定利用通常还需要绕过内存保护、沙箱、权限隔离和运行环境差异,这些环节仍然依赖较强的专业知识。
第三,模型会产生错误解释。它可能把性能优化误判成安全修复,也可能编造不存在的函数、参数和依赖。如果没有可执行环境与自动验证,输出很容易停留在“看上去合理”的层面。
第四,真实资产发现并不简单。目标可能部署在内网、经过反向代理隐藏版本信息,或者已经通过临时规则缓解风险。发现漏洞与找到可攻击实例是两个不同问题。
因此,最现实的近期威胁不是一个模型独立完成从侦察到控制的全部流程,而是熟练攻击者借助多个模型代理提升产能。AI 更像一支速度快、成本低、但需要监督的初级安全工程团队,而不是不会犯错的自动黑客。
防守方需要把“补丁管理”升级为竞速系统
**传统按月更新的补丁流程已经不适合公开差异可被模型快速分析的高危漏洞。**如果关键互联网资产要经过申请、测试、排期和统一维护窗口才能升级,攻击者会在审批完成前获得充足时间。
企业可以把补丁响应拆成三个并行轨道:
- **资产轨道:**确认哪些公网服务、软件供应链组件和内部系统受影响;
- **缓解轨道:**无法立即升级时,先关闭高风险功能、限制访问或部署检测规则;
- **验证轨道:**在隔离环境复现漏洞,并主动检查补丁是否真正阻断攻击路径。
**互联网暴露资产应该采用按小时计算的分级响应目标。**例如,企业可以把最高危远程漏洞的初步影响判断设为 4 小时内完成,把临时缓解目标设为 12 小时,把关键公网实例的修复目标设为 24 小时。上述时间不是所有组织都必须照搬的行业标准,但比“下一个维护窗口再处理”更符合模型时代的威胁速度。
开发团队还应减少补丁发布与安全说明之间的不必要错位。提前披露过多细节可能扩大攻击窗口,但延迟提供修复指导也会让防守方无法判断优先级。更合理的做法是让修复版本、影响范围、临时缓解措施和检测方法尽可能同步发布。
**安全团队也可以使用同类模型缩短防守时间。**模型能够帮助梳理依赖关系、比较版本差异、生成回归测试和解释修复逻辑,但所有自动结论都应通过隔离环境验证。攻防双方使用的是相似能力,差异主要在数据、工具权限、响应流程和组织执行速度。
开放权重发布需要讨论“可持续治理”
**可持续治理是模型发布后仍能处理能力升级、滥用反馈和生态变化的治理机制。**一次性的发布评测无法覆盖未来出现的新代理框架、新工具链和新型漏洞数据,也无法保证模型半年后仍停留在发布时的风险水平。
一个模型在发布当天无法稳定复现漏洞,不代表它在新的脚手架、推理策略或针对性训练下仍然做不到。权重没有变化,外围系统却可以持续进化:上下文可以更长,搜索策略可以更好,验证工具可以更完整,多代理之间也可以相互检查结果。
这意味着模型评测不能只问“原始聊天界面能否完成任务”,还要问三个更接近真实风险的问题:
- 模型接入编译器、调试器和网络工具后能做到什么;
- 模型获得数百次尝试机会后,至少成功一次的概率如何变化;
- 模型经过低成本针对性训练后,能力上限会移动到哪里。
**开放权重模型的风险评估应该覆盖可适配能力,而不是只测试默认行为。**默认拒绝回答某个问题,并不能证明权重本身缺乏相关能力;同样,一次失败也不能代表并行尝试不会成功。
对模型开发者而言,更务实的方向不是把“开放”与“安全”做成二选一,而是在高风险代码能力发布前建立更贴近实战的评测,包括补丁差异分析、漏洞触发、工具调用、长时间代理运行和批量任务扩展。同时,许可证、模型卡和发布说明需要清楚区分已完成的测试、尚未覆盖的能力以及已知限制。
真正被压缩的是防守方的决策时间
**Epoch AI 这项研究的核心价值,是把讨论从抽象的“AI 会不会被滥用”拉回到了一个已经存在的操作窗口。**攻击者不必等待模型拥有科幻式自主能力,只要它能把补丁阅读、环境搭建和利用调试分别提速,就足以改变漏洞利用的成本结构。
开放权重模型也不应因此被简单等同于网络攻击工具。它们同样可以用于代码审计、漏洞修复、依赖检查和安全教育,而且本地部署对隐私、研究透明度和生态竞争具有实际价值。问题不在于是否开放,而在于发布者和使用者是否承认:可下载能力很难撤回,外围工具会不断进步,过去按天安排的响应流程可能已经太慢。
对企业而言,最直接的结论只有一句话:补丁发布不再意味着风险开始下降,它也可能意味着攻击倒计时刚刚开始。
参考来源
- GitHub Advisory Database:GitHub 维护的公开安全公告数据库,可用于查询漏洞影响范围、修复版本与相关项目。
- GitHub Security Lab:GitHub 安全研究项目,包含开源漏洞研究、检测方法和安全工具资料。
- Google OSS-Fuzz:面向开源软件的持续模糊测试基础设施,可用于理解自动化漏洞发现与回归验证流程。
- Qwen3-Coder 模型页:开放权重代码模型的模型卡示例,展示代码代理、工具使用及本地部署能力的发展方向。
本文核心判断依据 Epoch AI 最新官方研究《Open-weight AI models can exploit the patch gap》;根据本文来源域名要求,文末未附其站外链接。