英伟达开源H3视频重生成
英伟达与MIT团队开源Open-H3-Regenerate-2K,可将384P至768P视频草稿重生成至2K,最高支持原生4K,并将B200上的5秒视频处理时间缩短至22.45秒。
英伟达与麻省理工学院研究人员组成的 Efficient-Large-Model 团队,近日在 Hugging Face 放出了 Open-H3-Regenerate-2K 的模型权重,并将配套推理代码并入英伟达 NVlabs/Sana 项目。这个模型基于 MiniMax H3 的视频生成能力,可把低分辨率视频草稿重新生成到 2560×1440,最高支持 3840×2160 的原生 4K 输出。
**Open-H3-Regenerate-2K 是一个面向生成式视频的高分辨率重生成模型。**它不是把每个像素机械放大的传统超分辨率工具,而是读取原视频中的场景、构图和运动轨迹,再由生成模型在目标分辨率下重新绘制人物面部、布料、毛发与环境纹理。
这项工作的价值不只是“把视频变清楚”,而是补上了 MiniMax H3 开放生态中此前缺失的一环:H3-Base 可以生成 768P 音视频,但官方高分辨率重生成模块并未以可自行部署的模型权重形式开放。Open-H3-Regenerate-2K 给开发者提供了一套可以在本地服务器上研究、修改和部署的替代方案。
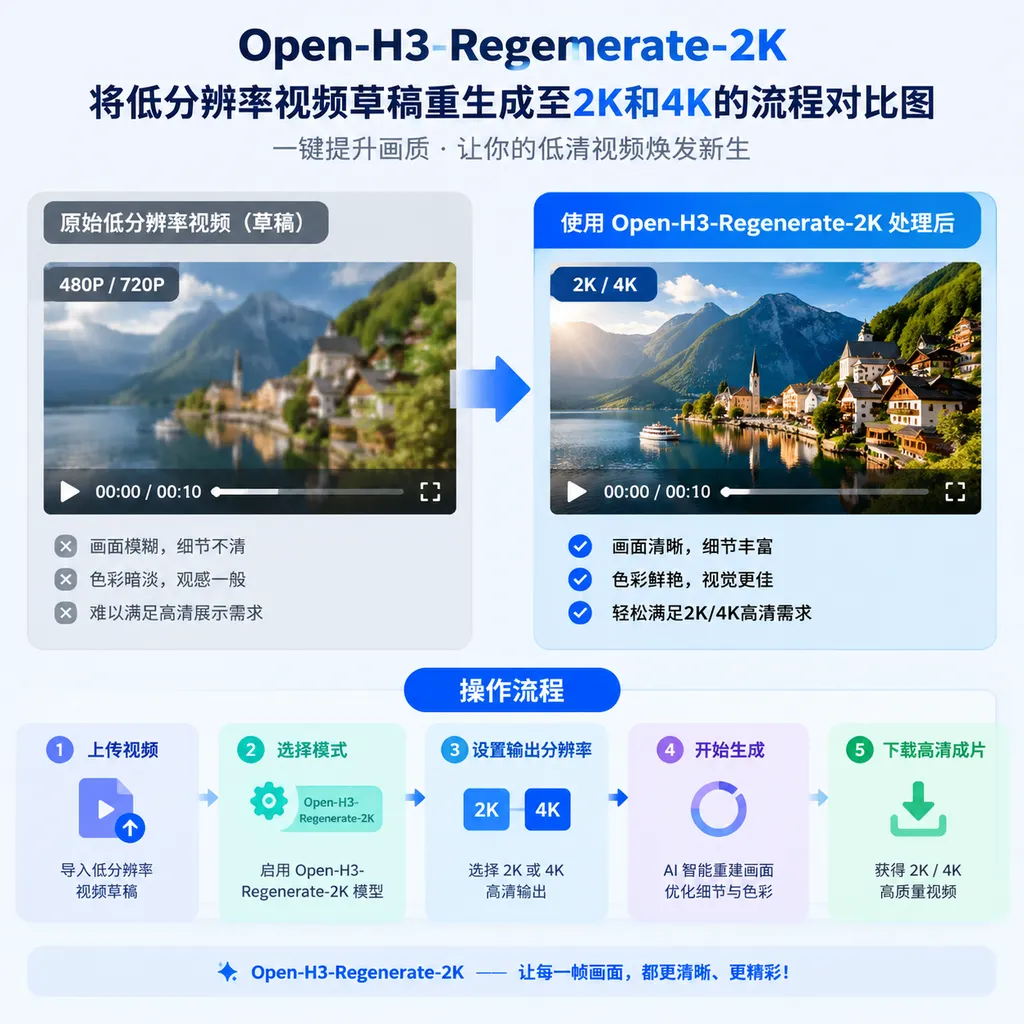
它不是超分,而是把视频再画一遍
**视频重生成与传统视频超分辨率的根本差别,在于前者会创造新的高频细节。**传统超分模型通常围绕现有像素做插值、锐化和细节补偿,优点是忠实、稳定,缺点是原图里没有的信息很难真正补回来;重生成模型则把低清视频当作结构约束,重新执行一次受控的视频生成过程。
举个直接的例子:一段 768P 视频里的人脸只有几十个有效像素,普通超分可以让轮廓更锐,但无法可靠还原眼睫毛、皮肤纹理和发丝。Open-H3-Regenerate-2K 会保留人物位置、镜头运动和动作节奏,同时在 2K 或 4K 画布上重新合成这些细节。
**这种“重新画一遍”的方法更适合 AI 生成视频,而不是证据性视频修复。**它能让结果看起来更真实,却不能保证新增纹理与现实中的原始细节一致。影视预演、广告素材和生成式短片可以接受这种创造性补全,监控取证、医学影像等要求像素真实性的场景则不应该把它当作还原工具。
Open-H3-Regenerate-2K 支持接收约 384P 至 768P 的视频草稿,输出档位覆盖 768P、1080P、2K,并可进一步运行到原生 4K。这里的“原生 4K 重生成”指模型直接在 3840×2160 目标空间生成结果,而不是先输出 2K、再通过常规插值放大到 4K。
| 输出档位 | 典型分辨率 | 相对768P像素量 | 更适合的场景 | |---|---:|---:|---| | 768P | 1280×768或相近比例 | 1倍 | 快速预览、工作流验证 | | 1080P | 1920×1080 | 约2.1倍 | 短视频、网页与常规显示器 | | 2K | 2560×1440 | 约3.75倍 | 专业剪辑、局部裁切、高清交付 | | 4K | 3840×2160 | 约8.44倍 | 大屏播放、影视后期、高质量素材库 |
**4K 能跑并不意味着 4K 是默认最划算的选择。**从 768P 提升到 4K,单帧像素量约增加到 8.44 倍,视频 latent、注意力计算和解码的显存压力都会同步上升。对多数开发者而言,2K 更可能是画质、速度和部署成本之间的实用平衡点。
冻结H3主干,只训练一层“精装修”
**Open-H3-Regenerate-2K 的训练策略是冻结 H3 Transformer 主干与视频 VAE,仅训练新增的细化 LoRA。**LoRA 是一种参数高效微调方法,它通过学习低秩增量矩阵改变模型行为,不需要重新训练完整基础模型,因此可以显著降低训练参数量和迭代成本。
这套思路很像保留建筑主体结构,只重新训练负责精装修的施工队。H3 原本掌握的语义理解、视频运动和画面生成能力不动,新增 LoRA 专门学习如何根据低清草稿,在更高分辨率下恢复和创造细节。
**冻结主干的好处是开发成本低,代价则是能力上限仍受 H3 基础模型约束。**如果输入草稿已经出现手指错误、物体穿模、人物身份漂移或运动逻辑不连贯,细化模型往往只会把错误画得更清楚,而不会自动修复底层时序和语义问题。
推理阶段,细化 LoRA 会与 LightX2V FL2VA Turbo、LMS Sharp 等社区适配器配合使用。前者侧重降低扩散采样成本,后者则用于强化锐度与高频细节,最终通过三步去噪完成目标分辨率下的重生成。
| 组件 | 主要作用 | 是否重新训练 | |---|---|---| | H3 Transformer | 理解文本、场景结构与视频运动 | 冻结 | | 视频VAE | 在视频像素与latent之间编码、解码 | 冻结 | | Refiner LoRA | 学习高分辨率细化与纹理重建 | 训练 | | 3D卷积latent upscaler | 在时空latent中提升目标尺寸 | 随方案使用 | | FL2VA Turbo | 减少采样步数、加快推理 | 推理时合并 | | LMS Sharp | 增强边缘和高频视觉细节 | 推理时合并 |
关键提速来自latent内部扩展
**Open-H3-Regenerate-2K 的核心工程优化,是在 latent 空间直接完成时空尺寸扩展。**低分辨率草稿只需编码一次,3D 卷积 latent upscaler 随后把 latent 提升到目标尺寸,不必先将低清 latent 解码成视频,再缩放并重新编码。
传统流程近似于“压缩文件先完整解压,再放大后重新压缩”,其中两次格式转换既耗时,也可能损失信息。新流程则直接操作模型内部的紧凑表示,把更多算力留给真正决定画质的去噪和细节生成。
按照项目披露的设置,输入 latent 会被加噪到 0.909,随后使用 Euler 调度器完成 3 步去噪,并关闭 CFG。CFG 是无分类器引导机制,通常用于增强生成结果对文本提示的服从程度,但它往往需要额外计算;重生成任务已经有视频草稿提供强结构约束,因此可以弱化甚至关闭文本引导。
**三步去噪是这套方案能进入生产工作流的关键。**常规视频扩散模型若需要几十步采样,即使单步优化得很好,面对数百帧和 2K 分辨率仍会很慢;把采样压缩至三步后,模型才更接近可用于批量素材处理的工具,而不只是实验室演示。
B200上处理时间从87.26秒降至22.45秒
**Open-H3-Regenerate-2K 在单张 NVIDIA B200 上,将一段5秒、768P输入视频重生成至2K的时间从87.26秒降到了22.45秒。**这相当于处理时间减少 64.81 秒,降幅约 74.3%,整体速度约为优化前的 3.89 倍。
项目披露的另一项数据是,快速 VAE 解码将耗时从约 15 秒缩短至 1.6 秒,减少 13.4 秒,降幅约 89.3%,速度提升约 9.38 倍。这说明高分辨率视频生成的瓶颈并不只在扩散 Transformer,最终把 latent 还原成数百张高分辨率画面的 VAE 同样可能吞掉大量时间。
| 测试项目 | 优化前 | 优化后 | 时间降幅 | 速度倍数 | |---|---:|---:|---:|---:| | 5秒768P视频重生成至2K,单张B200 | 87.26秒 | 22.45秒 | 74.3% | 3.89倍 | | 快速VAE解码 | 15秒 | 1.6秒 | 89.3% | 9.38倍 |
**22.45秒仍然不是实时视频增强。**处理 5 秒视频需要 22.45 秒,速度约为实时播放的 0.22 倍,或者说耗时约为片长的 4.49 倍。它已经适合离线生产与批量渲染,但距离直播增强、视频会议和实时游戏串流仍有明显差距。
这些性能数字也不能直接外推到消费级显卡。B200 是面向数据中心的大型加速器,拥有远高于桌面显卡的显存容量与带宽;换成 RTX 系列显卡后,4K 分辨率可能需要分块解码、CPU 卸载或多卡并行,速度也会明显下降。项目“可以自行部署”和“普通用户可以轻松跑4K”是两件完全不同的事。
开放的是高分辨率后半程
**Open-H3-Regenerate-2K 最实际的意义,是把视频生成流水线的高分辨率后半程开放了出来。**MiniMax H3 的完整系统包括多模态上下文处理、基础音视频生成与高分辨率重生成,已开放权重的 H3-Base 主要负责 768P 音视频,Open-H3-Regenerate-2K 则针对最后的清晰度跃迁。
这让开发者可以把视频生成拆成两个阶段:第一阶段用较低分辨率快速确定构图、人物、镜头和动作,第二阶段只对满意的草稿进行高成本重生成。相比每次修改提示词都直接生成 2K 或 4K,这种工作流能显著减少无效算力消耗。
**模型对输入来源相对宽容,是它比“H3专属放大器”更有价值的地方。**输入草稿不一定必须由 H3 生成,理论上也可以来自其他视频生成模型、3D 渲染结果或经过预处理的实拍素材,只要分辨率和时序格式满足要求。这使它有机会成为独立的视频后处理节点,而不仅是 MiniMax H3 的附件。
| 方案 | 处理方式 | 细节创造能力 | 时序一致性风险 | 可定制性 | |---|---|---:|---:|---:| | 插值放大 | 重采样像素 | 低 | 低 | 低 | | 传统视频超分 | 学习式恢复与锐化 | 中 | 中 | 中 | | Open-H3-Regenerate-2K | 扩散式高分辨率重生成 | 高 | 较高 | 高 | | 官方H3高分辨率模块 | H3体系内重生成 | 高 | 取决于官方系统 | 较低 |
画质提升之外,还有三个风险
**高分辨率重生成最需要警惕的是身份漂移。**当模型重新绘制面部和服装纹理时,不同帧之间可能出现五官细微变化、饰品忽隐忽现和衣服图案跳动。单帧截图可能非常清晰,但连续播放时仍可能暴露生成痕迹。
**三步采样优先解决的是速度,而不是绝对画质上限。**Turbo 类适配器通过蒸馏或轨迹压缩,把原本较长的去噪过程压到极少步骤,通常会牺牲一部分复杂场景下的稳定性。快速镜头、密集人群、透明材质、细小文字和复杂手部动作,仍然是更容易失败的区域。
**开放模型权重也不自动等于没有使用限制。**团队和企业在部署前仍应核对 Hugging Face 模型卡、基础模型协议、代码许可证以及适配器各自的授权范围,尤其是商业使用、再分发和生成内容责任条款。模型本体、基础模型和配套组件可能采用不同许可,不能只看其中一个仓库。
这是视频模型从“出片”走向“交付”的一步
**Open-H3-Regenerate-2K 解决的不是视频能不能生成,而是生成结果能不能进入真实交付流程。**过去两年视频模型的重点一直是动作幅度、镜头语言和提示词理解,但当内容要放到 2K 显示器、4K 电视或专业剪辑时间线上时,低分辨率下被掩盖的人脸、毛发、边缘和纹理问题会被迅速放大。
英伟达与 MIT 团队选择冻结 H3 主干、只训练细化 LoRA,是一条务实而非炫技的路线。它没有重新造一个完整视频基础模型,而是利用现有模型的运动先验,以 3D latent upscaling、三步去噪和快速 VAE 解码,把最昂贵的高分辨率阶段压到更可接受的范围内。
**这次开源真正值得关注的指标不是“最高4K”,而是2K重生成已经压到单张B200约22.45秒。**4K 是吸引注意力的上限,2K 才更可能成为开发者近期真正使用的档位;而能否在 H100、A100 乃至消费级显卡上稳定运行,以及长视频中的身份和纹理一致性,才决定它会不会从展示项目变成通用工具。
截至 2026 年 10 月 30 日,Open-H3-Regenerate-2K 已经给出了权重和推理实现,但其现实定位仍应是高端离线视频后处理模型,而不是实时增强器。对于已经在使用 H3 或其他视频模型制作草稿的团队,它补齐了最关键的高清交付环节;对于只有普通桌面显卡的个人用户,4K 重生成暂时仍更像能力展示,2K 与短片段处理才是合理起点。
参考来源
- Hugging Face:Open-H3-Regenerate-2K 模型页面:模型权重、模型卡、运行配置与许可信息的主要发布页面。
- GitHub:NVIDIA NVlabs/Sana:英伟达开放的配套推理代码仓库,可用于核对实现与后续更新。