一行改动,救活多Token预测
Soft-MTP 发现,标准多 Token 预测的梯度混合了有价值的 KL 自蒸馏信号与有害残差。研究者用一行不改变前向计算的代码恢复 KL 梯度,同时改善投机解码与下一 Token 预测。
标准 MTP 的问题,可能不是目标错了,而是梯度混在了一起
2026 年 10 月底,一项名为 Soft Multi-Token Prediction(Soft-MTP) 的新研究给多 Token 预测训练补上了关键一块:标准 MTP 梯度内部本来就存在自蒸馏信号,但它长期被一项噪声残差掩盖,结果是用于投机解码的 MTP 分支没有学到最理想的软分布,主模型的下一 Token 预测还可能被拖累。
多 Token 预测(Multi-Token Prediction,MTP)是一种让语言模型在同一位置并行预测多个未来 Token 的训练与推理方法。 它已经从研究性技巧逐渐变成前沿模型预训练和低延迟推理中的常用组件:主头继续预测下一个 Token,额外的 MTP 模块尝试预测更远位置,推理时再由主模型验证这些候选结果。
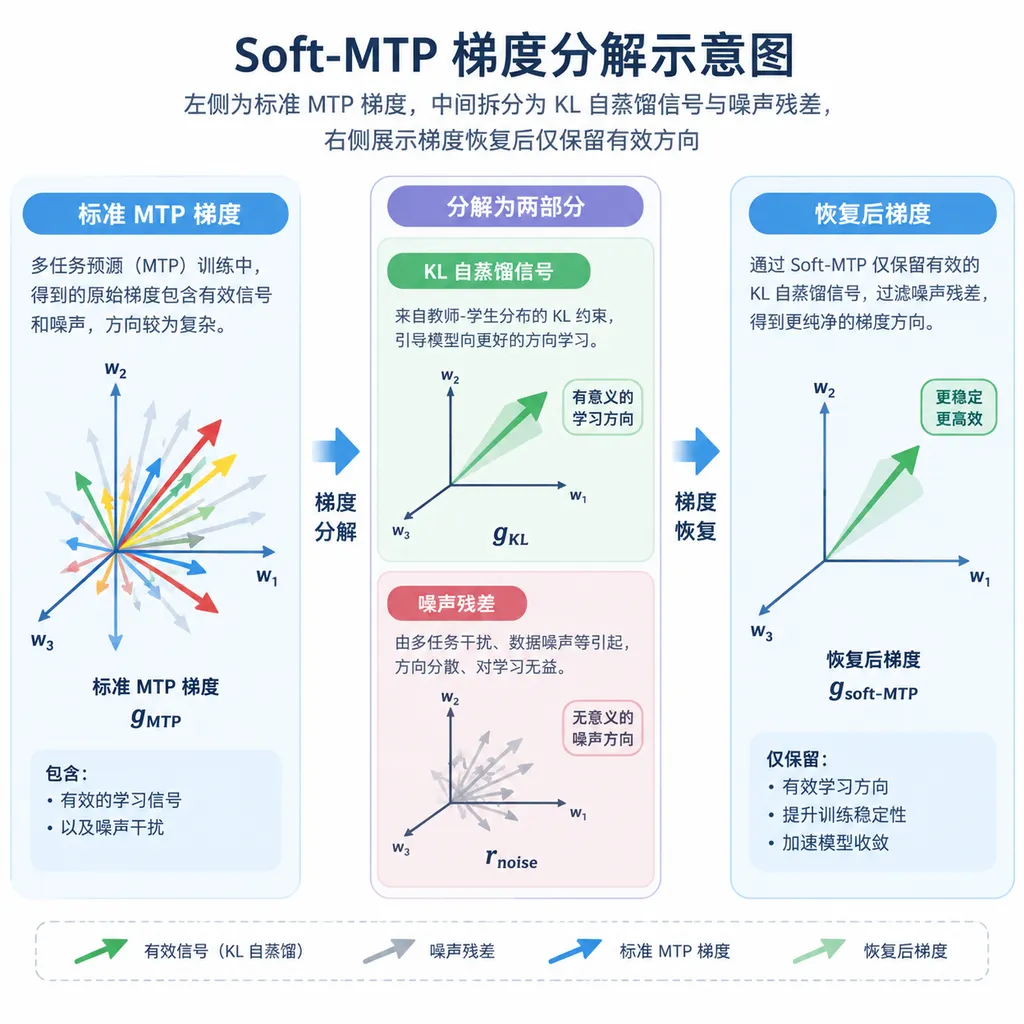
Soft-MTP 的核心判断很直接:标准 MTP 并不是完全缺少自蒸馏,而是没有把自蒸馏梯度单独提取出来。论文将标准梯度拆开后发现,其中一部分等价于希望 MTP 分布贴近下一 Token 预测分布的 KL 梯度;另一部分则是高噪声残差,它会干扰主干表示,伤害 next-token prediction,也就是模型最基础的逐 Token 建模能力。
研究团队给出的修复甚至只有一行:
h_ntp += h_mtp.detach() - h_mtp
这行代码在前向传播中的数值变化为零,却会重写反向传播路径。它不是一个新的损失函数大礼包,也不需要再挂一个教师模型,而是一次针对计算图的梯度手术。
一行代码为什么能改变训练结果
梯度恢复(gradient recovery)是一种保持前向输出不变、只调整反向梯度流向的计算图技巧。 在这行表达式里,h_mtp.detach() 与 h_mtp 的前向数值相同,因此两者相减严格为零,h_ntp 的激活值没有被改写,模型看到的 logits 和前向损失也不会因为这一行直接变化。
反向传播时的情况完全不同。detach() 会切断梯度,因此 h_mtp.detach() 对 h_mtp 的导数为零,而后面的 -h_mtp 仍贡献一个负方向梯度。换句话说,这个零值旁路在前向阶段像空气,在反向阶段却像一个定向阀门,允许训练者从标准 MTP 目标中恢复被抵消或掩盖的梯度成分。
KL 自蒸馏信号是让一个模型分支学习同一模型另一分支概率分布的训练信号。 它与只学习唯一正确 Token 的硬标签交叉熵不同:假设上下文后面既可能是“模型”,也可能是“系统”或“网络”,硬标签只告诉 MTP 头数据集中实际出现了哪一个词;软分布还会告诉它其他候选分别有多合理。
这类暗知识对投机解码尤其重要。投机解码并不只关心 MTP 头的 Top-1 是否偶然命中,而是关心草稿分布与主模型分布是否足够接近;两者越一致,连续候选 Token 被接受的概率通常越高,GPU 就越少回到逐 Token 串行解码。
接受率(acceptance rate)是投机解码中草稿 Token 通过目标模型验证的比例。 接受率低时,并行生成四个候选可能只接受第一个,剩下三个都要丢弃;接受率高时,一次验证可以推进多个 Token,MTP 才真正转化为端到端吞吐提升。
标准 MTP 为什么会伤到主模型
标准 MTP 的根本矛盾是多个未来位置共享主干表示,却不一定共享同一个最优梯度方向。 下一个 Token 距离当前上下文最近,条件最充分;第三个或第四个未来 Token 的不确定性更大,还依赖前面尚未生成的 Token。把这些目标等权或近似等权地压回同一份隐藏状态,相当于让一个表示同时服务于确定性不同的任务。
更远位置的监督并非没有价值。它能迫使模型学习更长程、更具规划性的语义表示,这也是 MTP 被用于预训练的原因之一;但如果梯度中存在较强残差,辅助任务就会从正则化变成干扰项。模型可能获得更好的远期猜测能力,却在最重要的下一 Token 困惑度、知识问答或代码补全准确率上付出代价。
Soft-MTP 的贡献在于把这场冲突从经验调参问题,推进到了梯度结构问题。过去常见做法是降低 MTP loss 权重、减少预测深度,或者冻结部分主干;这些方法本质上是在降低辅助梯度音量。新方法则试图识别其中真正有用的 KL 方向,并消掉会伤害 NTP 的残差,而不是把两者一起调小。
这一点比“再加一个蒸馏 loss”更值得关注。额外 KL 损失通常要明确计算教师分布、选择温度、处理词表维度,并权衡交叉熵与蒸馏项;Soft-MTP 所称的免费午餐,是直接利用标准训练图中已经隐含的关系,训练改动和工程侵入都更小。
Soft-MTP、MTP-D 和在线自蒸馏不是同一种方法
Soft-MTP 是从标准 MTP 梯度中恢复隐式 KL 信号的方法,而 MTP-D 是显式加入 KL 蒸馏损失的方法。 两者都使用“自蒸馏”这个词,也都服务于多 Token 预测,但训练路径并不相同,不能因为发布时间接近就混为一谈。
2026 年 3 月公开的 MTP-D 让主头充当教师,通过梯度分离向 MTP 头提供软目标,并用 TopN logits 控制显存和计算开销。相关实验选择 TopN=10,000,报告 MTP 头接受率提高 7.5%,配合循环扩展策略后,单头 MTP 的推理速度进一步提升 220.4%。这里的 220.4% 是特定设置下相对单头方案的提升,不应直接理解为所有模型部署都能获得 3.204 倍速度。
另一条路线是 2026 年 2 月出现的 Multi-Token Prediction via Self-Distillation。它让学生模型同时生成一段 Token,再由语言模型教师或 critic 对学生当前生成的结果给出在线信号;在 GSM8K 上,该工作报告平均解码速度超过 3 倍,同时相对单 Token 解码的准确率下降低于 5%。这更接近用在线策略把一个预训练自回归模型改造成可独立多 Token 输出的模型。
| 方法 | 核心训练信号 | 是否显式计算蒸馏目标 | 对主头的处理 | 已公开的代表性结果 | 工程特征 | |---|---|---:|---|---|---| | 标准 MTP | 多个未来位置的硬标签交叉熵 | 否 | 多任务梯度共同进入主干 | 已成为前沿预训练常用配方,但可能损害 NTP | 结构简单,梯度冲突明显 | | Soft-MTP | 从标准梯度中恢复隐式 KL 自蒸馏信号 | 不需要额外教师目标 | 用计算图技巧过滤有害残差 | 作者称在多类任务上稳定优于标准 MTP;当前参考材料未给出统一百分比 | 一行核心改动,前向数值不变 | | MTP-D | 主头到 MTP 头的显式 KL 蒸馏 | 是 | 教师 logits 停止梯度 | 接受率提高 7.5%;循环扩展设置下速度提高 220.4% | TopN=10,000,便于控制词表蒸馏成本 | | 在线自蒸馏 MTP | 教师对学生生成序列给出 on-policy 信号 | 是 | 教师或 critic 负责评分 | GSM8K 平均解码超过 3 倍,准确率下降低于 5% | 目标是改造成独立多 Token 模型 |
这张表也说明,Soft-MTP 并不是简单宣布“自蒸馏有效”。真正的新意是:研究者认为标准 MTP 梯度本身已经包含蒸馏,只是优化器实际接收到的是蒸馏信号与噪声残差的混合物。
对投机解码有用,不等于一定能得到同等幅度的速度提升
投机解码是一种先并行起草多个 Token、再由目标模型验证候选的无损加速方法。 在严格验证规则下,它可以保持目标模型原本的输出分布;但最终速度不仅取决于接受率,还取决于验证开销、批量大小、序列长度、KV Cache 布局、显存带宽和推理框架实现。
因此,Soft-MTP 即使稳定提升 MTP 头与主头的分布一致性,也不能直接推导出固定的 tokens/s 增幅。单请求、长上下文、内存带宽受限的场景,往往更容易从一次推进多个 Token 中受益;高并发服务已经能用 batching 填满 GPU 时,额外验证和 MTP 模块可能吃掉一部分收益。
判断这类方法是否真正有效,至少要同时看四组指标:
- 下一 Token 质量:验证集 loss、perplexity,以及知识、推理、代码任务是否回退。
- 草稿质量:平均接受长度、各预测深度的接受率,以及不同采样温度下的稳定性。
- 系统性能:端到端 tokens/s、首 Token 延迟、单请求完成时间和峰值显存。
- 训练成本:额外 FLOPs、通信量、激活显存,以及是否影响现有并行策略。
只报告 MTP loss 下降是不够的。MTP loss 更低可能只是更贴近训练集硬标签,不代表草稿分布更贴近主模型;只报告接受率同样不够,因为较重的 MTP 头可能让单步时间上升,最终吞吐反而不变。
这项工作的真正价值,是把一个辅助损失变成可分析对象
Soft-MTP 最值得开发者关注的地方,是它把 MTP 的效果拆成了可解释的梯度成分。 对训练团队而言,这意味着遇到主任务回退时,不必只在 loss coefficient 上盲扫超参数,而可以直接检查 NTP 梯度、MTP 梯度、恢复后的 KL 梯度之间的余弦相似度和范数比例。
一个合理的复现实验应该至少设置四个对照组:纯 NTP、标准 MTP、显式 KL 蒸馏 MTP,以及 Soft-MTP。训练 token 数、初始化、数据顺序和优化器参数必须一致,否则几个百分点的差异很容易被训练噪声吞没。对于采用张量并行、流水线并行或编译图的训练栈,还要确认 detach 旁路没有被编译器错误折叠,并用自动微分单元测试验证实际梯度。
Soft-MTP 也不是没有边界。它依赖作者对标准 MTP 梯度的分解在具体架构上成立;如果团队使用的是独立 draft model、树状候选头、不同层级的 MTP 模块,或者 MTP 头不与 NTP 隐藏状态形成论文假设中的关系,一行改动未必可以原样迁移。
“免费午餐”同样应该被谨慎理解。这里的免费主要指不需要额外教师模型、前向激活不变、核心实现成本低,而不是训练和推理完全没有额外成本。MTP 头本身仍会占用参数、计算和显存,投机验证也仍要落到具体推理引擎中。
判断:这是比堆更多预测头更聪明的一步
Soft-MTP 的方向是对的,因为 MTP 当前更缺的不是预测得更远,而是让远期预测与主模型真正一致。 当第二、第三、第四个候选的接受率不足时,继续增加预测头往往只是制造更多会被拒绝的草稿;先修复梯度,让已有预测头学到主模型的软分布,通常比盲目扩展深度更合理。
这项研究目前最需要补齐的是跨模型规模和真实推理栈的数据。参考材料只明确表示 Soft-MTP 在一系列任务上改善了标准 MTP,却没有给出一个可跨场景引用的统一速度或准确率百分比,因此现阶段不宜把它包装成确定的数倍加速方案。
但从开发实践看,一项只改反向图、几乎不碰前向接口的方法,试错门槛确实很低。对于已经在预训练中部署 MTP、又观察到 NTP 指标轻微回退的团队,Soft-MTP 值得优先做同等算力对照实验;对于只使用外置草稿模型的推理团队,它则更像一个训练思想,而不是可以直接复制的一行补丁。
截至 2026 年 10 月 30 日,Multi-Token Prediction 的竞争已经从“能不能一次猜多个 Token”,转向“怎样让多个候选既容易被接受,又不牺牲主模型能力”。Soft-MTP 没有发明新的巨大模块,而是从已有梯度里找回了一条被噪声遮住的学习信号——这类改动看起来小,反而可能更接近成熟训练配方真正需要的优化。
参考来源
- Soft-MTP 官方 GitHub 仓库:包含 Soft Multi-Token Prediction 的官方实现与复现材料。
- 作者在 Reddit r/MachineLearning 的论文介绍:概述标准 MTP 梯度中的 KL 自蒸馏信号、噪声残差及一行梯度恢复技巧。
- Soft-MTP Hugging Face 合集:汇总研究相关模型、权重与实验资源。