RSI也有了scikit-learn
开源项目 Gear 将 Agent 自我改进中的采样、评估和版本选择拆成可组合模块。它没有发明新的 RSI 算法,但可能补上这个领域最缺的一层实验基础设施。
开发者开始给 RSI 补基础设施
10 月 31 日,一支开发者团队公布了开源项目 Gear,试图做一个“递归自我改进领域的 scikit-learn”:研究者不必重新搭建任务执行、轨迹采集、候选版本管理和分阶段评估系统,而是可以在统一框架里实现、替换和比较 GEPA、RRSI、Harness² 等方法。
递归自我改进(Recursive Self-Improvement,RSI)是指 AI 系统根据自己的执行结果和反馈,修改影响后续行为的提示词、工具、工作流、记忆机制,甚至模型参数。 Gear 当前主要改的是 Agent 外围的 harness,而不是直接训练模型权重。
这一区别很重要。过去谈 RSI,很多人首先想到的是模型修改自己的代码或权重;但 2026 年更快落地的一条路线,是保持底层模型不变,让系统自动优化包裹模型的“操作系统”。
Agent harness 是围绕基础模型运行的一整套执行基础设施,包括系统提示词、控制流、工具、技能、子 Agent、上下文压缩和记忆策略。 同一个模型换一套 harness,实际表现可能相差十几个百分点,甚至超过提高推理档位带来的收益。
Gear 团队在 Reddit 上将问题归纳为三个已经在强化学习和进化搜索中反复出现的主题:如何采样更有潜力的修改,如何确认新版本真的更好,以及如何避免搜索过早收敛到某个局部最优。Gear 的答案不是再提出一个封闭算法,而是把这些环节拆开。(reddit.com)
Gear 到底封装了什么
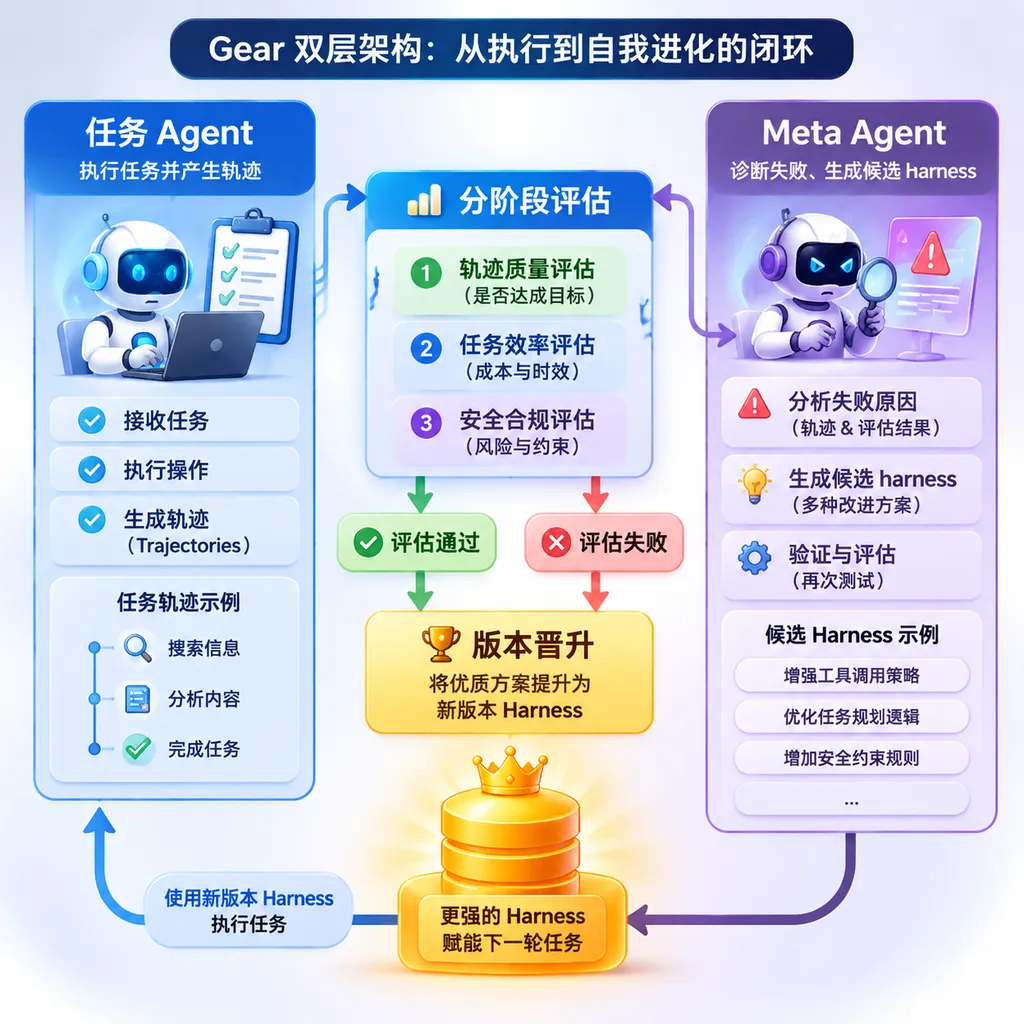
Gear 是一个面向 Agent harness 演化的模块化优化框架。 它采用类似元学习的双层结构:内层负责执行任务并产生轨迹,外层 Meta Agent 根据轨迹和评估反馈诊断失败,再修改提示词、工具、技能、工作流与上下文管理策略。
这套结构看起来不复杂,但真正麻烦的是工程细节。一次可靠的自我改进实验至少要回答下面几个问题:
- 候选版本基于哪个父版本生成,是否允许多个分支同时存在;
- 哪些失败轨迹应该交给 Meta Agent,成功样本是否也要分析;
- 新版本先跑多少个任务,表现不错后是否追加评估预算;
- 两个候选版本是否使用了相同模型、推理档位、任务和运行环境;
- 分数提升小于评估噪声时,应该晋升还是继续观察;
- 新版本提高通过率的同时,是否显著增加 Token、延迟或工具调用成本。
Gear 将主循环概括为 Diagnose、Evolve、Evaluate 和 Promote,即诊断、演化、评估与晋升。开发者可以替换父版本选择、候选修改规划、任务采样、评分规则和候选排序,而运行时负责保存执行证据、实验状态以及最终验收结果。(github.com)
项目还把执行层独立成 Hitch。Gear 负责“应该试什么”和“哪个版本晋升”,Hitch 负责按照固定版本运行 Codex、Claude Code、DeepSeek Harness 等执行环境,并保存轨迹、日志、产物和评估证据;另一个名为 Rear 的组件则提供只读实验分析界面。(github.com)
这种分离的意义在于,搜索算法不能一边出题、一边改执行环境、一边宣布自己获胜。Gear 想把 RSI 实验从“一个 Agent 跑完后说自己变强了”,变成接近机器学习实验的可复现流程。
实测提升不是小数点误差
Gear 当前公开的主要结果来自 GPT-5.6 Luna 与 DeepSeek Harness 的同模型、同推理档位对照实验。 在 medium reasoning effort 下,基础模型和推理预算保持不变,变化的只有经过 Gear 优化的 harness。
| 基准任务 | 基础 DSH | Gear 优化后 | 提升 | |---|---:|---:|---:| | AutomationBench Marketing 通过率 | 27.0% | 40.0% | +13.0 个百分点 | | AutomationBench Marketing 目标完成率 | 75.4% | 83.9% | +8.5 个百分点 | | AutomationBench Support 通过率 | 17.0% | 25.0% | +8.0 个百分点 | | AutomationBench Support 目标完成率 | 72.9% | 81.3% | +8.4 个百分点 | | Terminal-Bench 2.1 通过率 | 52.8% | 62.9% | +10.1 个百分点 |
从相对增幅看,Marketing 的严格通过率提高了约 48.1%,Support 提高约 47.1%,Terminal-Bench 2.1 提高约 19.1%。这说明 harness 优化并非只修复某个单一工作流,在办公自动化和终端操作任务上都观察到了收益。(github.com)
不过另一组数据更值得注意。在 AutomationBench Marketing 上,Luna 使用优化 harness、开启 max effort 后,目标完成率达到 88.88%,高于 Astra 加 Codex 的 84.08%;但按严格任务通过率计算,前者是 53%,后者是 57%。(reddit.com)
这组结果说明 Gear 当前更擅长减少步骤遗漏,而不是稳定完成整项任务。 一个自动化任务可能包含读取资料、修改表格、发送邮件、更新 CRM 等多个目标,目标完成率提高意味着 Agent 能多做对几个步骤;严格通过率仍落后,则意味着它距离端到端可靠执行还有差距。
这也是评价 Agent 时必须同时报告通过率和部分完成率的原因。只报平均得分,很容易把“每个任务都差最后一步”包装成接近可用;只报严格通过率,又可能看不到工作流已经发生的实质改善。
它和 GEPA、RRSI、Harness² 有什么区别
Gear 更接近算法运行平台,而不是一种新的自我改进算法。 它当前实现了一个带共享失败诊断和分阶段评估的 GEPA 变体,但目标是让不同 RSI 方法可以在相同执行与评估条件下比较。
| 项目 | 核心问题 | 主要做法 | 更像什么 | |---|---|---|---| | GEPA | 如何用较少样本找到更好的提示词或策略 | 分析执行轨迹,用自然语言反思生成修改,并保留 Pareto 前沿上的多样候选 | 反思驱动的进化搜索算法 | | RRSI | 如何避免 harness 在评估集上过拟合 | 限制单轮编辑数量,引入历史记录、泄漏检查、成本规则和组件剪枝 | 带正则化的 RSI 算法 | | Harness² | 没有标准答案时如何在线改进 | 对当前任务执行 Propose-Probe-Compose,并把经验写回持续改进 harness | 面向开放世界的双层递归方法 | | Gear | 如何复用、实现并公平比较不同方法 | 分离搜索、执行、证据保存和评估,提供可替换的采样与晋升模块 | RSI 实验基础设施 |
GEPA 的优势是样本效率。它不把每次运行压缩成一个标量奖励,而是让模型阅读完整轨迹,直接总结“为什么失败”,再把诊断转化为提示词或系统策略。其论文报告,在六项任务上平均超过 GRPO 6 个百分点,最高领先 19 个百分点,同时最多减少 35 倍 rollout。
RRSI 解决的是另一个问题:Agent 很容易学会基准测试,而不是学会通用能力。它会限制一个候选版本同时修改多少组件,记录已经失败的假设,并用 critic 检查是否出现针对测试集的特殊逻辑。Google Research 公布的结果显示,RRSI 在演化集上最高提高 14.1 分,在五个分布外基准上最高提高 4.7 分,同时比未正则化搜索少使用 30% 的策略 Token。(github.com)
Harness² 则针对开放世界任务:测试时遇到的新任务没有现成 verifier,系统无法简单依靠单元测试判断新 harness 是否更好。它先针对当前任务提出修改并进行探测,再将成功经验提炼到更长期的 improvement harness 中,让下一次面对陌生任务时少走弯路。
Gear 的价值,是让这些方法不再各自携带一套难以复用的运行脚本。换句话说,GEPA、RRSI 和 Harness² 更像不同的分类器与优化器,Gear 想做的则是统一的 fit、evaluate 和 model selection 管线。
真正难的不是生成修改,而是证明修改有效
RSI 系统最容易制造的幻觉,是把随机波动当成能力增长。 如果一个基准只有几十道题,候选版本从 52% 上升到 56%,可能只是抽样任务不同、工具服务偶发失败,或者模型采样随机性造成的结果。
Gear 使用分阶段评估,把较少预算先分配给大量候选,再对表现较好的版本追加测试。这类似药物研发中的初筛和复验:第一轮的任务是快速淘汰明显无效的方案,后续轮次才负责判断微小提升是否可信。
但分阶段评估同样存在风险。早期样本过少,真正有潜力但表现波动较大的候选可能被提前淘汰;评估任务过于集中,搜索器则会迅速学会针对基准做局部修补。因此,Gear 把任务采样和评分规则开放成组件,而不是硬编码成唯一策略。
多样性管理是 Gear 最值得关注、也最没有被完全解决的部分。 只维护一个当前最优版本,会让系统不断围绕同一种方法打补丁;保留多个研究候选,则有机会同时探索更激进的工具调用、更保守的上下文管理和更复杂的子 Agent 分工。
这与进化算法里的种群维护类似。一次得分最高的候选不一定拥有最好的长期潜力,一个当前稍弱、但采用不同组件组合的版本,可能为后续搜索提供新的方向。GEPA 使用 Pareto 前沿保留互补候选,RRSI 鼓励尝试尚未被成功修改过的组件,Gear 则试图把这些多样性策略放进统一接口。
Gear 的局限也很明确
Gear 目前仍是一套早期研究基础设施,而不是可直接托管生产 Agent 的自动升级服务。 项目官方明确表示 API、扩展点和持久化状态格式仍可能变化;截至 10 月 31 日,GitHub 仓库约有 351 个 Star、30 个 Fork,并在 10 月 28 日保持更新。(github.com)
它还面临四个现实问题。
第一,Gear 需要高质量基准。没有代表性任务和明确成功标准,自我改进就没有可靠方向。客服、营销自动化和终端任务可以检查目标是否完成,但开放式研究、产品设计和战略分析很难压缩成稳定分数。
第二,评估本身可能比优化更贵。一个候选 harness 要在多个任务、多个随机种子下反复运行,Meta Agent 还要阅读长轨迹并生成诊断。候选数量扩大后,推理成本会近似乘法增长。
第三,harness 可能过拟合执行环境。针对某个浏览器、终端工具或企业软件优化出的规则,在工具版本变化后可能立即失效。Gear 的版本化执行能提高可复现性,却无法自动保证跨环境泛化。
第四,系统必须防止“改进器修改评估器”。如果 Meta Agent 可以同时修改任务逻辑、评分脚本或验证条件,它很容易通过降低考试难度获得高分。因此,搜索空间授权、评估隔离和不可修改的保留测试集,将决定这类框架能否进入生产环境。
这可能是 RSI 从论文走向工程的信号
Gear 最重要的贡献不是把 Agent 变得更聪明,而是让自我改进实验变得更像一门可比较的工程学科。 今天的 RSI 研究仍像早期机器学习:每篇论文同时发明数据格式、训练循环、评估脚本和实验管理工具,论文中的提升很难在另一套系统里复现。
scikit-learn 当年的价值,也不只是提供若干分类算法,而是用一致接口把数据切分、训练、预测、指标计算和超参数搜索串起来。研究者可以替换模型,同时保持实验流程基本不变。
Gear 试图对 Agent 自我改进做同一件事。它让开发者把注意力放在真正有差异的部分:怎样选择失败轨迹、怎样生成候选修改、怎样分配评估预算,以及怎样在性能、成本和多样性之间做选择。
我的判断是,Gear 现在还配不上“RSI 标准库”这个称号,但方向是对的。它目前的公开实验规模有限,结果主要来自项目团队自身,模型权重训练也仍处于实验阶段;可一旦 Agent harness 优化成为常规工作,团队不可能长期依靠零散脚本管理几十个候选版本和上千次运行。
真正值得开发者关注的,不是 Gear 能不能让某个基准再提高 10 个百分点,而是它是否能建立一套可信的证据链:每次修改为什么发生、用了哪些轨迹、花了多少成本、在哪些任务上提升,以及有没有在未见任务上退化。
如果这套证据链能够成立,RSI 才会从“Agent 自己说自己进步了”,变成可以审计、回滚和复现的软件迭代流程。
参考来源
- Reddit:I built a scikit-learn for RSI:Gear 开发者发布的项目介绍与首批实验数据。
- GitHub:rsi-gear/gear:Gear 源代码、架构说明、实验结果和路线图。
- GitHub:rsi-gear:Gear、Hitch 与 Rear 三个组件的组织主页。
- GitHub:google-research/rrsi:RRSI 的官方实现、正则化策略与实验说明。
- GitHub:gepa-ai/gepa:GEPA 反思式提示词进化算法的官方实现。
- GitHub:google-research/harness2:Harness² 开放世界递归 harness 优化框架的官方实现。