BootGPT:把模型塞进启动扇区
BootGPT 用 510 字节汇编实现完整推理引擎,从后续磁盘扇区加载 11.5KB INT8 模型,在操作系统启动前生成虚构的 Linux 日志。
BootGPT:把语言模型塞进启动扇区
10 月 31 日,开发者 kerlenton 开源了 BootGPT:一个不依赖操作系统、不需要 C 运行时,直接在传统 PC 启动阶段运行的微型语言模型。它会在机器开机后生成一段似是而非的 Linux 启动日志,包括时间戳、PCI 设备地址、内存区间和 ACPI 事件——其中大部分硬件从未真实存在。
**BootGPT 是一个运行在 x86 启动环境中的字符级语言模型实验。**它的核心卖点不是回答问题,也不是把 ChatGPT 搬进 BIOS,而是把神经网络推理引擎压缩到主引导记录的 510 字节代码区,再从后续 23 个磁盘扇区载入约 11.5KB 的 INT8 权重。整个过程发生在操作系统和内核接管机器之前。(github.com)
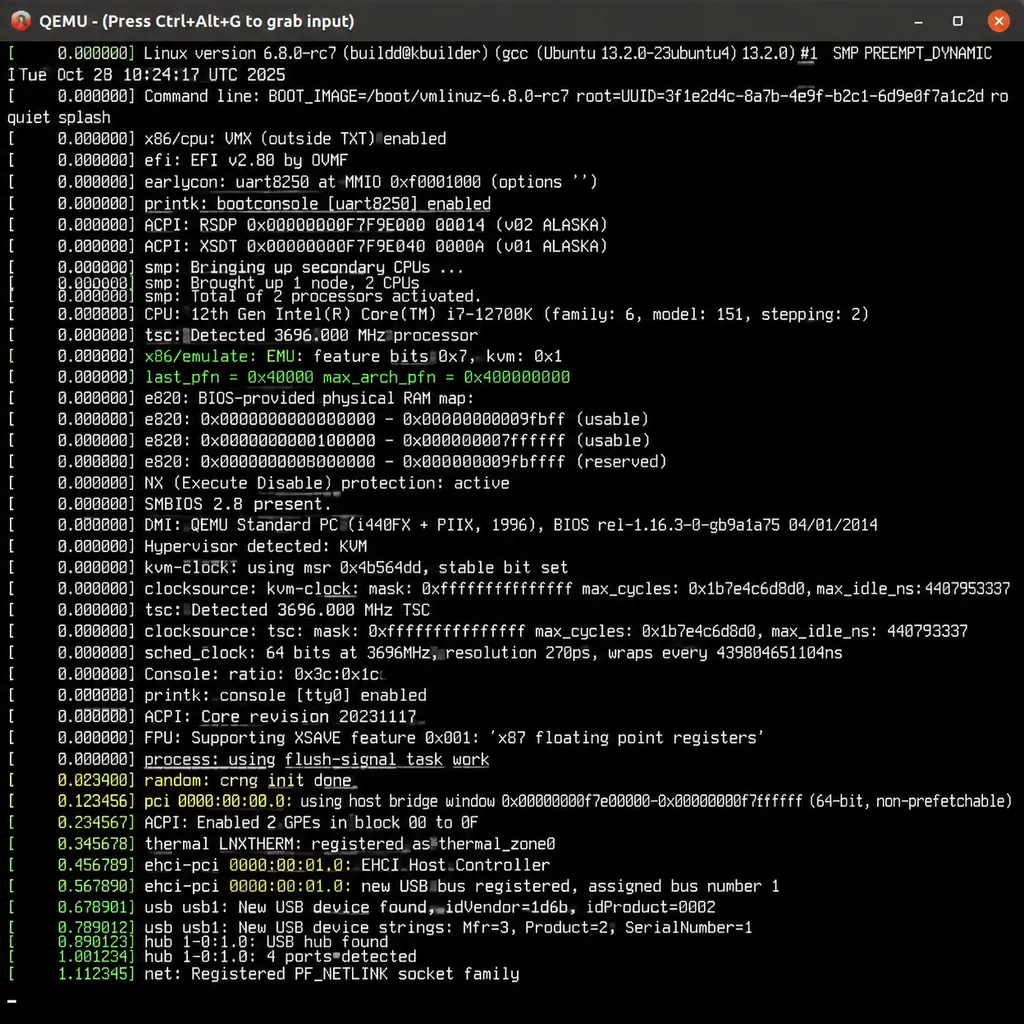
这更像一件神经网络版的「启动扇区艺术品」,而不是一个追求实用能力的新模型。但它并非简单地把预生成文本写进磁盘:屏幕上的每一个字符,都来自实时执行的神经网络前向传播。
510 字节里装的不是整个模型
**BootGPT 最容易引起误解的地方,是所谓「模型住在启动扇区」并不意味着全部权重都被塞进了 512 字节。**传统 BIOS 会把磁盘第一个扇区加载到内存地址 0x7C00 并执行,这个扇区总共只有 512 字节,其中最后两个字节还必须保留为 0x55AA 启动签名,因此真正可用于代码的空间只有 510 字节。
BootGPT 放进这 510 字节的是完整推理引擎、磁盘读取逻辑、字符输出逻辑和采样器;词表、权重、偏置与少量字符串则位于随后 23 个扇区。启动后,程序通过 BIOS 的 int 13h 中断读取这些数据,再通过 int 10h 将生成字符直接打印到屏幕。(github.com)
换句话说,BootGPT 做到的不是「512 字节模型」,而是「510 字节神经网络运行时」。这个区别很重要,因为 11.5KB 权重虽然仍然小得离谱,但已经是代码空间的 20 多倍。
| 组成部分 | 大小或规格 | 作用 | |---|---:|---| | MBR 启动扇区 | 512 字节 | 包含 510 字节推理代码和 2 字节启动签名 | | INT8 模型及数据 | 约 11.5KB | 存放词表、嵌入、权重、偏置和字符串 | | 数据扇区 | 23 个 | 由启动代码读取到内存 | | 运行模式 | x86 16 位实模式 | 不依赖内核、操作系统或标准库 | | 最低指令集 | Intel 386 级别 | 推理使用 32 位寄存器和整数乘除法 | | 开源协议 | MIT | 可自由研究、修改和再发布 |
BootGPT 生成的磁盘镜像由 boot.bin 和 weights.bin 直接拼接而成,构建脚本还会检查启动代码是否超过 512 字节。官方建议优先使用 QEMU 运行;如果写入 U 盘,也只能在仍支持传统 BIOS 启动的设备上直接引导。(github.com)
这是语言模型,但不是 Transformer
**BootGPT 使用的是一个只有单隐藏层的字符级前馈网络,而不是 GPT、Llama 或 Qwen 使用的 Transformer。**它没有注意力机制,没有 KV Cache,没有子词分词器,也没有多层残差结构;模型只观察最近 8 个字符,然后预测下一个字符。
当前训练脚本定义了 64 个字符的词表、8 字符上下文、6 维字符嵌入和 96 个隐藏单元。8 个字符首先被转换成一个 48 维向量,经过 96 单元的隐藏层后,再输出 64 个字符的分数。按照嵌入、两层权重和偏置计算,模型合计约 11296 个可训练参数。(github.com)
| 模型参数 | BootGPT 配置 | |---|---:| | 词表大小 | 64 个字符 | | 上下文长度 | 8 个字符 | | 嵌入维度 | 6 | | 隐藏层数量 | 1 层 | | 隐藏单元 | 96 | | 参数量 | 约 1.13 万 | | 权重量化 | INT8 | | 激活定点格式 | Q12 | | 输出分数格式 | Q8 | | 训练步数 | 40000 步 | | Batch Size | 512 |
这个架构甚至比早期神经语言模型还要朴素,但它恰好适合启动扇区:输入长度固定,矩阵尺寸固定,不需要动态分配内存,也不需要实现指数函数、归一化和复杂缓存管理。
**BootGPT 真正聪明的选择,是让模型结构迁就汇编代码,而不是让汇编代码迁就模型结构。**训练阶段使用的激活函数是 x / (1 + |x|) 形式的 softclip,它不要求计算 tanh 或浮点指数;量化缩放因子被限制为 2 的幂,缩放操作可以直接转换成位移指令;主要矩阵计算则由整数乘法 imul 完成。
隐藏层激活需要的除法由 x86 的 idiv 指令处理。最终采样也没有实现标准 softmax,而是给每个字符的输出分数叠加一个伪随机噪声,再选择分数最高的字符。随机数来自一个线性同余生成器,种子取自 BIOS 计时器,因此每次启动时生成内容会有所变化。(github.com)
这种做法牺牲了概率分布的精确性,却省掉了大量代码。对于一个目标只是生成「看起来像启动日志」文本的模型,这笔交换非常划算。
为什么它生成的日志看起来还算像样
**BootGPT 的输出质量依赖的不是模型理解了 Linux,而是启动日志本身具有极强的格式重复性。**真实的 dmesg 日志中充满固定模板:方括号时间戳、PCI 总线地址、十六进制设备编号、驱动名称、内存区间和协议注册信息。模型只要学会这些局部规律,即使不了解字段含义,也能拼出视觉上足够可信的文本。
训练数据同样为这个目标做了特殊设计。项目中的 corpus_gen.py 会生成约 3.2MB 的合成 dmesg 数据,并让同一次虚构启动过程共享内核版本和磁盘标识。这样可以减少随机字段之间的冲突,让只有 8 字符上下文的模型显得更连贯。(github.com)
这与大型语言模型依靠数万 Token 上下文保持主题完全不同。BootGPT 不知道自己正在描述一台机器,也无法记住几行前出现过什么设备;它只是利用启动日志的高重复度,在字符层面延续局部模式。
因此,它经常能够正确生成类似 PCI 地址和 Linux 版本号的结构,却会在设备名称、数值边界或单词内部突然失真。这些错误不是偶发幻觉,而是模型能力边界的直接体现:8 个字符足够判断当前位置大概应该出现数字、冒号还是字母,却不足以维护一整行日志的语义一致性。
比 sectorllm 更小,但能力也更窄
**BootGPT 并不是第一个在操作系统启动前运行语言模型的项目,但它选择了更极端的代码体积目标。**此前的 sectorllm 已经能用 1189 字节 x86 实模式汇编实现完整 Llama 2 推理,运行一个 26 万参数、5 层、8 个注意力头的 stories260K Transformer。(github.com)
| 项目 | BootGPT | sectorllm | |---|---:|---:| | 推理引擎大小 | 510 字节 | 1189 字节 | | 模型类型 | 字符级单隐藏层网络 | Llama 2 Transformer | | 参数量 | 约 1.13 万 | 26 万 | | 上下文单位 | 字符 | Token | | 注意力机制 | 无 | 有,8 个注意力头 | | 模型层数 | 1 个隐藏层 | 5 层 Transformer | | 量化方式 | INT8、2 的幂缩放 | INT8 全局缩放 | | 主要任务 | 生成虚构启动日志 | 生成儿童故事文本 | | 核心目标 | 把运行时压进 MBR | 在启动环境实现完整 Transformer |
sectorllm 更接近我们通常理解的 LLM:它包含注意力、Transformer 层和 Token 词表,理论上也可以替换成更大的兼容模型。BootGPT 则主动放弃通用能力,将模型压缩成只会做一件事的专用网络。
**从工程难度看,BootGPT 的 510 字节约束反而更加苛刻。**sectorllm 的运行时约为 BootGPT 的 2.33 倍,并通过 unreal mode 使用更大的内存空间;BootGPT 则坚持把整个推理循环、BIOS 接口和交互逻辑放进标准 MBR 代码区。
但从模型能力看,两者并不在同一量级。BootGPT 无法进行对话、执行指令或生成正常文章,甚至不能真正识别自己运行在哪台机器上。它展示的是推理实现可以被压缩到什么程度,而不是小模型已经能在 11.5KB 内获得通用智能。
最值得关注的是软硬件协同验证
**BootGPT 最有工程价值的部分不是尺寸纪录,而是训练代码与汇编运行时之间严格对应的验证方式。**项目的 Python 训练脚本不仅负责训练和量化,还实现了一套与汇编代码逐指令对齐的整数模拟器。
模拟器会复现 x86 idiv 的截断规则、定点缩放、INT8 权重乘法和线性同余采样器。相同输入和随机种子下,Python 模拟器与 QEMU 中启动代码生成的字符可以逐一比较,目标是做到字符级完全一致。(github.com)
这套方法解决了极低层推理中最麻烦的问题:模型在 Python 中表现正常,并不意味着移植到整数汇编后仍然正常。符号扩展、寄存器覆盖、除法取整和溢出规则中的任何差异,都可能让输出在几个字符后完全分叉。
对于开发 NPU 内核、微控制器推理框架或自定义量化算子的团队,这种「先定义位精确参考实现,再编写底层运行时」的方法比 BootGPT 本身更值得复用。它把神经网络部署从凭感觉调试,变成可以逐层、逐神经元对账的确定性工程。
它没有商业价值,但很有启发性
**BootGPT 不是边缘 AI 产品路线的预演,而是一场目标清晰的 sizecoding 实验。**它没有传感器输入,不能读取真实硬件信息,生成的启动日志也是虚构的;在现代 PC 上,传统 BIOS 和兼容支持模块正在逐渐消失,直接运行这类 MBR 程序往往还不如启动 QEMU 方便。
它也不能证明「语言模型可以取代操作系统」。BootGPT 依然依赖 BIOS 提供磁盘、显示器、键盘、计时器和重启服务,而且只完成了一个固定的文本生成循环。没有文件系统、驱动调度、内存保护、网络协议栈,更谈不上进程管理。
**BootGPT 真正证明的是,当任务足够窄、数据格式足够稳定时,语言模型可以被压缩成一种极小的概率程序。**传统程序员可能会手写几十条日志模板,再随机替换设备号;BootGPT 则训练一个 1.13 万参数网络,让模型自行学习模板之间的统计规律。
在如此狭窄的任务里,神经网络并不一定比模板程序更可靠,也很可能更慢。但它能够用同一套矩阵计算同时表达时间戳、十六进制字段、单词片段和换行结构,这正是神经网络作为「数据压缩后的行为生成器」最直观的展示。
BootGPT 当然不会改变大模型行业,却把模型部署讨论中经常被忽视的一件事摆到了台面上:推理框架并不天然需要数百 MB,复杂度取决于模型结构、数值格式、硬件接口以及开发者愿意放弃多少通用性。
对于普通用户,它是一段会在开机时做梦的代码;对于底层开发者,它则是一份相当漂亮的提醒——模型和运行时如果从一开始就共同设计,11.5KB 权重与 510 字节代码,也能构成一个真正运行的语言模型系统。
参考来源
- BootGPT 官方 GitHub 仓库:项目说明、运行方式、模型结构概览、演示文件及 MIT 开源代码。
- BootGPT 训练与量化脚本:包含词表、上下文、隐藏层、训练参数、INT8 量化和整数模拟器实现。
- BootGPT 启动扇区汇编:包含 BIOS 磁盘读取、字符输出、神经网络推理和采样逻辑。
- sectorllm 官方 GitHub 仓库:1189 字节 Llama 2 推理引擎,用于对比启动环境中的 Transformer 实现。
- sectorlisp-nn 官方 GitHub 仓库:在启动阶段通过 Lisp 解释器运行神经网络的相关实验。