商汤Loop-9B:循环挑战27B
商汤开源SenseNova Loop-9B-Preview,通过共享权重的循环Transformer增加计算深度,以9B参数挑战27B模型,但更少参数并不等于更低延迟。
10月30日,商汤科技开源了SenseNova Loop-9B-Preview,一款试图用9B参数挑战27B级能力的多模态模型。
这次发布最值得关注的并不是又一个9B模型,而是商汤选择了一条与堆参数不同的路线:让同一组Transformer层循环执行,用更多计算步骤换取更深的信息处理能力。官方公布的结果显示,SenseNova Loop-9B-Preview在办公、PPT生成、自动化与智能体任务中超过Qwen3.5-27B,并通过mHC结构进一步提升复杂推理能力。
不过,9B挑战27B不等于用三分之一的计算成本获得相同性能。SenseNova Loop-9B-Preview只有约9B套独立参数,但一次前向传播需要执行56次解码器层计算,官方还将其推理实际参数规模标记为约14.6B。它节省的是权重存储和显存占用,付出的则是更多串行计算。
这是一笔有吸引力、但不能只看参数数字的架构交易。
SenseNova Loop-9B是什么
SenseNova Loop-9B-Preview是商汤推出的开源多模态语言模型,面向长上下文、代码、办公自动化和智能体工作流。
模型支持文本与图像输入,输出形式为文本,最长训练上下文达到262,144个token。官方权重采用Apache 2.0许可证发布,开发者可以进行研究、微调和商业化使用。(huggingface.co)
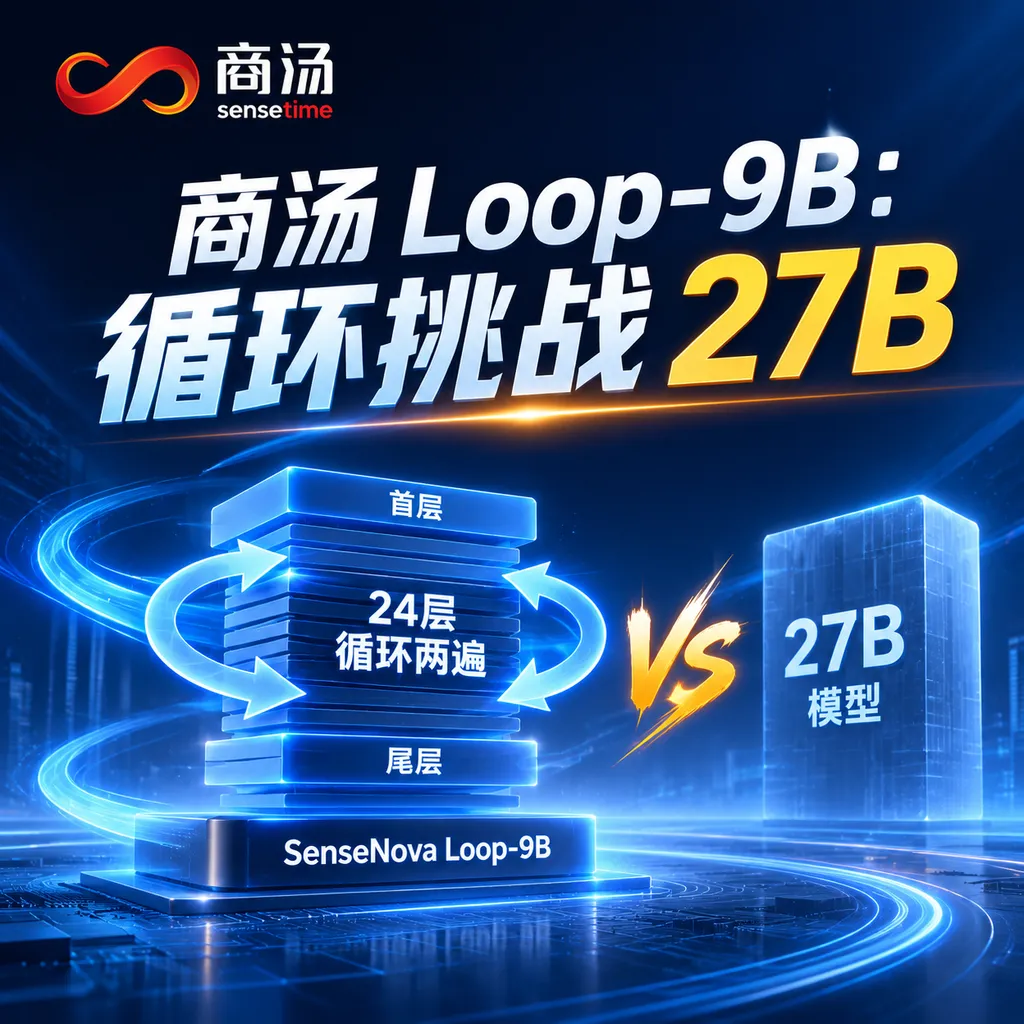
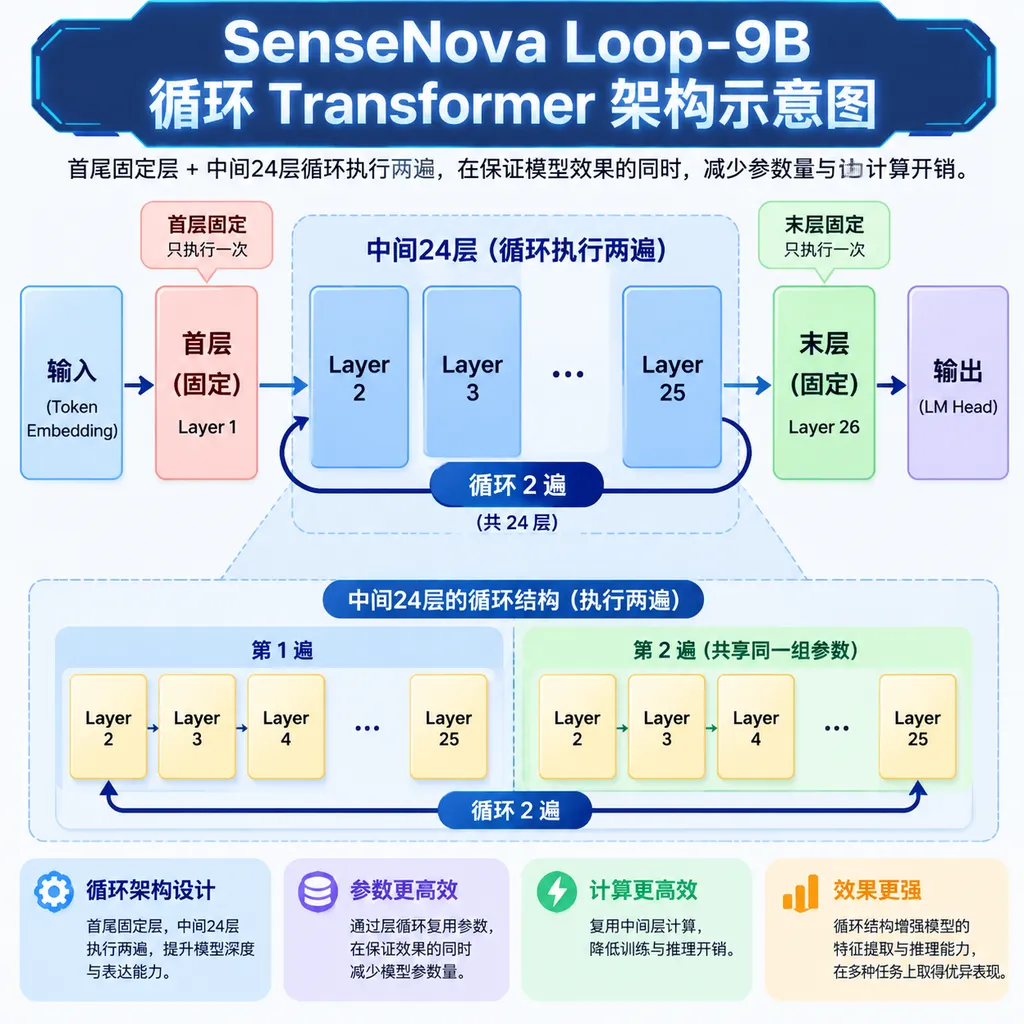
SenseNova Loop-9B-Preview共有32层独立解码器,其中第0至3层和第28至31层只执行一次,中间第4至27层组成包含24层的循环模块,并连续执行两遍。因此,模型实际完成了56次解码器层计算,却只需要保存32层对应的权重。
如果把中间24层记作模块B,那么普通模型的计算路径是B(h),SenseNova Loop-9B的计算路径则是B(B(h))。第二轮并不是简单重复输入,而是继续处理第一轮已经提炼过的隐藏状态。
这种设计类似让同一支分析团队对材料进行两轮审阅:第一轮建立结构和线索,第二轮沿着已有结论继续推导。团队人数没有增加,但处理流程变深了。
循环Transformer真正改变了什么
Looped Transformer是一种重复调用共享参数层、以增加有效计算深度的Transformer架构。
传统稠密模型通常通过增加层数、隐藏维度或参数规模提升能力,但新增一层往往意味着新增一套权重。循环Transformer则重复执行已有层,在不同比例地增加模型文件大小的情况下延长计算路径。
SenseNova Loop-9B的32套解码器权重最终产生56层的执行深度,执行次数增加了75%。这使它在存储层面仍接近9B模型,在计算层面却明显重于普通9B模型。(huggingface.co)
| 指标 | SenseNova Loop-9B-Preview | Qwen3.5-27B | 对实际使用的影响 | |---|---:|---:|---| | 标称参数规模 | 约9B | 27B | Loop-9B权重存储压力更低 | | 官方标注推理参数规模 | 约14.6B | 27B | Loop-9B不能按普通9B估算计算量 | | 独立解码器层 | 32层 | 64层 | Loop-9B保存的层数更少 | | 单次前向层执行次数 | 56次 | 64次 | 两者实际计算深度已经相当接近 | | 原生或训练上下文 | 262,144 token | 262,144 token | 都面向长文档与多模态工作流 | | 输入形式 | 文本、图像 | 文本、图像 | 均为原生多模态模型 | | 开源许可证 | Apache 2.0 | Apache 2.0 | 均允许较宽松的商业使用 |
Qwen3.5-27B拥有27B参数和64层语言模型,而SenseNova Loop-9B以56次层执行逼近其计算深度。因此,商汤所谓9B挑战27B,更准确的表述应该是:用约9B的独立权重和接近27B模型的层执行深度,换取更高的参数利用率。(huggingface.co)
mHC不是装饰,而是循环能否稳定的关键
mHC是Manifold-Constrained Hyper-Connections的缩写,即流形约束超连接,是一种通过多路残差流和受约束信息混合改善深层信号传递的连接机制。
循环执行同一组层会带来一个直接问题:信息可能在反复变换中逐渐失真、坍缩或被放大。普通残差连接只有一条主要信息通道,面对重复计算时未必能够稳定保留不同层次的特征。
SenseNova Loop-9B在循环模块中设置了两条残差流,并通过可学习映射决定每一层从哪里读取信息、如何混合两条信息流,以及如何把新结果写回残差状态。模型还使用20次Sinkhorn迭代对流间混合映射进行约束,避免信息路由在训练过程中变得过于极端。(huggingface.co)
商汤公布的消融实验显示,加入mHC后,GPQA Diamond提高4.42分,TeamBench提高13.34分。前者主要考察高难度科学推理,后者更接近需要多步骤协作、规划和工具使用的智能体任务。
TeamBench提升超过13分尤其值得注意。循环架构的价值可能不在短问答,而在需要模型持续维护状态、反复修正方案的长流程任务中。换句话说,让模型多想一遍,对Agent的帮助可能大于对百科问答的帮助。(ithome.com)
商汤把优势押在办公和Agent,而不是聊天跑分
SenseNova Loop-9B的产品定位不是通用聊天小模型,而是面向复杂生产任务的多模态工作模型。
官方重点展示了PPT设计、数据分析、代码生成、办公协作和外部工具交互等场景,并宣称模型在WorkBuddy Bench、RaccoonPPT Bench和AutomationBench上超过Qwen3.5-27B。
这几个评测的共同点是任务链较长。模型不只是回答一个问题,而是需要读取文档、理解指令、规划步骤、生成结构化内容,有时还要根据工具返回结果继续执行。此类场景更依赖有效计算深度,也更容易体现循环架构的优势。
| 评测或能力 | 主要考察内容 | 商汤公布的结论 | |---|---|---| | WorkBuddy Bench | 办公任务理解与执行 | 超过Qwen3.5-27B | | RaccoonPPT Bench | PPT规划、内容组织与视觉生成 | 超过Qwen3.5-27B | | AutomationBench | 自动化流程与工具调用 | 超过Qwen3.5-27B | | GPQA Diamond | 高难度科学推理 | mHC带来4.42分提升 | | TeamBench | 多步骤智能体协作 | mHC带来13.34分提升 |
目前这些结果仍应被视为厂商评测,而不是已经得到社区充分复现的统一结论。官方模型卡的技术报告状态仍为TBD,也没有完整披露所有评测的提示词、推理预算、采样设置和比较模型部署参数。(huggingface.co)
对于Agent评测而言,这些细节尤其重要。是否开启思考模式、最大生成长度、工具调用失败后的重试策略,甚至系统提示词的写法,都可能带来数个百分点乃至更大的差距。
因此,SenseNova Loop-9B已经证明了循环深度值得测试,但还没有证明所有9B循环模型都能稳定替代27B模型。
9B不意味着普通电脑直接满血运行
模型参数更少通常能降低权重内存,但循环执行不会自动降低推理延迟。
SenseNova Loop-9B官方仓库中的模型文件合计约38.2GB,现有导出精度以BF16主干权重为主,mHC路由参数使用FP32。开发者如果希望在16GB显存或统一内存设备上运行,通常需要依赖4bit等量化版本,而不能把9B参数直接等同于9GB显存。(huggingface.co)
官方核对过的推理环境使用Transformers 5.18.0、PyTorch 2.11.0和CUDA 13.0,并需要通过trust_remote_code加载定制模型实现。这意味着它目前还不是一个可以无缝替换普通Llama或Qwen权重的标准架构。
部署成熟度也仍处于Preview阶段。GitHub给出的LightLLM示例采用四张GPU,SGLang支持则需要使用包含SenseNova Loop适配代码的特定版本;官方虽然已经提供MTP推理加速,但Dspark与Dflash2仍在训练和开发中。(github.com)
对开发者来说,Loop-9B的主要优势可能首先出现在显存受限但算力相对充足的环境。例如同一张GPU装不下27B的高精度权重,却能够装下量化后的Loop-9B,并接受更长的单token生成时间。
对追求实时交互的应用来说,结果可能相反。循环层必须顺序执行,第二轮无法绕过第一轮,因此首token延迟和逐token速度未必能达到普通9B模型的水平。
参数效率正在成为新的竞争维度
参数效率是模型用单位权重规模获得推理能力的能力,它与实际推理效率并不是同一个指标。
过去两年的开源模型竞争主要围绕参数规模、MoE激活参数、上下文长度和量化精度展开。SenseNova Loop-9B提出了另一种维度:同一组参数应该被使用多少次。
这条路线并不新鲜,循环网络、通用Transformer和迭代推理都曾探索共享权重,但商汤把它推进到了多模态、长上下文和Agent场景,并给出了可以直接下载的9B级模型。它的意义不只是又刷新几项榜单,而是重新提醒行业:模型容量不只取决于存了多少知识,也取决于每次回答时愿意做多少步计算。
SenseNova Loop-9B还保留了动态计算的想象空间。商汤表示后续将探索自适应迭代次数,让简单问题少循环、复杂问题多循环。如果这一机制能够稳定工作,模型就可能从固定执行56层变为按任务难度动态分配计算预算。
这会比当前版本更重要。固定循环只是用延迟换能力,自适应循环才可能同时改善平均成本和复杂任务上限。
谁值得现在尝试
SenseNova Loop-9B目前更适合做架构验证和垂直任务测试,而不是未经评估就替换生产模型。
以下几类团队值得优先测试:
- 正在开发PPT、表格、报告生成等办公Agent的团队;
- 需要处理超长文档、截图和图文混合资料的开发者;
- 显存不足以部署27B模型,但能接受额外推理延迟的本地应用;
- 研究参数共享、循环深度、MTP或自适应计算的模型团队;
- 希望针对企业任务轨迹继续进行SFT或DPO训练的开发者。
以下场景则应该保持谨慎:
- 对首token延迟和吞吐量要求极高的实时产品;
- 严格依赖标准Transformers、vLLM稳定版本的生产系统;
- 只看通用知识问答、数学或代码单项排行榜的模型选型;
- 无法接受自定义模型代码和Preview依赖环境的企业部署。
OpenAI Hub观点:9B打27B成立,但只成立了一半
SenseNova Loop-9B最有价值的地方,是证明模型可以用重复计算提高参数利用率,而不是证明参数规模已经不重要。
商汤确实把32套解码器权重扩展成了56次层计算,并在多个办公和Agent评测中给出超过Qwen3.5-27B的结果。从模型存储、下载体积和微调成本看,这条路线具备现实意义。
但它没有凭空消除计算成本。Loop-9B实际推理参数规模约14.6B,层执行次数只比Qwen3.5-27B的64层少8次。开发者得到的是更高的权重复用率,而不是普通9B模型的速度与27B模型的能力同时免费获得。
SenseNova Loop-9B因此更像一款架构预告,而不是已经成熟的效率答案。技术报告尚未发布、第三方复现仍然有限、部署框架还需要定制适配,这些都说明Preview后缀不是客套话。
即便如此,它仍然是近期最值得研究的国产开源模型之一。如果后续版本能加入稳定的自适应循环,让模型根据任务难度决定执行一遍、两遍还是更多遍,循环Transformer可能会成为继MoE之后又一条重要的扩展路线。
参考来源
- SenseNova Loop GitHub仓库:商汤官方代码、模型架构、部署方式及Apache 2.0许可证说明。
- SenseNova Loop-9B-Preview模型页面:官方权重、技术规格、上下文长度与运行环境信息。
- Qwen3.5-27B模型页面:Qwen3.5-27B官方参数规模、层数和上下文信息。
- IT之家发布报道:商汤开源时间、榜单结论及mHC消融实验数据。