姚期智团队让世界模型学会证明
清华姚期智团队提出代数世界模型 AWM,让 AI 从交互中提炼规则,再用 Lean 4 证明目标能否实现。它比生成视频更强调规律、可解释性与可验证性,但距离建模真实物理世界仍有明显距离。
姚期智团队让世界模型学会证明
清华大学姚期智、袁洋团队提出了一条不同于视频生成的世界模型路线:先让 AI 从陌生环境中归纳出对象和规则,再把这些规则写成可执行、可检查的数学模型,最后用形式化证明判断目标能否实现。
这套框架名为代数世界模型(Algebraic World Model,AWM)。论文《Algebraic World Model: From Exploration to Proofs》于 2026 年 10 月 29 日提交,11 月 1 日由清华大学交叉信息研究院团队公开介绍,作者包括潘冠成、谭淇心、袁洋与姚期智。(arxiv.org)
代数世界模型是一种把环境表示为“类型化对象、状态转换规则和目标条件”的显式模型。 与常见的神经网络世界模型不同,AWM 不满足于预测下一帧“看起来像什么”,而是试图回答三个更难的问题:世界里有哪些东西、行动如何改变它们,以及为什么某个目标可以或不可以实现。
它不是在生成世界,而是在给世界写定律
当前主流世界模型大多把“理解世界”转化为“预测未来观测”。 视频世界模型预测下一帧或未来视频,机器人世界模型预测动作执行后的视觉和状态变化,自动驾驶模型则预测其他交通参与者的轨迹;这些路线的共同点,是用高维神经网络吸收环境规律,再通过预测结果间接表现理解能力。
AWM 的差异在于,它要求规律必须被明确写出来。 在一个未知游戏中,系统不能只凭隐状态判断“点这里大概会开门”,而要形成类似“当红色按钮处于激活状态时,点击右侧机关会将门的状态从关闭变为开启”的规则,并持续用新观测检查这条规则是否成立。(arxiv.org)
这种区别可以类比为:视频世界模型像一个看过大量实验录像、能够猜出下一秒画面的学生;AWM 则更像一个需要写实验报告的学生,不仅要预测结果,还要列出对象、条件、定律和推导过程。
| 路线 | 核心表示 | 主要输出 | 优势 | 主要问题 | |---|---|---|---|---| | 视频生成式世界模型 | 像素或潜空间表示 | 未来画面、视频序列 | 能处理复杂视觉分布,适合仿真与内容生成 | 生成合理不等于掌握因果规律,难以证明结论 | | 预测式机器人世界模型 | 状态、动作与未来观测 | 动作后果、轨迹、奖励 | 适合控制和规划,可与强化学习结合 | 内部规律通常隐含在参数中,可解释性有限 | | 程序化世界模型 | 可执行代码或模拟器 | 状态转换、搜索结果 | 可运行、可调试,容易用于规划 | 代码正确不代表模型完整,可能漏掉关键规则 | | AWM 代数世界模型 | 类型化对象、共享规则、目标谓词 | 预测、可达性证明、不可能性证明 | 规则可检查,结论可由 Lean 内核验证 | 依赖离散规则和高质量探索,尚未验证复杂真实物理环境 |
三步走:探索、抽象、证明
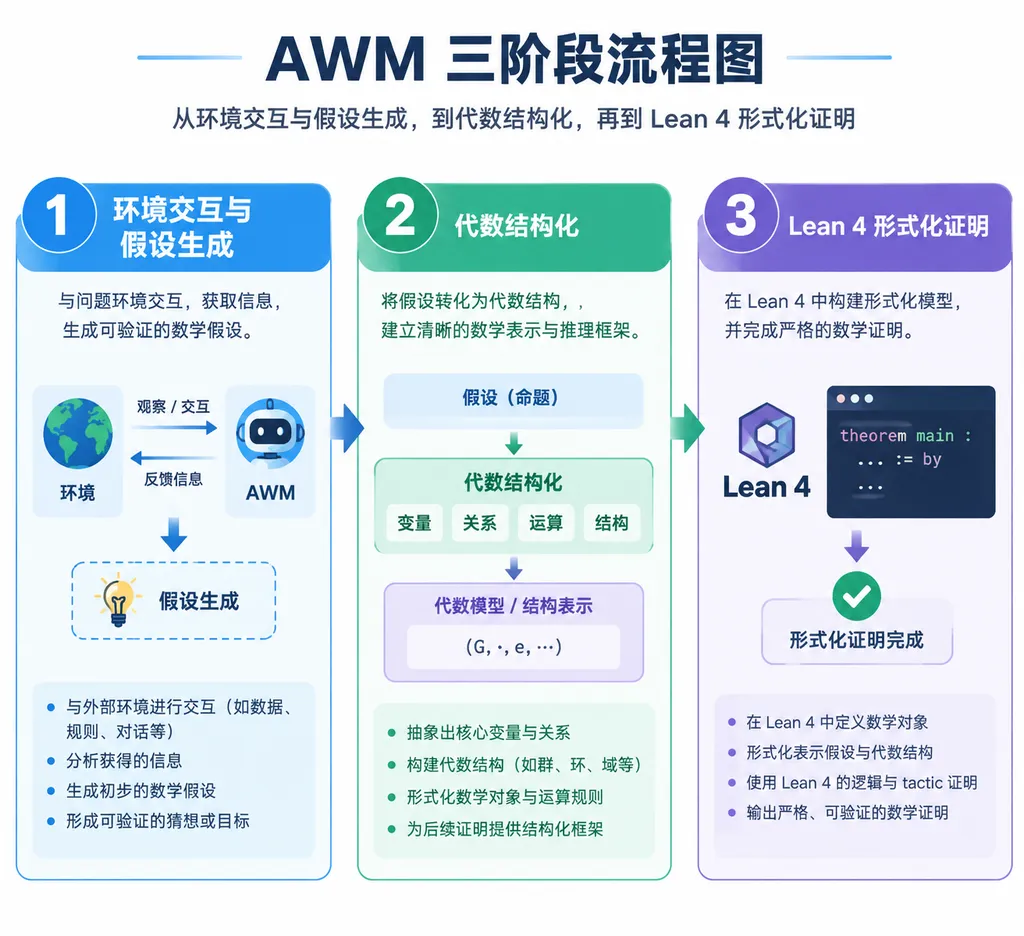
AWM 的工作流程由“探索与原型、结构化与简化、形式化与证明”三个阶段组成。 这不是一个单独训练出来的基础模型,而是一套让大模型调用工具、编写假设、验证假设并完成形式化推理的系统框架。(arxiv.org)
第一步:把猜测变成可执行假设
探索与原型阶段的目标,是让 AI 像做实验一样主动试错。 系统观察环境、执行动作,再记录动作前后的变化;每当发现一种可能的机制,就生成一条 Python 形式的可执行假设,放入团队称为“概念簿”的结构中。
每条概念不只是自然语言描述,还包含适用范围、支持它的观测、检查器以及可选的预测器。检查器会对历史交互返回三种结果:符合假设、违反假设,或者当前样本不适用。
AWM 不允许被观测推翻的规则悄悄留在模型里。 每完成一批动作,系统都要用全部已记录的状态转换重新检查概念簿;只要存在冲突、异常或超时,相关概念就必须修改或撤回,系统才能继续探索。论文报告,25 个游戏中共记录了 742 个可执行概念,其中 143 个在修订过程中被撤回。(arxiv.org)
这一步解决的是大模型智能体常见的“口头修正、内部不改”问题。普通 Agent 可能承认一次预测错误,但后续仍沿用原来的错误前提;AWM 则把假设变成测试程序,让错误产生明确的失败信号。
第二步:用范畴论压缩零散规则
结构化与简化阶段的目标,是把大量局部经验压缩为少数共享规律。 如果 AI 分别发现四种按钮都能触发颜色置换,最笨的方法是保留四条独立规则;AWM 更希望抽象出一条带参数的“置换规则”,再用不同参数描述四个按钮。
团队在这里引入了范畴论。范畴论是一套研究数学对象及其结构关系的抽象语言。 AWM 使用投射极限与归纳极限所提供的结构视角,对对象和规则执行分解、组合、泛化与特化,并用 Lean 检查这些变换是否保留了所需关系。(arxiv.org)
范畴论在这里并不是给系统套上一层高深术语,而是承担“模型重构工具”的角色。它帮助系统判断哪些概念可以组合,哪些局部机制其实是同一条规律的不同实例,以及哪些差异不能在压缩模型时被抹掉。
论文数据显示,经过结构化处理后,AWM 在 25 个游戏中得到 170 种对象类型和 283 条规则,单个游戏的中位数只有 6 种对象类型和 10 条规则。这个规模至少说明,在 ARC-AGI-3 的离散环境里,系统没有简单地把每一帧和每一个动作背下来。(arxiv.org)
第三步:让 Lean 判断结论是否真的成立
形式化与证明阶段的目标,是把“AI 觉得正确”升级为“证明检查器接受”。 系统将对象、动作、成本和目标条件写入 Lean 4,再证明某条动作序列能够到达目标,或者在给定预算内不存在任何获胜序列。
Lean 4 是一种编程语言和交互式定理证明器,其内核会检查证明的每一个形式化步骤。这里的重点不是 Lean 会不会替 AI 发现规律,而是它不会因为语言模型语气自信、搜索程序写得漂亮,就放过一个逻辑上不成立的结论。
可达性和不可达性的难度并不对称。 找到一条成功路线,只能说明“至少存在一种走法”;证明任务不可能完成,则必须排除所有合法动作序列,包括系统从未实际尝试过的序列。
这正是 AWM 最有价值的部分:它不只会说“我试了很多次都没成功”,而是尝试给出“根据当前模型,在预算 B 不超过 18 时,任意合法动作序列都不能获胜”的机器可检查证明。
在 ARC-AGI-3 上,AWM 做到了什么
ARC-AGI-3 是一套不给规则、不给目标说明的交互式游戏基准。 智能体必须从零开始操作环境,推断按键含义、对象关系和获胜条件;其评分同时考虑完成关卡数量和相对于人类基线的动作效率。(github.com)
论文在全部 25 个公开游戏、183 个关卡上测试了 AWM。使用 Claude Opus 5 作为底层模型时,系统完成全部关卡,得到 99.9 分;Lean 成功回放并验证了 183 条获胜轨迹,形式化了 220 条规则和 1374 个定理。(arxiv.org)
| 系统 | 是否执行代码 | 平均分 | 满分游戏数 | 已认证动作数 | 动作数/人类基线 | |---|---:|---:|---:|---:|---:| | Claude Opus 5 标准模式 | 否 | 40.7 | 5 | — | — | | GPT-6 Astra 标准模式 | 否 | 68.3 | 10 | — | — | | GPT-6 Astra Adapter | 是 | 100.0 | 25 | — | — | | Rodionov Agent | 是 | 99.0 | 23 | 8347 | 0.49 | | Memento 3 | 是 | 100.0 | 25 | 7518 | 0.44 | | AWM | 是 | 99.9 | 23 | 7448 | 0.43 |
AWM 的成绩不是绝对最高,但认证轨迹的动作效率最好。 它的 7448 个认证动作只相当于人类基线 17135 个动作的 43%,略少于 Memento 3 的 7518 次和 Rodionov Agent 的 8347 次。需要注意的是,如果把探索、失败尝试和其他会话全部算上,AWM 实际调用游戏引擎 24604 次,因此 43% 不能理解为系统的总探索成本低于人类。(arxiv.org)
AWM 的泛化测试比最终分数更能说明这套方法的定位。 在两个经过修改的 lp85 布局集合上,冻结后的规则正确预测了全部 4160 次状态变化;在两个改变底层机制的 ft09 集合上,它拒绝了全部 4031 次不符合原规律的转换。
在第三个游戏 ls20 中,最终结构化规则对未见画面的有效转换接受率达到 99.47% 至 99.95%,而结构化之前的概念只有 67% 至 70%。这组结果说明,代数化过程至少在实验环境中不只是压缩文本,而是提高了规则对新状态的覆盖能力。(arxiv.org)
真正拉开差距的是“不可能性证明”
研究团队专门构造了两个只差一步就能通关的“不可能关卡”。 两个关卡的最低获胜成本分别为 19 和 36,但系统预算被设置为 18 和 35;换句话说,它们不是通常意义上的难,而是在预算约束下严格无解。(arxiv.org)
团队分别让 AWM、Claude Opus 5.5 和 GPT-6 Astra 进行 6 次实验。基础模型同样获得了编程、模拟器构建和搜索工具,因此比较的重点不是谁能不能写搜索代码,而是谁能把结论变成严格证明。
| 系统 | Lean 内核验证证明 | 判断为不可能的运行 | 初始正确边界 | 反馈后正确边界 | 首次判断平均轮次 | |---|---:|---:|---:|---:|---:| | Claude Opus 5.5 | 0/6 | 3/6 | 1/6 | 1/6 | 5.3 | | GPT-6 Astra | 0/6 | 2/6 | 0/6 | 2/6 | 8.0 | | AWM | 6/6 | 6/6 | 4/6 | 6/6 | 2.0 |
AWM 在 6 次运行中全部生成了通过 Lean 内核检查的模型内证明,而两个基础模型的 12 次运行没有生成一份同类证明。 GPT-6 Astra 曾找到成本为 22 的路线,并在没有证明的情况下把 22 当作最低成本;但真实最低成本是 19,这意味着它错误排除了预算为 19、20、21 时存在解的可能。(arxiv.org)
形式证明并不自动保证世界模型就是现实。 AWM 的 6 个初始成本边界中只有 4 个与游戏引擎一致,另外两个错误结果来自过度严格的规则:证明在错误模型内部依然有效,但这个模型漏掉了游戏允许的某些转换。
研究团队随后只告诉系统“存在更便宜的获胜方式”,没有提供路线和成本。AWM 重新审查显式规则、补充交互并生成新证明,最终将正确边界从 4/6 提高到 6/6;进一步对游戏引擎进行检查后,6 份模型内证明中有 5 份能够扩展到原始游戏。(arxiv.org)
这个细节非常重要。AWM 证明的首先是“命题在所学模型中成立”,而不是“命题必然在真实世界中成立”。 形式化证明解决的是推理过程的可靠性,环境探索解决的是模型前提的可靠性,两者缺一不可。
它离“像牛顿一样思考”还有多远
AWM 展示的是一种科学推理框架,而不是已经掌握现实物理规律的 AI。 论文实验集中在确定性、目标导向、状态相对离散的游戏环境中;真实世界则包含连续动力学、噪声、传感器误差、隐藏变量、随机事件和不可重复实验。
牛顿研究的行星不会因为观测者没点击正确按钮就停止运行,但 ARC-AGI-3 的环境由明确代码驱动。游戏规则可以被完整执行、重复测试和穷举验证,而现实中的机器人通常拿不到“物理引擎真值”,更无法遍历所有状态。
AWM 的下一道门槛是从离散规则扩展到近似规律。 现实世界里的定律往往不是“点击后颜色必然交换”,而是带有误差项、概率分布和适用边界的关系,例如摩擦系数会变化,物体材质无法完全观测,机械臂关节也存在控制误差。
AWM 的第二道门槛是实验成本。 当前系统可以在游戏中执行 24604 次引擎动作,但真实机器人不能为了验证一个假设连续摔杯子、撞墙或尝试危险路径。要进入物理 AI,系统必须学会判断哪些实验信息量最大,并在安全约束内进行主动探索。
AWM 的第三道门槛是对象发现。 游戏中的像素虽然没有标签,但对象边界和状态变化仍比现实视频规整;现实环境中的“对象”可能被遮挡、变形,甚至取决于任务定义。同一团面粉对搬运任务是一个整体,对烹饪任务却包含湿度、颗粒和流变性质等多个变量。
因此,把 AWM 直接称为“AI 发现物理定律”还为时过早。更准确的说法是:它证明了大模型可以在一个陌生但可交互的环境里,把经验整理为显式结构,并对结构中的结论承担可检查的逻辑责任。
这条路线为什么值得关注
AWM 的现实意义,不在于把范畴论变成新的行业热词,而在于重新分配智能体系统中的信任。 大模型负责观察、提出假设和寻找证明;可执行测试负责发现规则与数据的冲突;Lean 负责检查推导是否成立;环境交互则继续审计形式模型的前提。
这比让一个模型同时担任“观察者、理论提出者、裁判和证明检查员”更可靠。它也给出了一个可操作的工程方向:未来的高可靠 Agent 不一定需要让神经网络本身完全可解释,但必须把关键任务转化为可审计的状态、规则、约束和证书。
短期内,AWM 更适合规则清晰但组合空间巨大的领域。 软件系统验证、自动化流程、形式化规划、芯片设计、数学游戏和部分工业控制问题,都比开放世界机器人更容易被写成明确对象与转换规则。
长期来看,AWM 真正有野心的地方是把世界模型从“预测机器”变成“理论机器”。 一个系统不仅要给出下一步,还要说明自己认为世界如何运作、结论依赖哪些前提,以及什么新观测会推翻当前理论。
这不是完整的“AI 牛顿”,但它确实比生成一段符合直觉的视频更接近科学方法:观察、假设、实验、抽象、证明,再回到观察。
参考来源
- ARC-AGI 官方工具库:ARC-AGI-3 交互环境的官方开源工具与接口说明。
- ARC-AGI-3 评分方法:解释相对人类动作效率、关卡完成度与评分规则。
- Lean 4 官方代码仓库:AWM 用于形式化建模和机器检查证明的定理证明器。
- 物理 AI 与世界模型路线讨论:介绍世界模型、VLA 与物理智能融合的行业背景。