网页数据微调为何会翻车
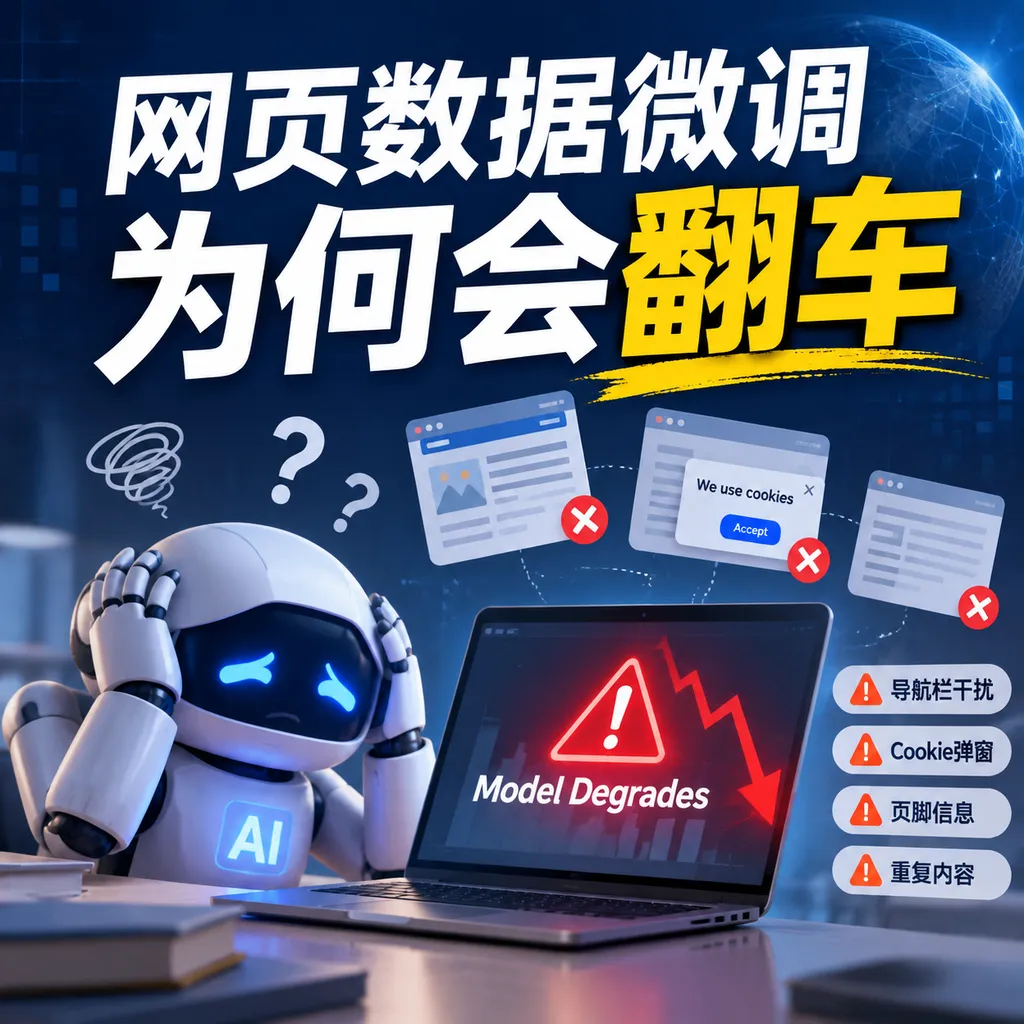
一场微调事故暴露了网页训练数据的真正风险:导航栏、Cookie 提示和页脚会被模型当成知识学习,而去重顺序与跨语言近重复还会进一步放大污染。
11 月 2 日,一名开发者在 Reddit 复盘了用自采网页数据微调模型的失败经历:导航菜单、Cookie 弹窗、页脚和残缺页面混进训练集后,模型开始生成类似“渲染到一半的 HTML”,而调整精确去重与模糊去重的先后顺序,又明显改变了模型复述训练语句的倾向。(reddit.com)
这不是一次罕见的爬虫故障,而是网页数据微调中最容易被低估的数据工程问题:模型不会区分正文与网页模板,它只会学习训练集中反复出现的模式。
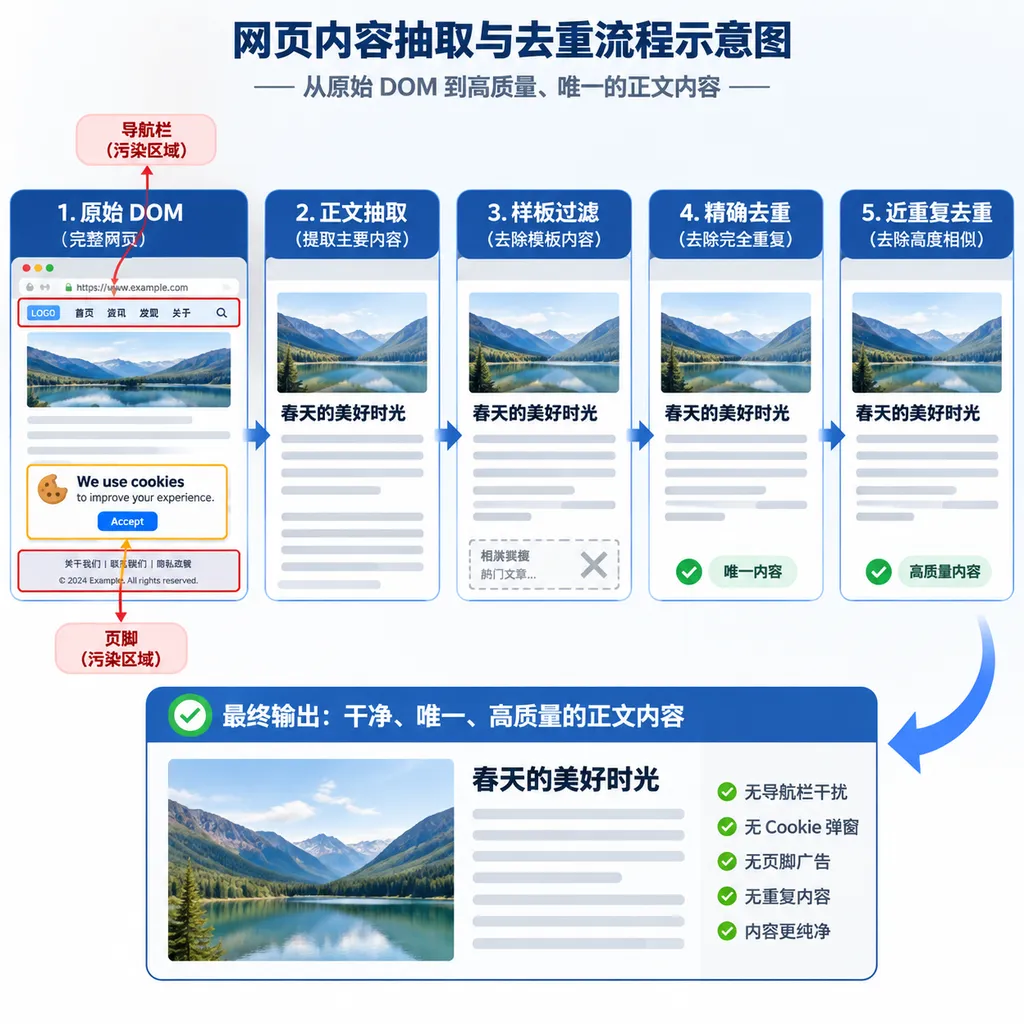
样板噪声是指导航栏、页脚、登录提示、相关推荐、Cookie 声明等跨页面重复出现、但不属于页面核心内容的文本。 它们在人眼看来只是无关信息,在梯度更新里却和正常答案拥有同等地位;出现次数足够多时,甚至拥有更高权重。
真正污染模型的不是乱码,而是重复
样板噪声最危险的地方,是它通常语法正确、编码正常,也不会触发传统的数据质量检查。 一句“接受全部 Cookie”没有乱码,一段“首页|产品|价格|联系我们”也能正常分词,因此只检查空值、长度和特殊字符,几乎一定会漏掉它们。
网页抓取管线如果直接读取 body 的可见文本,往往会把页面上所有区域压成一段字符串。正文可能只有 800 字,但导航、推荐列表、版权声明和隐私提示加起来有 300 字;单看一页,噪声比例似乎还能接受,但同一站点抓取 10 万页后,完全相同的 300 字会重复出现 10 万次。
模型学习的是频率加权后的分布,而不是编辑眼中的内容价值。 当站点模板在每个样本中重复,模型接收到的信号不是“这些文字无关紧要”,而是“这些短语极其常见,应该优先预测”。
这种污染在监督微调中尤其明显。如果噪声位于输入侧,模型会浪费上下文窗口,并可能错误地把导航词当作任务条件;如果噪声进入输出侧,模型则会直接学习错误的回答格式,开始在回答结尾补版权信息、输出按钮文案,甚至生成残缺标签。
| 污染类型 | 常见内容 | 模型侧表现 | 普通长度过滤是否有效 | |---|---|---|---| | 导航样板 | 首页、产品、登录、下一页 | 回答开头出现菜单式短语 | 基本无效 | | Cookie 与隐私提示 | 接受、拒绝、管理偏好 | 输出中插入无关免责声明 | 基本无效 | | 页脚样板 | 版权、备案、联系方式 | 回答结尾格式高度固定 | 基本无效 | | 推荐与聚合区 | 热门文章、猜你喜欢 | 主体答案后继续生成标题列表 | 部分有效 | | 反爬残页 | JavaScript 提示、访问验证 | 模型生成空壳页面或错误提示 | 长度过滤可能有效 | | 表格与代码抽取错误 | 列顺序错乱、换行消失 | 参数关系和代码结构被破坏 | 无效 |
抓到“完整页面”不等于抓到“正确内容”
采集层的目标应该是获得可复现的页面状态,而不是单纯获得更多 HTML。 Reddit 发帖者提到,改变访问网络和请求特征后,目标站点返回的页面结构更接近真实浏览器,因此原始 HTML 质量有所改善;但这只能解决“服务端给了什么”,无法解决“训练时应该保留什么”。(reddit.com)
网页可能因为地区、语言、登录状态、Cookie、设备类型、A/B 实验和 JavaScript 执行结果而产生不同 DOM。频繁改变出口地址有时能绕开面向自动化请求返回的简化页面,但它也会引入新的不一致:同一 URL 可能一会儿返回中文,一会儿返回英文,一会儿带弹窗,一会儿不带弹窗。
更可靠的做法是固定浏览器配置并记录采集证据。 每条原始记录至少应保留 URL、抓取时间、HTTP 状态码、最终跳转地址、页面语言、HTML 哈希、正文抽取器版本和渲染方式;高价值数据还应抽样保存截图或 DOM 快照。
没有这些字段,后续发现模型总爱输出“请启用 JavaScript”时,你很难判断污染来自哪个域名、哪次采集或哪个解析版本。只保存清洗后的纯文本,会让数据问题失去可追溯性。
DOM 定向抽取比全文提取更重要
DOM 定向抽取是按照页面结构选择正文节点,而不是把整个页面转换成纯文本。 对文章站点,它通常意味着优先识别 article、main、标题、正文段落和代码块,并排除 nav、footer、aside、弹窗与推荐列表。
这一步不能只靠一组全局 CSS 选择器。不同站点的模板差异很大,同一站点也可能同时存在文章页、列表页、产品页和搜索页;一条规则覆盖所有页面,最终通常会在召回率与精确率之间两头失守。
Llama 3 的公开技术报告提供了一个更接近工业实践的参照:其网页数据管线使用定制解析器平衡样板移除精度与正文召回,并在 URL、文档和行三个层级执行去重。报告还提到,行级去重会删除导航菜单和 Cookie 提示,但也可能误删高频的优质文本,因此必须通过模型实验验证,而不能只看清洗后剩余多少字符。(huggingface.co)
正文抽取的核心不是尽可能多地保留文本,而是保留语义结构。 代码块的缩进、表格的行列关系、数学公式和标题层级一旦被压平,即使没有任何导航栏,得到的也可能仍是低质量训练数据。
为什么去重顺序会改变最终模型
精确去重是删除规范化后完全相同的样本,模糊去重则是识别局部修改、不同模板或轻微改写后的近重复内容。 常见的精确去重使用内容哈希,文档级近重复则常用 n-gram、Jaccard 相似度和 MinHash。
去重并不是一个可以任意交换顺序的集合运算,因为模糊去重通常需要聚类,并从每个重复簇中选择一个代表样本。如果先做模糊去重,大量完全相同的副本可能影响桶分布、候选对数量、簇大小和代表样本选择;如果先做精确去重,则可以先移除零信息副本,再让模糊算法处理真正存在差异的文本。
对大多数网页微调数据,先规范化、再精确去重、最后模糊去重,是更容易审计的默认顺序。 但在文档级近重复之前,还应先处理明显的站点样板,否则两个正文完全不同、但导航和页脚相同的页面,可能被错误判定为近重复。
| 阶段 | 处理对象 | 推荐方法 | 主要风险 | |---|---|---|---| | 结构清洗 | 导航、页脚、弹窗 | DOM 节点过滤、站点模板规则 | 误删正文侧栏或代码块 | | 文本规范化 | 空白、编码、URL 形式 | Unicode 规范化、空白折叠 | 过度规范化改变代码含义 | | 精确去重 | 完全相同文档 | SHA-256 等内容哈希 | 未处理轻微改写 | | 高频行过滤 | 跨页面重复句子 | 行频率统计、域名内统计 | 误删法律条款或公共知识 | | 文档近重复 | 局部改写、模板变体 | MinHash、n-gram 相似度 | 短文本误判率较高 | | 语义去重 | 跨语言翻译、深度改写 | 多语言嵌入与向量检索 | 成本高,可能抹掉表达多样性 | | 数据集切分 | 训练集与评测集 | 按重复簇整体切分 | 切分过早造成数据泄漏 |
Google Research 的去重研究给出了更明确的数字:部分语言模型数据集中,一条 61 个单词的句子重复超过 6 万次;未经提示的模型输出中,超过 1% 的内容会逐字复制训练数据。去重后,模型生成记忆文本的频率可降低约 10 倍,同时标准数据集超过 4% 的验证样本存在训练—验证重叠问题。(huggingface.co)
这些结果说明,重复数据不只是浪费训练算力。它会改变模型的记忆行为、虚高评测结果,并让少数高频页面模板获得不成比例的梯度权重。
推荐的清洗修复顺序
一条可落地的修复管线,应该把原始数据、解析结果和训练样本分成三个不可覆盖的版本。 不要直接在唯一一份 JSONL 上反复清洗,否则一旦规则误删,你无法回滚,也无法比较不同清洗策略。
- 冻结原始层。 保存原始 HTML、URL、时间、响应信息和采集配置,所有清洗任务只读取原始层。
- 识别页面类型。 先区分文章页、列表页、产品页、论坛页与文档页,再调用对应抽取规则。
- 执行 DOM 定向抽取。 保留正文、标题、代码、表格和必要的元数据,排除导航、页脚、弹窗与推荐模块。
- 进行文本规范化。 修复编码问题,统一换行和连续空白,但不要破坏代码缩进、Markdown 表格或数学表达式。
- 先做精确去重。 对规范化后的正文计算哈希,并保留来源最清晰、结构最完整或时间最新的版本。
- 统计高频行与短语。 分别在单域名和全局范围计算重复频率,优先移除跨大量页面出现的界面文案。
- 再做文档级近重复。 使用 MinHash 等方法建立重复簇,同时保存簇大小、成员和代表样本选择理由。
- 按重复簇切分数据集。 同一簇不能同时进入训练集和验证集,否则离线指标可能只是测出了记忆能力。
- 进行小规模对照训练。 保持模型、训练 token 数、随机种子和超参数一致,只改变数据版本。
- 回查模型输出。 搜索 HTML 标签、Cookie 词汇、页脚短语、导航词和训练原句,不能只看验证损失。
Hugging Face 的 DataTrove 已提供网页抽取、过滤、MinHash、句子级精确去重和精确子串检测等组件;FineWeb 的 18.5 万亿 token 数据也使用这一类分阶段管线完成清洗与去重。(huggingface.co)
多语言近重复是另一类问题
跨语言近重复是不同语言表达相同内容、但表面字符和 n-gram 几乎没有重合的样本。 中文原文与英文翻译在语义上可能完全一致,字符级 MinHash 却会把它们视为两篇毫无关系的文档。
这也是 Reddit 发帖者仍未解决的问题:MinHash 在单语言语料上表现稳定,但面对多语言数据时会持续出现边缘案例。(reddit.com)
FineWeb 2 的处理方式值得参考,但不能机械照搬。该数据集覆盖超过 1000 种语言,约 20TB、50 亿份文档和超过 3 万亿词;其管线先识别语言与书写系统,再按语言进行全局去重,而不是直接把所有语言混在同一 MinHash 空间里。项目还使用 1.45B 参数模型、约 300 亿 token 的训练规模,对多个过滤方案进行了消融实验。(huggingface.co)
是否删除跨语言重复,取决于微调目标,而不是去重算法能否找到它。 如果目标是训练翻译或多语言问答,保留平行文本可能很有价值;如果同一事实被机器翻译成几十种语言后重复灌入,则可能造成事实和写作风格的过度加权。
更稳妥的工程方案是先进行语言内去重,再用多语言嵌入检索跨语言候选对,最后将结果标记为重复簇,而不是立即删除。对于跨语言簇,至少要区分人工翻译、机器翻译、引用转载和独立创作。
用哪些指标判断数据是否已经够干净
清洗的停止条件应该由模型行为决定,而不是由数据通过了多少条规则决定。 清洗率达到 30% 不代表数据更好,剩余 token 更多也不代表信息更多。
可以从以下四组指标建立数据质量面板:
- 结构指标: 正文占页面可见文本的比例、链接文本密度、短行比例、重复行比例、HTML 标签残留率。
- 重复指标: 精确重复率、近重复簇数量、最大簇大小、前 1% 重复簇占总 token 的比例。
- 泄漏指标: 训练集与验证集的 n-gram 重合率、近重复文档比例、评测题完整命中数量。
- 模型指标: 任务准确率、验证损失、训练原文复述率、HTML 异常输出率和导航词触发率。
对中小规模监督微调,可以先设置一组保守的工程报警线:验证集近重复率超过 0.5% 时暂停训练;完全重复样本超过 5% 时检查采集和分页逻辑;模型输出中出现 Cookie、版权或导航短语的比例超过 0.1% 时回查来源页面。它们不是行业标准,而是便于启动审计的阈值,最终仍需根据任务和语料规模调整。
判断:别把解析问题交给模型消化
网页数据微调翻车的根因,通常不是模型能力不足,而是团队默认模型能够自动忽略无关文本。 基座模型在通用推理中或许能绕过少量噪声,但微调会主动强化数据中的局部规律;样板重复得越多,错误规律越稳定。
住宅网络、浏览器渲染和更复杂的采集方案可以改善原始页面完整度,却不能替代正文抽取、去重与质量评测。相反,如果采集环境不断变化、又没有保存页面状态,数据可能变得更难复现。
最值得投入的环节不是多抓 100 万页,而是先证明已有 10 万页没有系统性污染。 数据质量带来的提升未必会立刻反映在训练损失上,却会直接影响模型是否复述网页模板、是否泄漏训练文本,以及评测结果是否可信。
这场刚刚出现的开发者复盘,真正有价值的地方不是提供了一条万能清洗规则,而是再次说明:网页训练数据的最小单位不是“文本”,而是带有来源、结构、版本和重复关系的文档。只要把它压成一列纯文本,很多关键证据就已经丢了。
参考来源
- Reddit:网页抓取数据微调失败复盘:本文事件来源,讨论样板污染、去重顺序和多语言近重复问题。
- Hugging Face:FineWeb 数据集:提供大规模网页数据清洗、过滤和去重实践及数据规模说明。
- Hugging Face:FineWeb 2 数据集:介绍多语言识别、按语言全局去重和过滤消融实验。
- GitHub:DataTrove:包含网页抽取、过滤、MinHash、句子去重和统计组件。
- Hugging Face:Deduplicating Training Data Makes Language Models Better:研究重复数据对模型记忆、评测泄漏和训练效率的影响。
- GitHub:deduplicate-text-datasets:Google Research 发布的文本数据集去重实现。
- Hugging Face:The Llama 3 Herd of Models:包含网页文本抽取、URL/文档/行级去重与过滤策略说明。