高通AI Hub中国版落地
高通AI Hub正式面向中国开发者开放,带来230多个预优化模型、云端真实设备调优、示例应用和GenieX推理框架。它解决的不是模型短缺,而是端侧AI部署最耗时的工程适配问题。
高通把面向骁龙设备的AI开发工具链正式搬到了中国开发者面前。
11月3日,高通宣布AI Hub现已面向中国开发者开放,开发者可以直接使用超过230个预优化模型、Workbench云端设备工作台、参考应用以及GenieX端侧推理框架。更准确地说,这套服务已于10月21日通过亚马逊云科技中国(宁夏)区域向国内用户开放,11月3日则是高通进一步面向开发者市场公布完整产品组合。(ithome.com)
高通AI Hub是面向骁龙及高通平台的端侧AI模型优化、验证与部署平台。 它不负责再训练一个基础大模型,而是把PyTorch、ONNX等模型转换成更适合特定芯片、运行时和精度格式的部署产物,并帮助开发者在真实设备上验证延迟、内存占用和输出精度。
这次开放最有价值的地方,不是开发者又多了一个下载模型的网站,而是国内团队终于能更顺畅地完成从“模型能运行”到“模型能在量产设备上稳定运行”的最后一公里。
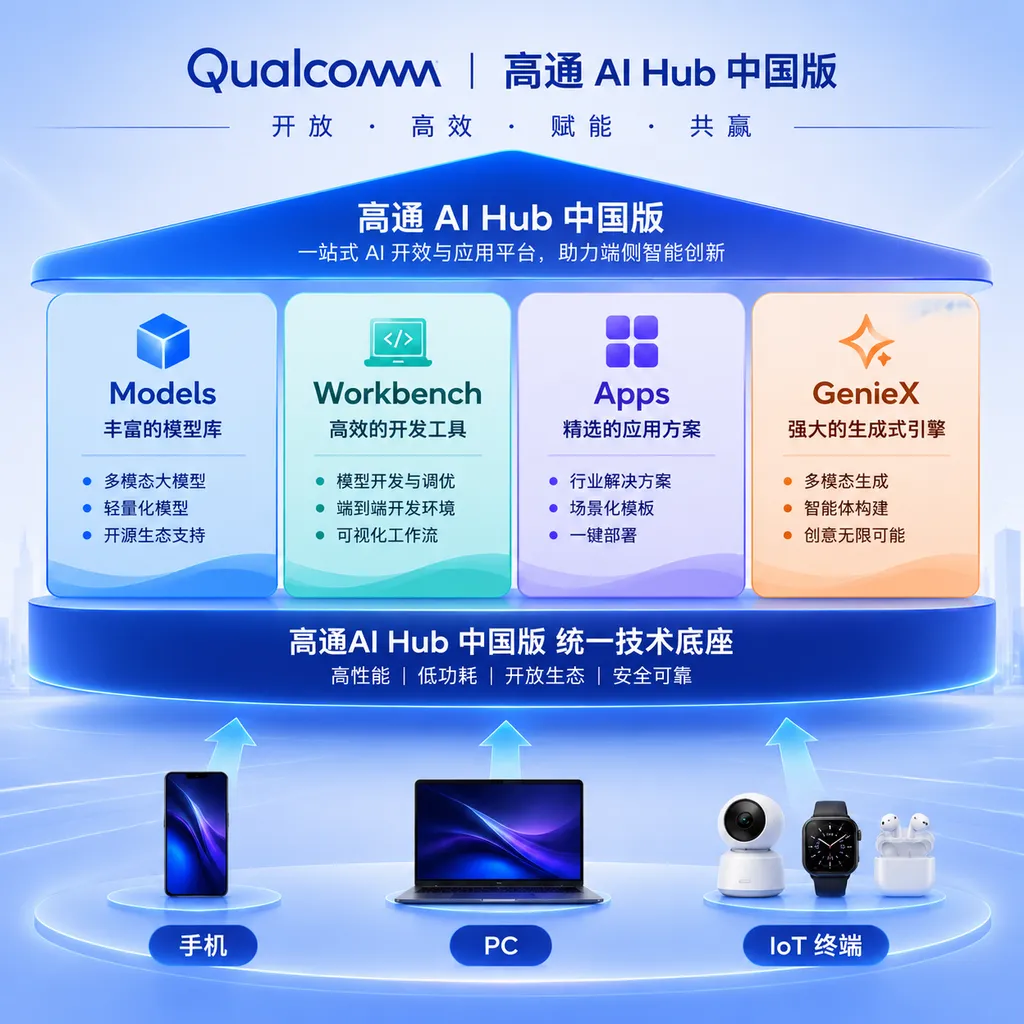
四块产品拼成一条端侧部署流水线
高通AI Hub Models是经过高通硬件适配和性能优化的模型目录。 中国版上线时提供超过230个模型,覆盖计算机视觉、语音处理、生成式AI、大语言模型和视觉语言模型等方向,并且仍在持续扩展。(ithome.com)
这个数字需要放在时间轴上看:高通在2024年MWC首次发布AI Hub时,宣布支持超过75个模型,并称经过优化后的推理速度最高可提升4倍;到2026年11月,模型数量已经超过230个,目录规模至少扩大到初期的3倍。这里的“三倍”指模型数量增长,而不是所有模型都能获得三倍性能提升。
预优化模型真正节省的是工程时间。端侧部署通常不是把模型文件复制进手机就能结束,开发者还要处理算子兼容、图切分、量化、精度回退、内存峰值、NPU调度以及不同SoC之间的差异。AI Hub Models相当于高通先做了一轮“针对芯片的精装修”,开发者拿到的是更接近可部署状态的模型,而不是只有研究价值的原始权重。
AI Hub Workbench是运行在云端真实设备上的模型编译、分析与验证环境。 所谓云真机,是开发者远程使用机房中的实体手机、开发板或PC,而不是只在模拟器中估算性能。
Workbench可以对模型执行量化、编译、性能分析和设备侧推理,并将设备输出与原始PyTorch结果进行比较。高通公开的AI Hub Models工作流显示,模型可以被转换为LiteRT、ONNX或Qualcomm AI Engine Direct等目标格式,再发送到托管的真实设备上测试延迟、数值一致性和运行结果。(github.com)
云真机解决了端侧AI开发中一个非常现实的问题:硬件碎片化。团队不可能为每位算法工程师采购十几款搭载不同骁龙平台的手机、PC和IoT设备,更不可能保证所有设备长期处于可复现的测试环境。把设备农场放到云端后,开发者可以先验证模型是否值得进入产品,再决定是否采购硬件做长期测试。
AI Hub Apps是可运行的参考应用与端到端部署范例。 它提供的不只是孤立的模型调用,而是输入预处理、推理、结果后处理和应用界面的完整路径。
高通当前公开的Apps项目覆盖Android、Windows 11和Ubuntu 24.04及以上环境,示例包括图像分类、目标检测、语义分割、超分辨率、语音转文字、Stable Diffusion、聊天应用和SAM分割等,并支持TensorFlow Lite、ONNX与Genie系运行时。对于开发者而言,这些示例的意义是回答“模型之外还需要写什么”,避免团队在摄像头数据、Tokenizer、图像预处理和结果解析上重复踩坑。(github.com)
GenieX是高通面向本地大语言模型和视觉语言模型推出的端侧推理框架。 它把模型下载、运行时选择、设备计算单元调度和应用接入封装到相对统一的工具链中。
GenieX目前包含两条主要运行路径:一条基于llama.cpp,可运行GGUF模型,并在Hexagon NPU、Adreno GPU或CPU之间选择计算单元;另一条基于Qualcomm AI Engine Direct,运行AI Hub预编译的芯片专用模型包,并以Hexagon NPU为主要目标。前者胜在模型覆盖广和迁移灵活,后者胜在针对具体骁龙平台做了更深的编译与量化优化。(github.com)
这两条路径的组合很务实。开发者可以先拿社区GGUF模型快速验证产品想法,再把确定要量产的模型切到针对目标芯片编译的NPU版本,而不必一开始就投入大量时间处理底层运行时。
AI Hub不是另一个模型社区
高通AI Hub与Hugging Face的核心区别,是前者强调“面向具体硬件的部署结果”,后者强调“模型与数据的开放分发”。 开发者在Hugging Face上通常拿到权重、模型卡和基础推理范例,但模型能否充分利用某款手机的NPU,仍取决于量化方式、算子支持和运行时适配。
AI Hub试图把这些部署问题产品化。开发者选择模型、运行时和目标设备后,平台负责完成相当一部分转换、编译和真机验证工作,并给出对应设备上的性能数据或可下载产物。这种模式更像“面向芯片的模型构建与测试平台”,而不是模型内容社区。
| 工具或平台 | 核心定位 | 硬件覆盖 | 真机测试 | 预优化模型 | 更适合谁 | |---|---|---|---|---|---| | 高通AI Hub | 骁龙端侧AI优化与部署平台 | 以骁龙和高通平台为核心 | 提供云托管实体设备 | 230多个 | 已确定使用高通平台、追求量产效率的团队 | | ExecuTorch | PyTorch原生端侧推理栈 | 手机、PC、可穿戴及嵌入式设备 | 主要由开发者自行准备 | 提供范例与导出工具 | 需要跨厂商部署、深度使用PyTorch的团队 | | ONNX Runtime GenAI | 跨平台生成式AI运行时 | CPU、GPU及包括QNN在内的多种执行后端 | 主要由开发者自行准备 | 依赖模型转换与生态资源 | 已采用ONNX或需要Windows、Linux、Android统一接口的团队 | | Hugging Face | 模型、数据集与应用分发社区 | 不绑定特定芯片 | 不以硬件验证为核心 | 模型数量最多但优化状态不统一 | 研究、选型和快速获取模型的开发者 |
ExecuTorch的优势是PyTorch原生与跨平台,高通AI Hub的优势是对骁龙硬件的垂直整合。 ExecuTorch可以将PyTorch模型导出为端侧程序,并通过不同后端在CPU、GPU、NPU或DSP上运行,但开发者仍需确认算子覆盖、后端兼容和目标设备性能。高通AI Hub则更像一条针对骁龙设备预先铺好的高速公路,路线更窄,但走起来更省事。(github.com)
ONNX Runtime GenAI的优势是通用性,高通AI Hub的优势是把模型编译、硬件适配和设备验证放进同一个平台。 ONNX Runtime GenAI已经覆盖Linux、Windows、macOS和Android,并支持CPU、CUDA、DirectML、OpenVINO和QNN等硬件加速路径;但对只想把模型塞进某款骁龙终端的团队而言,更通用也意味着需要自己完成更多设备侧验证工作。(github.com)
为什么国内开发者现在需要这套东西
端侧AI正在从单模型演示转向持续运行的生成式AI与智能体应用。 过去的手机AI任务通常是拍照增强、人脸检测或语音唤醒,模型规模较小,执行流程固定;现在的端侧智能体需要同时处理自然语言、多模态输入、工具选择、记忆管理和多轮推理,对内存、功耗与持续解码速度提出了更高要求。
本地运行的价值也不只是“断网还能用”。摄像头画面、语音、个人文件和应用状态可以留在设备上处理,减少原始数据上传;交互不需要每一步都等待网络往返,首个Token和工具调用延迟更稳定;对于高频调用场景,设备侧推理还能降低长期云计算成本。
但端侧AI也不是免费的午餐。一个模型在旗舰开发机上跑通,不代表它能在量产手机上满足温度、续航和内存要求;一次推理很快,也不代表持续运行十分钟后不会降频;模型成功量化到INT4,也不代表中文能力、视觉理解或工具调用准确率没有明显下降。
AI Hub最值得肯定的地方,是它没有把“端侧部署”简化成一张TOPS参数表。真实产品关心的是模型能否编译、占多少内存、首轮加载多久、持续推理是否稳定,以及精度损失是否可接受。Workbench的设备测试与Models的预优化产物,恰好针对这些工程指标。
中国版的关键不是汉化,而是本地可用性
高通AI Hub中国版的核心变化是服务基础设施、设备资源与开发者支持在国内落地。 公开信息显示,平台通过亚马逊云科技中国(宁夏)区域向中国用户提供服务,并配套高通终端云中国设备农场、中文官网和开发者论坛。(ithome.com)
这种落地会直接降低团队试用门槛。过去国内开发者即便知道AI Hub可以编译和测试模型,也可能因为账户体系、网络访问、设备区域和技术支持等问题而无法把它纳入正式工作流;中国版至少让注册、上传、编译、设备测试和问题反馈形成一条本地闭环。
高通此次没有公布中国版的完整计费细则、免费额度和不同设备的任务配额,因此现阶段还不能判断它对中小团队是否足够便宜。云真机和模型编译都涉及稀缺硬件与计算资源,如果排队时间、任务额度或商业价格缺乏竞争力,开发者仍可能只把它当作验证工具,而不是持续集成基础设施。
对开发者意味着什么
已经确定采用骁龙平台的团队,应该优先测试AI Hub,而不是从零搭建整套转换链。 尤其是手机、Windows on Snapdragon PC、XR、机器人和工业终端项目,预优化模型与真机性能数据可以显著缩短前期选型周期。
尚未确定芯片平台的团队,不应过早把部署流程绑定在AI Hub上。 高通提供的垂直优化越深入,迁移到其他芯片平台时需要重做的工作通常也越多;更稳妥的方式是保留标准PyTorch或ONNX模型,把AI Hub作为高通目标平台的构建后端。
需要部署自研模型的团队,应该重点关注算子兼容与精度验证,而不是只看模型库数量。 230多个预优化模型足以覆盖常见任务,但真正形成产品差异的模型往往经过微调、蒸馏或结构改造,能否顺利编译、是否支持动态形状、量化后精度下降多少,比目录里是否有同名基础模型更重要。
准备做端侧智能体的团队,可以把GenieX视为值得验证的运行时,但还不能把它当成完整智能体平台。 GenieX解决的是模型获取、加载和推理问题,而工具权限、任务规划、应用状态管理、长期记忆、安全隔离和失败恢复,仍然需要应用层自己完成。
判断:高通在争夺端侧AI的默认入口
高通AI Hub中国版是一项重要但不性感的基础设施更新。 它不会像新模型发布那样立刻制造跑分纪录,却可能影响未来两三年大量AI应用究竟能否真正进入手机、PC和IoT产品。
高通的算盘很清楚:芯片性能只是端侧AI竞争的一半,另一半是让开发者愿意并且能够把模型部署到芯片上。如果开发者习惯从AI Hub选模型、在Workbench测性能、用GenieX运行,再从Apps复制工程结构,那么高通获得的就不只是一笔芯片订单,而是端侧AI软件栈的入口位置。
这套方案目前最大的优势是链路完整,最大的限制也是平台绑定。对于明确押注骁龙的开发者,它能减少大量没有产品差异的底层工作;对于需要跨芯片、跨终端部署的团队,ExecuTorch或ONNX Runtime仍然更适合作为上层统一框架,再按目标硬件接入高通后端。
高通AI Hub真正需要证明的不是模型数量还能涨多少,而是国内开发者能否在合理的排队时间和成本下,把自研模型稳定地编译、测试并交付到量产设备。230多个模型只是起点,云真机的可用率、性能数据的可信度以及GenieX的版本稳定性,才决定它能不能从“官方工具集合”变成开发团队每天都用的基础设施。
参考来源
- IT之家:高通AI Hub现已面向中国开发者开放——11月3日产品开放消息及四大模块概览。
- 知乎:高通与亚马逊云科技推出高通AI Hub中国版——中国区域基础设施与合作背景介绍。
- GitHub:Qualcomm AI Hub Models——官方模型库、运行时、量化及云端真机工作流说明。
- GitHub:Qualcomm AI Hub Apps——Android、Windows和Ubuntu参考应用与教程。
- GitHub:Qualcomm GenieX——GenieX支持平台、模型格式与计算单元说明。
- GitHub:PyTorch ExecuTorch——PyTorch端侧部署方案及后端架构资料。
- GitHub:ONNX Runtime GenAI——ONNX生成式AI运行时及硬件支持矩阵。