Dreambeans押注印度多语故事
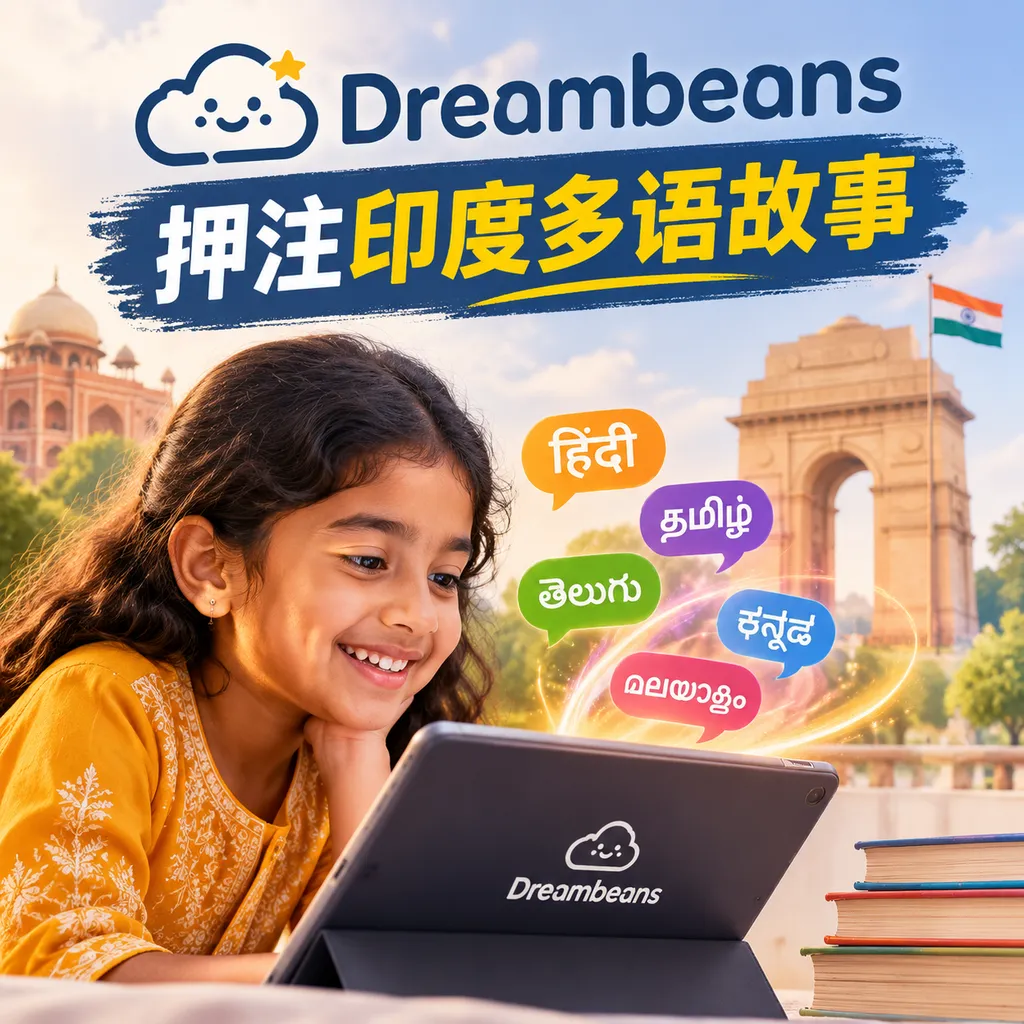
Google 将 AI 个人故事应用 Dreambeans 扩展至印度,新增 13 种本地语言。真正的看点不是故事生成,而是 Google 开始把用户跨应用数据包装成主动推送的个人 AI 内容。
Google把Dreambeans带到印度,AI开始替你讲述自己
Google 正在把 Dreambeans 从美国实验项目推向第一个海外市场。当地时间 11 月 3 日,Google Labs 宣布 Dreambeans 向印度 18 岁以上用户开放,覆盖 Android 和 iOS,并新增印地语、孟加拉语、泰卢固语、马拉地语、泰米尔语、乌尔都语等 13 种印度本地语言;算上英语,应用目前在印度支持 14 种语言。(blog.google)
**Dreambeans 是一款利用用户授权的 Google 账户数据,自动生成每日个性化图文故事的实验性 AI 应用。**它不是让用户输入一段提示词,再临时写一篇故事,而是连接 Calendar、Gemini、Gmail、Google Photos、Search 和 YouTube,整理用户近期的日程、兴趣、搜索行为、照片和内容消费记录,主动生成一组可能与用户有关的故事、建议和提醒。
这次进入印度,表面上是一轮语言本地化,实际测试的却是一个更重要的问题:当 AI 不再等待用户提问,而是主动阅读个人数字生活并组织成内容,用户会不会每天打开它?
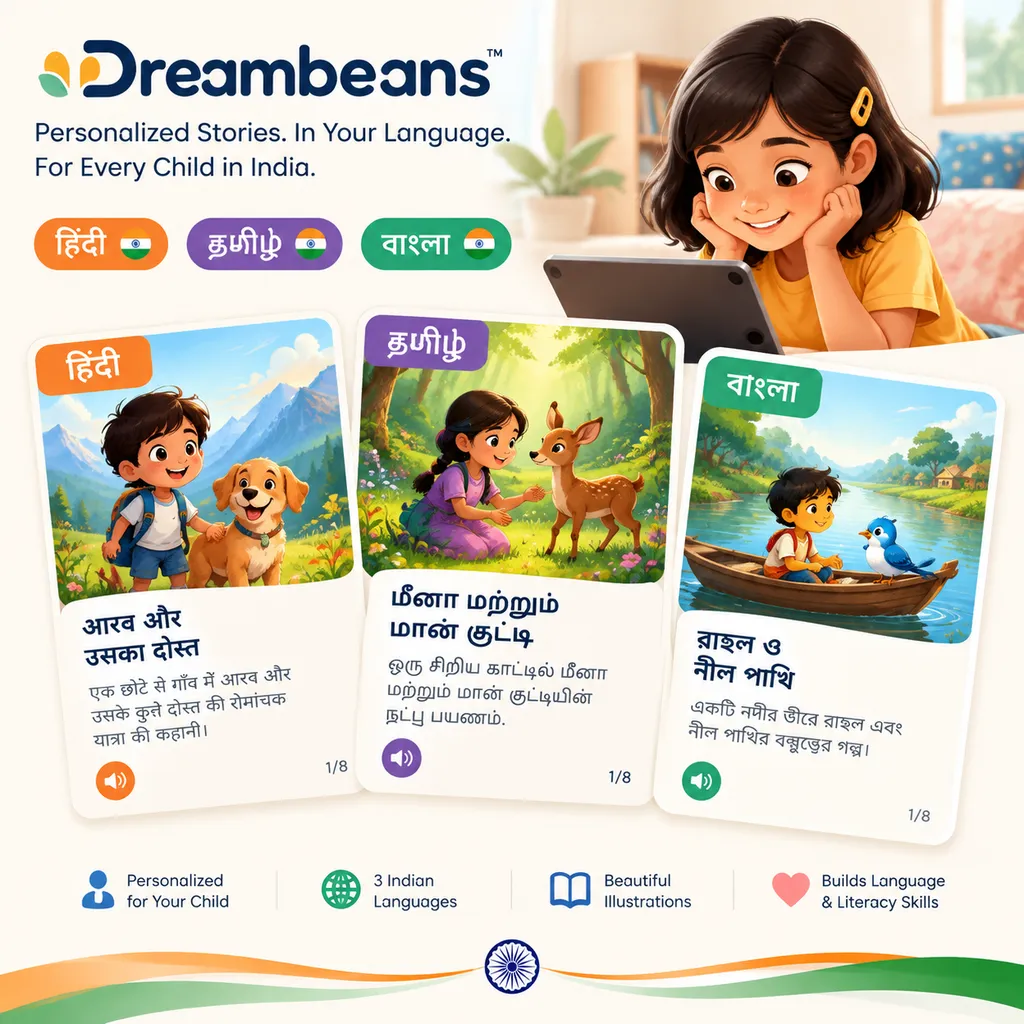
13种本地语言,不只是增加翻译选项
**Dreambeans 在印度新增支持 13 种本地语言,是 Google 第一次把这款个人故事产品扩展到美国以外。**支持的语言包括印地语、孟加拉语、泰卢固语、马拉地语、泰米尔语、乌尔都语、古吉拉特语、卡纳达语、马拉雅拉姆语、奥里亚语、旁遮普语、阿萨姆语和尼泊尔语,另有英语可选。(blog.google)
印度并不是一个只要支持英语和印地语就能覆盖的市场。不同邦的主流语言、文字系统和内容偏好差异明显,用户还经常在英语与本地语言之间切换。对一款依赖个人语境的产品来说,理解“用户看过什么”只是第一步,能否用用户习惯的语言重新讲出来,才决定故事是否像是写给本人。
Google 选择印度,也有非常现实的数据基础。Google 产品经理 Gozde Oznur 表示,印度用户对 Dreambeans 表现出较强兴趣,而且 Gemini、Gmail 和 Google Photos 在当地拥有较高的用户重合度。换句话说,Dreambeans 所需要的个人数据拼图,Google 在印度已经基本集齐。(techcrunch.com)
**印度对 Dreambeans 的价值,不只是人口规模,而是它同时具备多语言环境、移动端用户和密集的 Google 服务使用。**如果 Dreambeans 能在这里成立,Google 就有理由把同一套产品逻辑复制到更多语言复杂、移动互联网占主导的市场。
不过,目前的多语言支持仍有一个明显短板:用户每次只能选择一种故事语言。Dreambeans 可以读取多个 Google 服务里的不同语言信息,却不能在同一篇故事中自然混合多种语言。(techcrunch.com)
这对印度用户并不是小问题。大量用户日常使用 Hinglish,也就是印地语和英语混合表达;邮件可能用英语,家庭聊天、搜索词和视频内容却可能使用印地语或其他本地语言。Dreambeans 能理解这些信息,不等于它能用同样自然的混合语言把故事讲出来。
它不是聊天机器人,而是一条个人内容流
**Dreambeans 与 ChatGPT、Gemini App 或 Claude 最大的区别,是它不要求用户先提出问题。**传统聊天机器人通常遵循“用户输入—模型回答”的交互模式,而 Dreambeans 更像一份每天自动生成的个人杂志:系统在后台整理用户授权的数据,再把值得关注的内容包装成一组带插画的故事卡片。
这些故事可能是一次即将到来的旅行、一项被遗忘的兴趣、一个值得参加的本地活动,也可能是根据照片和搜索记录生成的家庭回忆。Google 最近还加入了基于 Veo 视频生成模型的动画能力,可以让部分故事中的静态图片动起来。(techcrunch.com)
这种设计降低了使用门槛,但也改变了用户对 AI 的评价标准。聊天机器人的价值可以用答案质量、推理能力和完成任务的速度衡量;Dreambeans 的核心指标则更接近推荐系统:它是否了解用户、每天推送的内容是否值得看,以及错误推荐会不会让人产生被冒犯或被窥视的感觉。
| 对比维度 | Dreambeans | 通用AI助手 | 传统内容推荐产品 | |---|---|---|---| | 核心输入 | 用户授权的跨应用个人数据 | 用户提示词、文件或对话 | 浏览、点击和停留行为 | | 主要输出 | 每日个性化图文故事 | 问答、写作、分析与任务执行 | 视频、文章或商品内容流 | | 交互方式 | 主动生成,用户低操作 | 用户主动发起请求 | 算法持续推荐 | | 个性化基础 | Gmail、日历、照片、搜索等个人语境 | 当前对话及记忆功能 | 平台内部行为数据 | | 主要优势 | 个人上下文完整,内容更具体 | 能力通用,可处理复杂任务 | 内容供给量大、反馈速度快 | | 主要风险 | 隐私、敏感记忆和错误推断 | 幻觉、错误执行和数据泄露 | 信息茧房、成瘾与广告干扰 |
**Dreambeans 的产品形态,本质上介于个人 AI 助手和算法内容流之间。**它不像助手那样明确执行任务,也不像短视频平台那样从公共内容池里挑选素材,而是把个人数据转化成新的生成式内容。
这个方向很有想象力,因为用户不需要学习提示词,也不必每次想清楚自己要问什么。但它也容易沦为“看两天觉得新鲜,之后不再打开”的演示型产品。生成故事并不难,持续生成有用、准确且不过度打扰的故事,才是真正的产品门槛。
下载量说明了一个不太乐观的现实
**Dreambeans 在美国市场的初期数据并不算强,这也是印度扩张最值得关注的背景。**Sensor Tower 向 TechCrunch 提供的估算显示,Dreambeans 自 6 月上线以来,在美国累计下载量接近 5.5 万次;其中约 63% 发生在 9 月,当时 Google 刚向符合条件的美国成年用户全面开放。(techcrunch.com)
热度没有持续太久。10 月,Dreambeans 的美国下载量环比下降 84%,降至约 5500 次。按这一数据推算,全面开放带来的增长更像一次集中释放,而不是稳定形成了每日使用需求。
| 产品 | 对符合条件用户开放后的前30天估算下载量 | 产品定位 | |---|---:|---| | Meta Muse | 740万 | 通用AI应用 | | ChatGPT | 280万 | 通用AI助手 | | Grok Bot | 36.2万 | 通用AI助手 | | Claude | 15.5万 | 通用AI助手 | | Dreambeans | 2.9万 | 个性化AI故事 |
以上数字来自 Sensor Tower 的跨产品估算,发布时间、覆盖地区和产品定位并不完全一致,不能直接等同于模型能力排名。(techcrunch.com) 但数量级的差距仍然说明,用户会主动寻找一个能回答问题、写文档或处理任务的通用 AI,未必会专门下载一款每天讲述个人生活的应用。
**Dreambeans 目前最大的问题不是生成质量,而是使用理由不够刚性。**日历提醒可以由 Calendar 完成,旅行建议可以在 Gemini 或搜索中获取,照片回忆已经存在于 Google Photos。Dreambeans 必须证明,把这些功能重新包装成故事之后,能够产生一个原有产品无法替代的新价值。
印度市场可能让 Google 找到答案。更多语言、更复杂的家庭关系和更密集的移动端使用,可能让个性化故事更有情感价值;但如果产品仍然只是把已有信息换一种视觉形式复述,那么新增 13 种语言只会扩大覆盖范围,不会自动提高留存率。
真正的护城河是Google账户,而不是故事模型
**Dreambeans 最难被竞争对手复制的部分,不是生成插画或故事,而是它能够合法、连续地读取 Google 生态中的个人上下文。**一个独立创业团队可以接入大模型,也可以生成质量不错的图片和文本,但很难同时拥有用户的邮件、日历、照片、搜索历史和视频兴趣。
这也是 Google 近两年反复强调 Personal Intelligence 的原因。个人 AI 的能力上限,不只取决于模型参数和推理跑分,还取决于模型是否知道用户下周要去哪里、最近在研究什么、家人是谁,以及哪些信息值得主动提醒。
Dreambeans 可以被视为 Google 对“个人智能层”的一次轻量试验。Google 没有一开始就让 AI 自动处理邮件、修改日程或代替用户完成高风险操作,而是先让它生成故事和建议。即使内容出现偏差,错误成本通常也低于自动发送邮件或购买商品。
**故事是一个风险较低的入口,也是训练用户授权更多个人数据的入口。**一旦用户接受 AI 跨应用读取个人语境,Google 就可以逐步把 Dreambeans 从内容产品扩展为行动产品,例如从旅行故事跳转到查看票务,从影视建议跳转到播放预告片,再进一步执行预订或安排日程。
Google 已表示正在探索让 Dreambeans 变得更加可执行,而不只是提供故事和建议。(techcrunch.com) 如果这一方向继续推进,Dreambeans 最终可能不再是一款独立故事应用,而会成为 Gemini 个人化能力的一种实验界面。
隐私控制存在,但不代表问题已经解决
**Dreambeans 的个性化程度与隐私压力来自同一个地方:它需要访问高度私密的 Google 账户数据。**邮件可能包含工作合同、医疗通知和金融信息,照片可能涉及家庭成员,日历则会暴露用户的位置、关系和未来计划。
Google 表示,用户可以自行选择连接哪些服务,也可以随时断开连接或在应用内删除 Dreambeans 数据。底层 Google 服务中已删除的信息,也会从 Dreambeans 的个性化系统中移除;生成的故事只对账户所有者可见,并且目前仅支持个人 Gmail 账户,不面向企业账户。(techcrunch.com)
这些控制是必要的,但不足以消除体验风险。Dreambeans 可能因为照片和邮件内容重新呈现已经离世的亲友,也可能把工作、健康或关系信息包装成用户不希望看到的故事。Google 允许用户要求系统减少特定主题,这与 Google Photos 中限制部分回忆出现的机制类似。
**个人 AI 最危险的错误往往不是事实答错,而是在错误的时间提起正确但敏感的信息。**一个模型把活动日期写错,用户可能只觉得产品不够聪明;一个模型突然生成关于已故亲友的动画故事,问题就不再是准确率,而是产品是否理解情境和边界。
Google需要证明,主动AI不是主动打扰
**Dreambeans 进入印度,是一次比新增语言更重要的主动式 AI 实验。**Google 已经拥有模型、移动操作系统和大规模消费级服务,现在它要验证的是:能否把分散在不同应用中的个人数据,整理成用户愿意每天阅读的内容。
这款产品的优势非常清楚。它不需要用户掌握提示词,能够使用跨应用上下文,生成内容也比普通推荐系统更私人、更具体。对于习惯使用 Gmail、Google Photos、YouTube 和 Gemini 的用户,Dreambeans 理论上可以比任何独立 AI 应用更了解其生活。
它的弱点同样明显。美国下载量在全面开放后迅速回落,说明新鲜感尚未转化为稳定需求;印度用户常见的混合语言表达暂时不受支持;跨应用读取数据带来的隐私和敏感内容风险,也会随着个性化程度同步上升。
**Dreambeans 是否成功,不取决于它能生成多少漂亮故事,而取决于它能否持续产生“我正好需要看到这个”的时刻。**如果 Google 做到了,它会成为个人 AI 从被动问答走向主动服务的重要样板;如果做不到,它就只是另一个展示 Google 数据和生成模型能力的 Labs 实验。
目前来看,印度扩张为 Dreambeans 带来了更大的测试场,却没有解决它最根本的产品问题。13 种本地语言能让更多人看懂故事,但只有真正理解用户何时需要故事、何时不希望被打扰,才能让这颗“Dreambean”不只是短暂发芽。
参考来源
- LINUX DO:谷歌推出 AI 应用 Dreambeans:整理 Dreambeans 首次发布时的功能、开放范围和社区讨论。
- Reddit:Dreambeans access:记录早期用户的访问资格、候补机制和实际体验反馈。
- Reddit:Trying to understand how Dreambeans gets recommendation working:用户讨论 Dreambeans 如何利用个人数据生成推荐,可作为体验层面的补充材料。