278M参数,PII脱敏开始瘦身
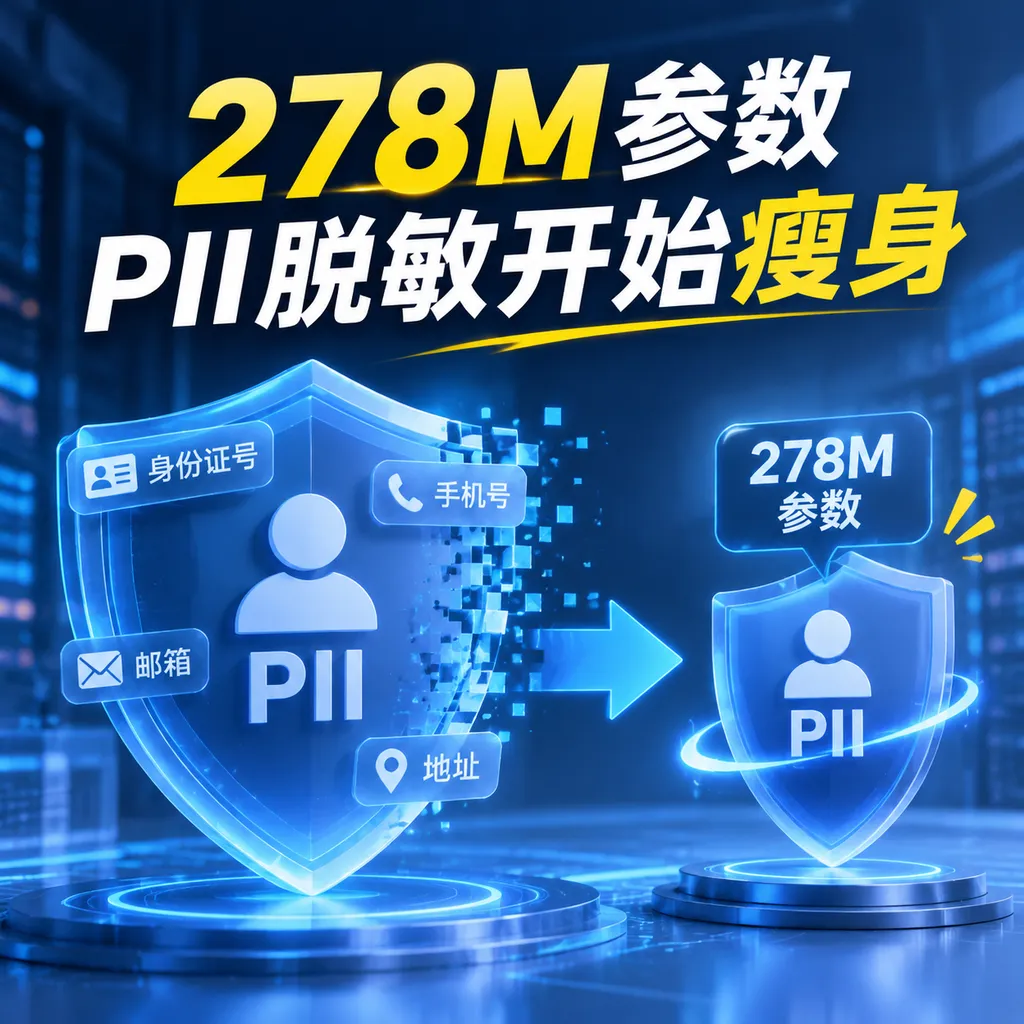
Protegrity 发布一款基于 RoBERTa 的 278M 开放权重 PII 检测模型,并同步推出 PII-SCOPE 基准。它把隐私识别推向本地轻量部署,但合成数据、跨语言能力与真实行业泛化仍需独立验证。
278M 参数模型瞄准隐私脱敏的“最后一公里”
Protegrity 近日发布了 Protegrity-PII,一款拥有 2.78 亿参数的个人身份信息检测模型,并同步开放配套基准 PII-SCOPE。截至 2026 年 11 月 3 日,模型权重和基准已经上线 Hugging Face,技术报告也已公开。
**PII 是能够单独或与其他信息结合后识别具体个人的数据。**姓名、电话号码、邮箱、证件号码属于直接标识符,IP 地址、设备 ID、精确位置、出生日期等则可能通过组合完成重新识别。
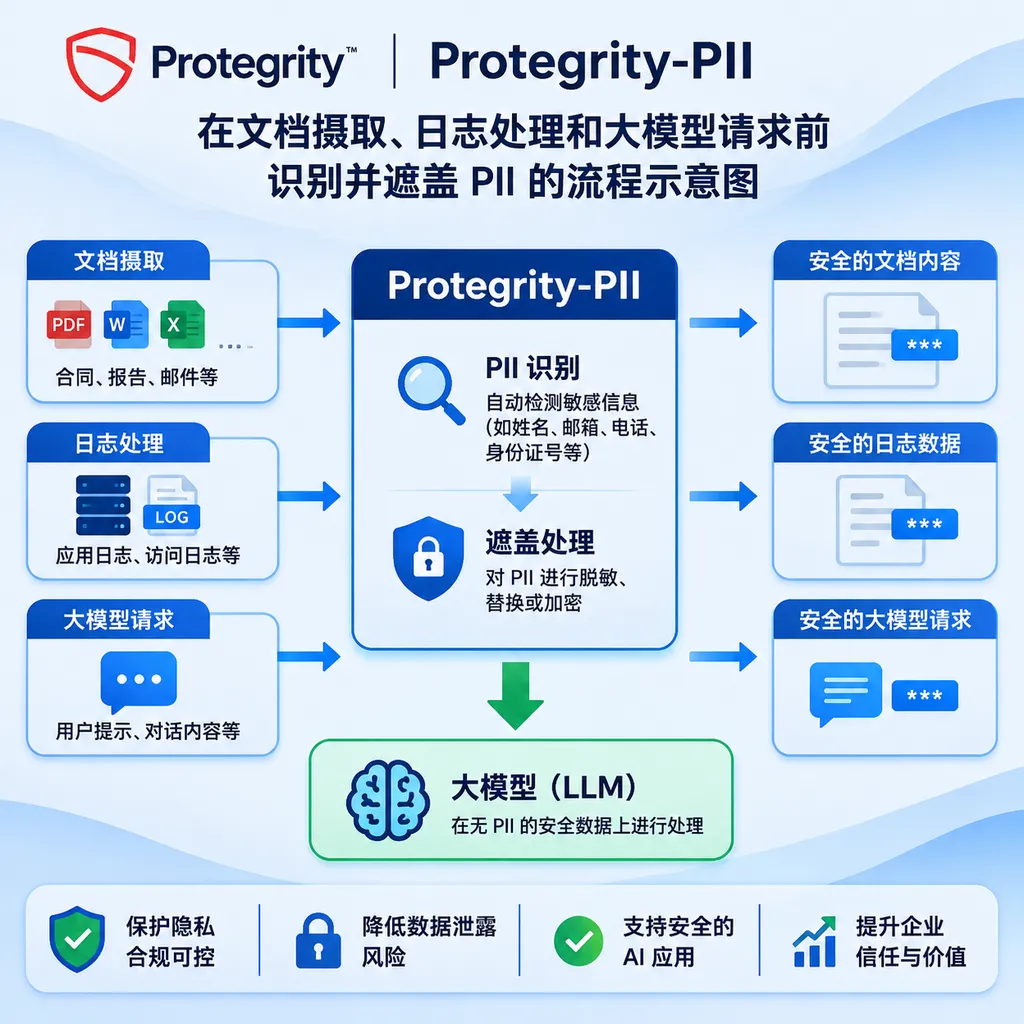
**PII 检测是从非结构化文本中定位个人身份信息,并返回其类别与字符位置的任务。**Protegrity-PII 不只是判断“一段话有没有隐私”,而是输出每个隐私片段的起止索引和类型,也可以直接生成完成遮盖的文本。
例如,一条客服记录里同时出现客户姓名、手机号、地址和订单号,模型需要区分哪些字符串属于 PII、各自是什么类型,以及它们在原文中的准确位置。后续系统才能将姓名替换为 [PERSON],把电话替换为 [PHONE],同时尽可能保留句子结构和业务语义。
这次发布真正值得关注的地方不是刷新了多少排行榜,而是把上下文感知的 PII 识别压缩到了 278M 参数。它比动辄数十亿参数的生成式模型更适合放在数据入口、日志管道、RAG 摄取链路和企业内部 AI 网关里,承担每次请求都要执行的基础安全工作。
它不是小型生成模型,而是上下文分类器
**Protegrity-PII 是基于 RoBERTa 微调的编码器模型,而不是用来生成文本的大语言模型。**RoBERTa 会同时读取一个词前后的上下文,再判断对应 token 是否属于姓名、地址、邮箱、电话号码或其他隐私类别。
这种架构比纯正则表达式更擅长处理“长得一样、含义不同”的字符串。比如 Jordan 既可能是人名,也可能是国家或品牌;一串数字可能是电话号码,也可能是订单号、日期或金额。正则只能判断格式,编码器则可以借助“联系”“患者”“账号”“寄送”等上下文词作出分类。
模型发布方称,其微调数据包含 12 亿条合成文本样本,覆盖多种 PII 表达和上下文。这个数字甚至比 278M 参数本身更值得讨论:PII 检测的主要瓶颈往往不是基础模型不够大,而是真实隐私数据不能随意收集、标注和公开,合成数据因而成为扩展训练规模的现实路径。
合成数据也带来了明显边界。模板生成的姓名、地址和证件号码通常更干净,拼写更规范,类别分布也更可控;真实客服聊天、医疗笔记和日志却包含错别字、缩写、OCR 噪声、字段拼接、半截号码以及大量行业黑话。模型在合成基准上表现优秀,并不等于它可以直接接管生产环境。
严格来说,这次发布首先是一次 **open-weights(开放权重)**发布,而不能仅凭权重可下载就把训练流程、数据生成器和完整数据谱系统称为完全开源。企业在采用前仍应核对模型卡中的许可证、使用限制、训练数据说明和适用语言,而不是把“可以下载”自动理解为“可以无条件商用”。
PII-SCOPE 想解决的是基准失真
**PII-SCOPE 是 Synthetic Context and Ontology for PII Extraction 的缩写,是一个面向 PII 抽取的合成上下文与类型体系基准。**它的目标是同时考察模型能不能找到隐私片段、能不能划准边界,以及能不能把片段分到正确类别。
传统 PII 数据集经常存在三类问题。第一类是模板痕迹过强,例如电话号码永远出现在“Phone:”后面;第二类是实体值重复,训练集和测试集可能共享相似姓名或地址;第三类是只看最终遮盖结果,没有严格考察 span 边界和类型。模型可能记住格式,却没有真正理解上下文。
PII-SCOPE 的价值在于把“上下文”和“本体类型”放到同一个评估框架中。对于生产系统,识别出一个疑似片段还不够:把普通产品编号错判成身份证号会破坏日志和检索结果,把地址漏掉一个门牌号则会留下真实泄露风险。
不过,新基准和新模型来自同一发布方,结果天然需要第三方复现。一个模型如果在与训练数据采用相近生成方法的测试集上占优,可能只是更熟悉那套合成分布。更有说服力的验证应包括不同生成器产生的数据、真实但完成合法匿名化的行业语料,以及医疗、金融、客服、代码日志等跨领域压力测试。
另一个需要注意的问题是名称冲突。2025 年 IJCNLP-AACL 已有一项名为 PII-Scope 的研究,讨论预训练大模型中的训练数据隐私泄露;本次发布的 PII-SCOPE 则是面向 PII 抽取的 Synthetic Context and Ontology for PII Extraction。两者研究对象和数据集并不相同,后续论文、产品文档和搜索结果很容易混淆。
278M 到底算不算轻量
**278M 参数属于可本地部署的小型编码器,但还不是可以忽略资源成本的“微型模型”。**如果仅按权重粗略计算,FP32 参数约占 1.11GB,FP16 或 BF16 约占 556MB,INT8 量化后理论参数体积约为 278MB;实际运行还需要 tokenizer、计算图、中间激活和批处理缓存。
这意味着它有机会在普通服务器、工作站和部分高配置终端上运行,而不需要为每次隐私扫描调用大型生成模型。对于日志流、邮件摄取和 RAG 文档导入这类高频任务,稳定的编码器推理通常也比自回归生成更容易控制延迟和吞吐。
参数量不能直接等同于速度。输入长度、批大小、推理框架、量化精度和硬件都会影响实际性能,而 RoBERTa 的自注意力计算量会随序列长度近似按平方增长。企业处理几十页合同或长病历时,仍然需要合理分块,并处理跨块实体被截断的问题。
与近期公开的 **OpenAI Privacy Filter(OPF)**相比,Protegrity-PII 的总参数量更小。OPF 被描述为一个 1.5B 参数的混合专家模型,Protegrity-PII 的 278M 约为其总参数量的 18.5%,或者说前者在总参数口径上约大 5.4 倍。但混合专家模型每次只激活部分参数,因此这组数字不能直接推导出 5.4 倍的延迟或显存差距。
| 方案 | 规模或架构 | 核心能力 | 获取成本 | 更适合的场景 | 主要短板 | |---|---:|---|---|---|---| | Protegrity-PII | 278M,RoBERTa 编码器 | 上下文 PII 分类、span 索引、类型输出、文本遮盖 | 权重公开,无按次官方调用价格;需承担本地算力与运维 | 日志、RAG 摄取、请求入口、批量文档扫描 | 合成数据泛化与多语言效果仍需独立验证 | | OpenAI Privacy Filter | 1.5B,混合专家模型 | 通用 PII token 分类与隐私过滤 | 开放模型,自托管成本取决于硬件 | 需要更强通用表征、可进一步领域微调的团队 | 总参数更多,真实行业数据仍决定最终效果 | | Microsoft Presidio 类方案 | 规则、校验器与 NER 组件组合 | 实体识别、规则编排、匿名化与替换 | 软件本身可本地部署,集成和规则维护产生成本 | 对审计、可解释规则和多组件编排要求高的企业 | 部署复杂,效果取决于识别器与规则覆盖 | | 纯正则表达式 | 无模型参数 | 匹配固定格式的电话、邮箱、证件号 | 计算成本最低 | 格式稳定、类别少、强调可解释性的流水线 | 不理解上下文,误报和漏报都可能很高 |
这张表也说明,278M 模型不会自动淘汰规则系统。生产级方案更可能采用混合架构:正则和校验码负责高确定性的银行卡号、邮箱或证件格式,模型负责姓名、地址、医疗信息等依赖上下文的实体,业务规则再决定遮盖、标记、阻断还是人工复核。
真正重要的指标不是准确率,而是漏掉了谁
**PII 模型的核心指标应至少包括精确率、召回率、F1、实体边界准确率和误遮盖比例。**单一“准确率”在这个任务里意义有限,因为一篇文档中绝大多数字符都不是 PII;即使模型什么都不标,也可能得到看似很高的字符级准确率。
召回率决定系统漏掉多少真实隐私,精确率则决定它会不会把正常业务内容大量删掉。医疗和金融系统通常更怕漏报,但如果模型把药名、交易编号和产品型号频繁遮掉,下游摘要、检索和风控模型就会失去关键信息,工程团队最终可能被迫关闭过滤器。
span 边界同样会直接影响安全。例如原文是“张三,手机号 13800138000”,模型如果只识别 1380013,从实体级统计看可能算作部分命中,从实际泄露角度看却仍留下可识别号码。因此,评估报告需要同时给出严格实体匹配和字符重叠结果,不能只展示宽松口径的分数。
当前公开材料强调了模型与 PII-SCOPE 的设计,但没有在给定资料中提供一组足以横向核验的完整统一跑分。与其补写未经确认的“领先百分比”,更稳妥的判断是:278M 的体积优势已经成立,效果优势则要等待第三方在同一数据、同一标签映射和同一后处理规则下复现。
轻量化最有价值的地方,是让数据不必先离开本地
**本地 PII 检测的最大价值是缩小敏感数据的暴露面,而不仅是节省推理费用。**如果企业为了判断文本中有没有身份证号,先把原始文本发送到另一个远端系统,那么隐私过滤本身就可能新增数据流转、驻留和审计问题。
278M 编码器更适合部署在数据源附近。客服对话可以在进入日志平台前扫描,PDF 可以在写入向量数据库前脱敏,用户提示词可以在发送给大模型前替换敏感实体,模型输出也可以在返回前再次检查。
RAG 摄取阶段尤其不能省略脱敏。PII 一旦进入向量数据库,就会存在于原始分块、向量元数据、备份和检索缓存中;只在最终提问时遮盖,无法消除已经进入索引的隐私副本。更合理的流程是“原始文档受控保存—摄取时识别—以类型占位符替换—建立脱敏索引—按权限回填”。
类型化替换也优于无差别删除。把“请联系王女士,电话 138……”变成“请联系 [PERSON_1],电话 [PHONE_1]”,仍然保留人物与电话号码之间的关系;如果全部替换成同一个 [REDACTED],摘要模型和客服助手会失去指代信息。
对中文用户来说,最大问号仍是语言覆盖
**中文 PII 检测不能直接由英文或西方格式基准推导效果。**中文姓名没有空格边界,地址可以从省市一路延伸到楼栋房间,身份证号码包含日期与校验位,手机号、微信号和企业内部工号也常与普通数字混在一起。
多语言模型还必须理解地区法规中的类别差异。中国语境中的身份证号、统一社会信用代码、车牌号、快递单号和详细住址,与美国常见的社会安全号码、州缩写和 ZIP Code 并不等价。模型是否覆盖中文、覆盖哪些地区格式、训练样本比例如何,需要以模型卡和本地测试为准。
企业不应把公开 checkpoint 直接设为自动删除开关。更稳妥的上线方式是先收集经过授权和匿名化的内部评估集,按实体类别分别计算召回率与精确率,再设置灰度策略:高置信度实体自动遮盖,中等置信度实体进入规则复核,低置信度结果只记录告警。
结论:方向正确,但还不是一键合规
**Protegrity-PII 证明了 PII 识别不一定需要依赖数十亿参数的生成模型。**278M 参数、上下文分类、span 输出和可直接生成遮盖文本,使它具备成为企业数据管道基础组件的条件,尤其适合要求本地处理、低延迟和高调用频率的场景。
PII-SCOPE 也击中了行业痛点:公开隐私数据难以获得,现有合成集又常有模板泄漏和类型体系不一致的问题。一个更系统的合成基准有助于推动可复现评估,但它必须接受真实数据、跨生成器数据和跨行业数据的外部检验。
这次发布最合理的定位不是“完整隐私解决方案”,而是一块更轻、更容易部署的检测底座。真正可用的 PII 系统仍需要规则校验、领域微调、权限控制、审计记录、数据保留策略和人工复核;模型可以找出疑似隐私,却不能替企业回答哪些数据允许处理、应保存多久以及谁有权恢复原文。
参考来源
- Reddit:A new, open-weights 278M PII detection model and reference benchmark:发布者对 278M 模型、12 亿条合成训练样本及 PII-SCOPE 基准的介绍。
- Hugging Face:Protegrity/protegrity-pii:Protegrity-PII 官方模型卡与权重页面,可核对模型说明、文件和使用条件。